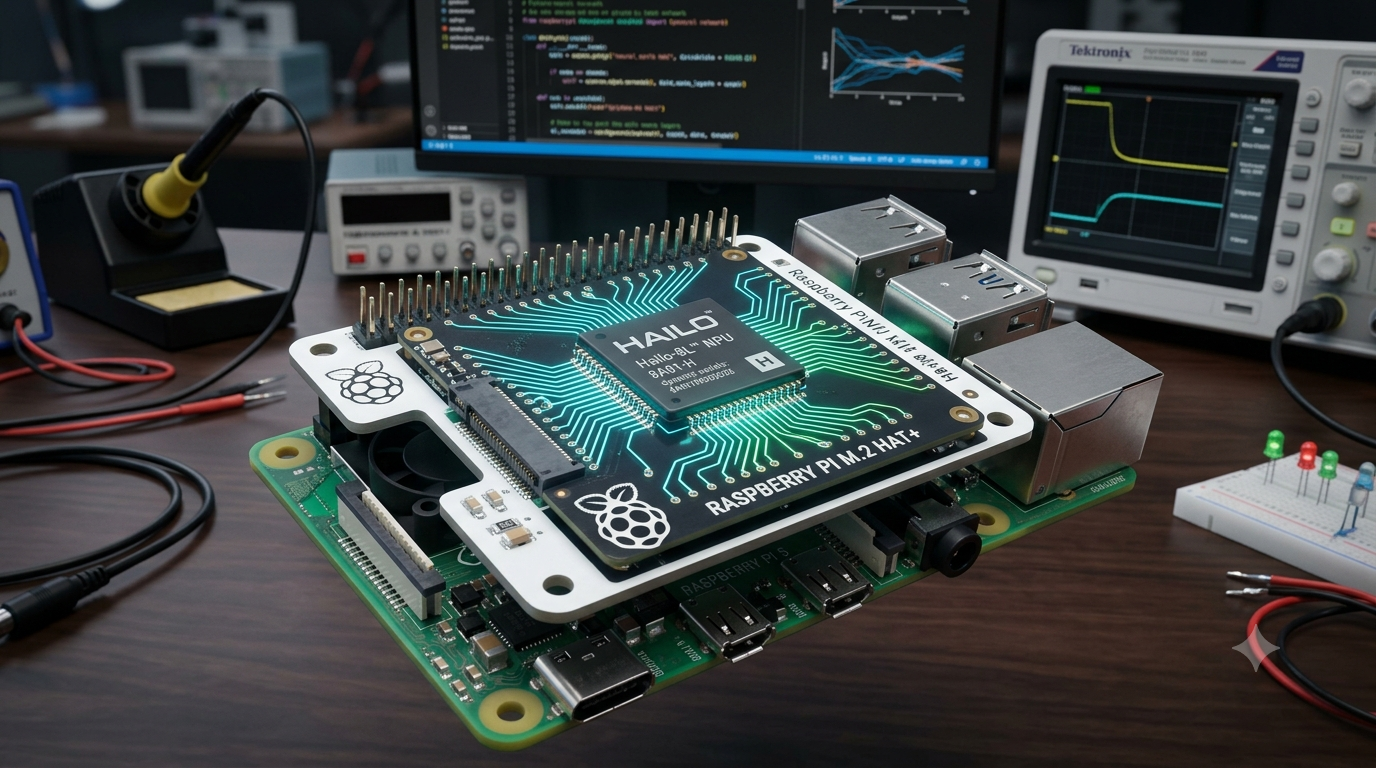
Durante años, si querías desplegar un modelo de visión por computador en un proyecto con Raspberry Pi para detectar objetos, rastrear personas o analizar vídeo en tiempo real, tenías básicamente dos opciones. La primera era resignarte a ver cómo la CPU de la plaquita echaba humo para procesar tristes 2 o 3 fotogramas por segundo. La segunda era delegar el procesamiento a la nube a través de una API REST, añadiendo latencia, factura mensual de ancho de banda y una dependencia absoluta de internet.
Por suerte, los días de freír procesadores para reconocer a tu gato en el jardín han llegado a su fin. La Fundación Raspberry Pi se ha aliado con la firma de semiconductores Hailo para lanzar el Raspberry Pi AI Kit: un módulo M.2 HAT+ que integra el acelerador Hailo-8L, capaz de desbloquear 13 TOPS (Tera Operaciones Por Segundo) de potencia de inferencia dedicada.
En este análisis vamos a destripar qué significa técnicamente este kit, cómo cambia las reglas del juego para la inteligencia artificial en el edge y por qué es un salto cuantitativo para los desarrolladores.
El cuello de botella del procesamiento en el «Edge»
Para entender la magnitud del avance, repasemos la arquitectura de procesamiento tradicional. Las Unidades Centrales de Procesamiento (CPU) de arquitecturas ARM, como el Broadcom BCM2712 integrado en la Raspberry Pi 5, destacan en ejecutar código secuencial, gestionar hilos del sistema operativo y resolver tareas generales. Sin embargo, las redes neuronales convolucionales (CNN) y los modelos de visión artificial requieren multiplicar matrices masivas en paralelo de forma incesante.
Cuando ejecutas una red como YOLOv8 o MobileNet directamente en la CPU mediante librerías como TensorFlow Lite o ONNX Runtime, la arquitectura sufre dos grandes limitaciones:
- Estrangulamiento térmico (Thermal Throttling): La CPU satura sus cuatro núcleos ARM Cortex-A76 al 100%, elevando la temperatura de forma drástica en cuestión de segundos.
- Saturación de la memoria RAM: La transferencia constante de tensores pesados a la memoria RAM compartida frena el resto de procesos del sistema.
La solución obvia pasaba por utilizar procesadores dedicados o GPUs aceleradoras, pero hasta ahora las alternativas del mercado eran o demasiado caras, o propietarias con stacks de software desatendidos, o requerían un consumo energético inviable para sistemas embebidos.
La arquitectura Hailo-8L: Matemáticas a medida para redes neuronales
El corazón del Raspberry Pi AI Kit es el coprocesador de IA Hailo-8L, una versión optimizada de la NPU (Unidad de Procesamiento Neural) industrial de Hailo. Este chip no funciona como una GPU tradicional que calcula gráficos, sino como una estructura de silicio diseñada exclusivamente para acelerar las capas de inferencia en modelos de Deep Learning.
+-------------------------------------------------------------------+
|                        Raspberry Pi 5                             |
|                                                                   |
|   +--------------------+               +----------------------+   |
|   | CPU BCM2712        |  PCIe 2.0 x1  | Raspberry Pi AI Kit  |   |
|   | (4x ARM A76)       | ------------> | (Chip Hailo-8L)      |   |
|   | Gestión de S.O.    |               | 13 TOPS de Inferencia|   |
|   +--------------------+               +----------------------+   |
+-------------------------------------------------------------------+
Su secreto reside en su arquitectura de «flujo de datos de estructura variable». En lugar de leer instrucciones repetitivas desde la memoria interna, las capas del modelo neuronal se mapean geométricamente sobre la propia matriz del chip. Los datos de la imagen fluyen directamente a través de los bloques de cálculo, reduciendo drásticamente la latencia y maximizando la eficiencia energética.
| Especificación Técnica | Detalle |
|---|---|
| Acelerador de IA | Hailo-8L NPU |
| Rendimiento | 13 TOPS (INT8) |
| Interfaz de Bus | PCIe 2.0 x1 (a través del conector M.2 HAT+) |
| Formato M.2 | M.2 2240 / 2280 Key M |
| Consumo Térmico | ~1.5W a 2.5W bajo carga sostenida |
| Compatibilidad | Exclusiva para Raspberry Pi 5 |
Gracias a la integración del bus PCIe 2.0 x1 de la Raspberry Pi 5, la transferencia de datos entre la memoria principal del sistema y la NPU alcanza anchos de banda cercanos a los 500 MB/s. Esto elimina los habituales embotellamientos que sufrían los viejos aceleradores USB 2.0/3.0.
Integración directa con el ecosistema libcamera y picamera2
Una de las grandes sorpresas de este kit no es solo la potencia de su hardware, sino la elegancia con la que han integrado el software. En lugar de obligar al programador a escribir capas complejas de bindings en C++, el equipo de ingeniería de Raspberry Pi ha integrado el runtime de Hailo directamente dentro de la pila multimedia oficial del sistema operativo (Raspberry Pi OS).
A través del pipeline de libcamera y la librería Python picamera2, la captura de fotogramas del sensor de la cámara pasa de forma transparente por la NPU antes de renderizarse en pantalla.
Por ejemplo, con solo unas pocas líneas de código en Python podemos cargar un modelo de estimación de poses humanas o detección de objetos:
import picamera2
from picamera2.devices import HailoNN

# Inicializamos la cámara con la tubería de la NPU activa
picam2 = picamera2.Picamera2()
hailo_config = HailoNN(model="yolov8s.hef")

picam2.start_preview()
picam2.start_post_processing(hailo_config)

print("Inferencia en tiempo real lista a 30 FPS...")
¿El resultado práctico? Mientras un modelo de visión como YOLOv8s procesa vídeo en calidad Full HD a 30 fotogramas por segundo sostenidos, la CPU de la Raspberry Pi 5 permanece prácticamente en reposo, rondando apenas un 10% o 15% de uso. Esto deja margen de cómputo de sobra para ejecutar servidores web, bases de datos locales o algoritmos de control robótico de forma paralela.
Cómputo ético, privado y local: El verdadero valor en el Edge
Más allá de las métricas puras de benchmarks e inferencia por segundo, este tipo de hardware sienta un precedente crucial para la soberanía de los datos. Procesar algoritmos de visión por computador directamente en el dispositivo físico (on-device AI) aporta ventajas estratégicas fundamentales:
- Privacidad garantizada: No es necesario transmitir transmisiones de vídeo de cámaras de seguridad o monitores industriales hacia servidores de terceros.
- Latencia determinista: Al no depender de la conexión de red ni de servidores distantes, los tiempos de respuesta se mantienen estables en el orden de los milisegundos, algo crítico para aplicaciones en robótica o automatización.
- Tolerancia a fallos: El sistema sigue operando exactamente igual si la red local se cae por completo.
¿Has integrado ya algún acelerador de IA en tus proyectos de electrónica o controladores embebidos? ¿Qué uso le darías a estos 13 TOPS de potencia en tu servidor casero? Te leo abajo en los comentarios.
Deja una respuesta