Existe un dilema clásico en el despliegue de sistemas inteligentes: ¿cómo llevamos visión artificial en tiempo real a una línea de producción, un campo de cultivo o un sensor remoto sin arruinarnos en el intento? Durante años, la respuesta estándar era montar un ordenador industrial con una GPU dedicada o transmitir el flujo de vídeo a un servidor en la nube.
¿El resultado? Facturas de infraestructura por las nubes, latencias impredecibles cuando falla la red y un consumo eléctrico que requiere estar enchufado a la red de alta tensión. Pero la informática siempre encuentra formas elegantes de romper sus propios límites.
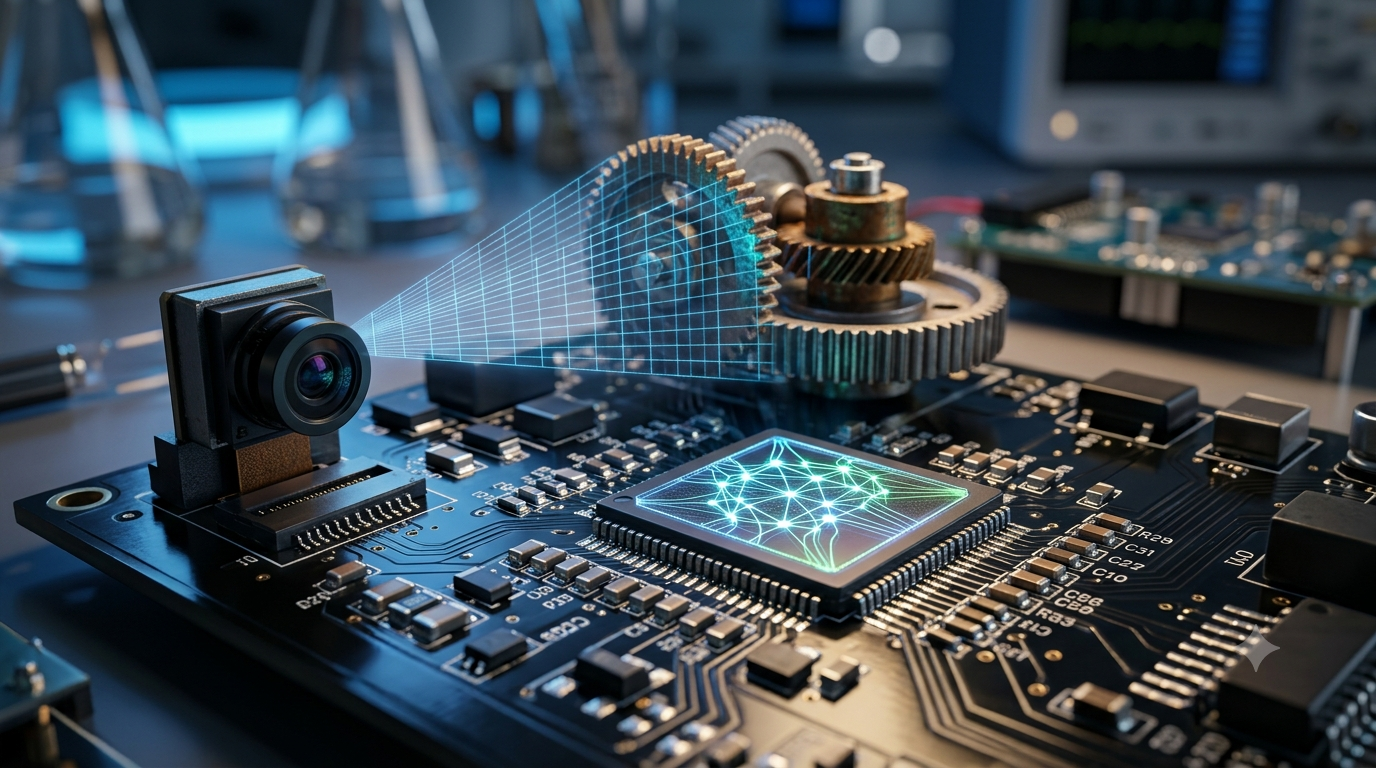
+------------------+      +--------------------+      +-----------------------+
|  Cámara local    | ---> |  Microcontrolador  | ---> |  Detección instantánea |
|  (Sensor CMOS)   |      |  (NPU Integrada)   |      |  (Fallo detectado)    |
+------------------+      +--------------------+      +-----------------------+
                            Sin Cloud / Latencia < 5ms
El cuello de botella de la computación centralizada
El problema de fondo no es la precisión de los modelos de visión, sino dónde y cómo se ejecuta la inferencia. En entornos industriales, procesar 60 fotogramas por segundo a través de una API REST es una receta para el desastre. Si el enlace de fibra tiene un pico de latencia de 200 milisegundos, una pieza defectuosa ya habrá pasado de largo por la cinta de montaje.
Por otro lado, montar un clúster de GPUs en la propia planta implica un mantenimiento físico, sistemas de refrigeración activa y un consumo continuo que penaliza la eficiencia energética. Aquí es donde entra la filosofía del Edge Computing llevada al extremo: TinyML.
(más…)