Etiqueta: open source

  • ¿El «systemd» de la Inteligencia Artificial? El debate que agita el kernel de Linux

    ¿El «systemd» de la Inteligencia Artificial? El debate que agita el kernel de Linux

    El software libre vuelve a vivir uno de esos momentos bisagra que marcan época. Si tienes una edad informática respetable o si simplemente peinas canas en el ecosistema Linux, recordarás perfectamente las acaloradas discusiones que incendiaron foros, listas de correo y chats de IRC cuando systemd llegó para jubilar al clásico SysVinit. Aquello no fue un simple cambio de software; fue un debate filosófico sobre la modularidad, la simplicidad del sistema y hasta dónde debía extenderse la responsabilidad de un gestor de procesos central.

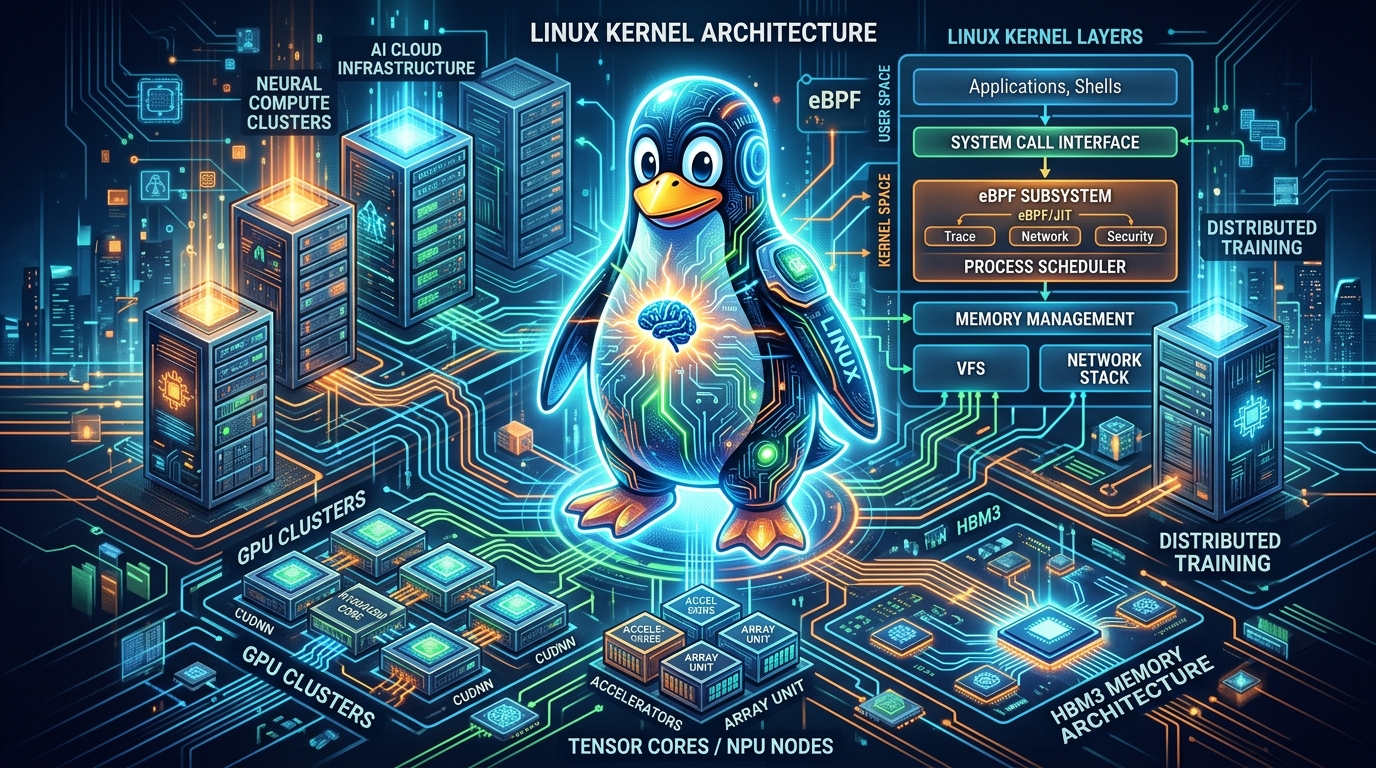
    Pues bien, agárrate al teclado porque la historia se repite. Un conjunto de desarrolladores y arquitectos de sistemas ha puesto sobre la mesa una propuesta tan ambiciosa como polémica: crear una capa de abstracción unificada en el espacio de usuario dentro de Linux para gestionar los recursos de aceleración de Inteligencia Artificial. Sí, algo así como un «systemd para el kernel de IA». Y, como era de esperar, la comunidad ya ha sacado los destornilladores técnicos y las pancartas filosóficas.

    (más…)
  • El bug que se arregló solo: así funcionan los agentes open-source que envían Pull Requests de forma autónoma

    El bug que se arregló solo: así funcionan los agentes open-source que envían Pull Requests de forma autónoma

    Imagina que tu sistema de integración continua rompe un viernes a las cinco de la tarde. Un test unitario falla estrepitosamente en una tubería de CI/CD. Antes de que tengas tiempo de cancelar tus planes, tu servidor Git recibe de forma automática un Pull Request: el error ha sido clonado en un entorno aislado, reproducido, corregido y validado con tests unitarios pasando en verde. La pregunta ya no es si la Inteligencia Artificial puede escribir código, sino si estamos preparados para delegarle la guardia técnica y el mantenimiento de nuestros repositorios.

    (más…)
  • El kit oficial de IA para Raspberry Pi 5: 13 TOPS de potencia local por menos de lo que piensas

    El kit oficial de IA para Raspberry Pi 5: 13 TOPS de potencia local por menos de lo que piensas

    Durante años, si querías desplegar un modelo de visión por computador en un proyecto con Raspberry Pi para detectar objetos, rastrear personas o analizar vídeo en tiempo real, tenías básicamente dos opciones. La primera era resignarte a ver cómo la CPU de la plaquita echaba humo para procesar tristes 2 o 3 fotogramas por segundo. La segunda era delegar el procesamiento a la nube a través de una API REST, añadiendo latencia, factura mensual de ancho de banda y una dependencia absoluta de internet.

    Por suerte, los días de freír procesadores para reconocer a tu gato en el jardín han llegado a su fin. La Fundación Raspberry Pi se ha aliado con la firma de semiconductores Hailo para lanzar el Raspberry Pi AI Kit: un módulo M.2 HAT+ que integra el acelerador Hailo-8L, capaz de desbloquear 13 TOPS (Tera Operaciones Por Segundo) de potencia de inferencia dedicada.

    En este análisis vamos a destripar qué significa técnicamente este kit, cómo cambia las reglas del juego para la inteligencia artificial en el edge y por qué es un salto cuantitativo para los desarrolladores.

    (más…)
  • El día que Linux se volvió en tiempo real: Por qué la llegada de PREEMPT_RT al kernel 6.12 lo cambia todo

    El día que Linux se volvió en tiempo real: Por qué la llegada de PREEMPT_RT al kernel 6.12 lo cambia todo

    Si llevas unos cuantos años en el mundo de la informática, probablemente hayas escuchado la frase: «Linux no es un sistema operativo en tiempo real». Y durante más de tres décadas, la afirmación era completamente cierta. Podías usar Linux para mover servidores web masivos, renderizar películas en 3D o hacer funcionar supercomputadores, pero si intentabas controlar el sistema de frenos ABS de un coche o el brazo de un robot cirujano, corrías el riesgo de que una simple interrupción del sistema provocara un desastre.

    Hoy, esa limitación ha pasado oficialmente a la historia.

    Tras más de 20 años de desarrollo continuo, parches externos y acalorados debates en las listas de correo de los desarrolladores del kernel, el parche PREEMPT_RT (Real-Time Preemption) ha quedado integrado de forma nativa e incondicional en la rama principal (mainline) del kernel de Linux, a partir de la versión 6.12.

    (más…)
  • La gran fuga de las nubes propietarias: por qué el código abierto es la vacuna definitiva contra el ‘Vendor Lock-In’ en la era de la IA

    La gran fuga de las nubes propietarias: por qué el código abierto es la vacuna definitiva contra el ‘Vendor Lock-In’ en la era de la IA

    Imagina la siguiente escena: has diseñado la arquitectura de software de tu vida. Todo encaja a la perfección, las peticiones fluyen con la suavidad de un buen algoritmo de ordenación y el negocio escala sin pestañear. Pero, de repente, una mañana te llega un correo electrónico de tu proveedor de servicios en la nube favorito con un asunto aséptico: «Actualización en nuestros términos de servicio y tarifas». Al abrirlo, el café se te atraganta. Las API propietarias de las que depende toda tu lógica de negocio han duplicado su coste de inferencia paralela y, para colmo, han descatalogado la versión del modelo de lenguaje que alimentaba tus agentes autónomos. Intentas buscar alternativas y te das cuenta de la cruda realidad: tu código está tan acoplado a sus servicios que migrar a otro ecosistema te costaría meses de refactorización, miles de horas de desarrollo y un dolor de cabeza de proporciones épicas. Estás atrapado. Has caído en las garras del temido vendor lock-in.

    Esta pesadilla técnica no es una hipótesis de ciencia ficción para asustar a los programadores novatos en Halloween; es la realidad diaria a la que se enfrentan miles de CTOs e ingenieros de sistemas en todo el mundo. Durante la última década, la comodidad del «pago por uso» de las grandes plataformas propietarias nos hizo bajar la guardia, delegando la infraestructura crítica en manos de unos pocos gigantes tecnológicos que ahora controlan las llaves del reino digital.

    (más…)
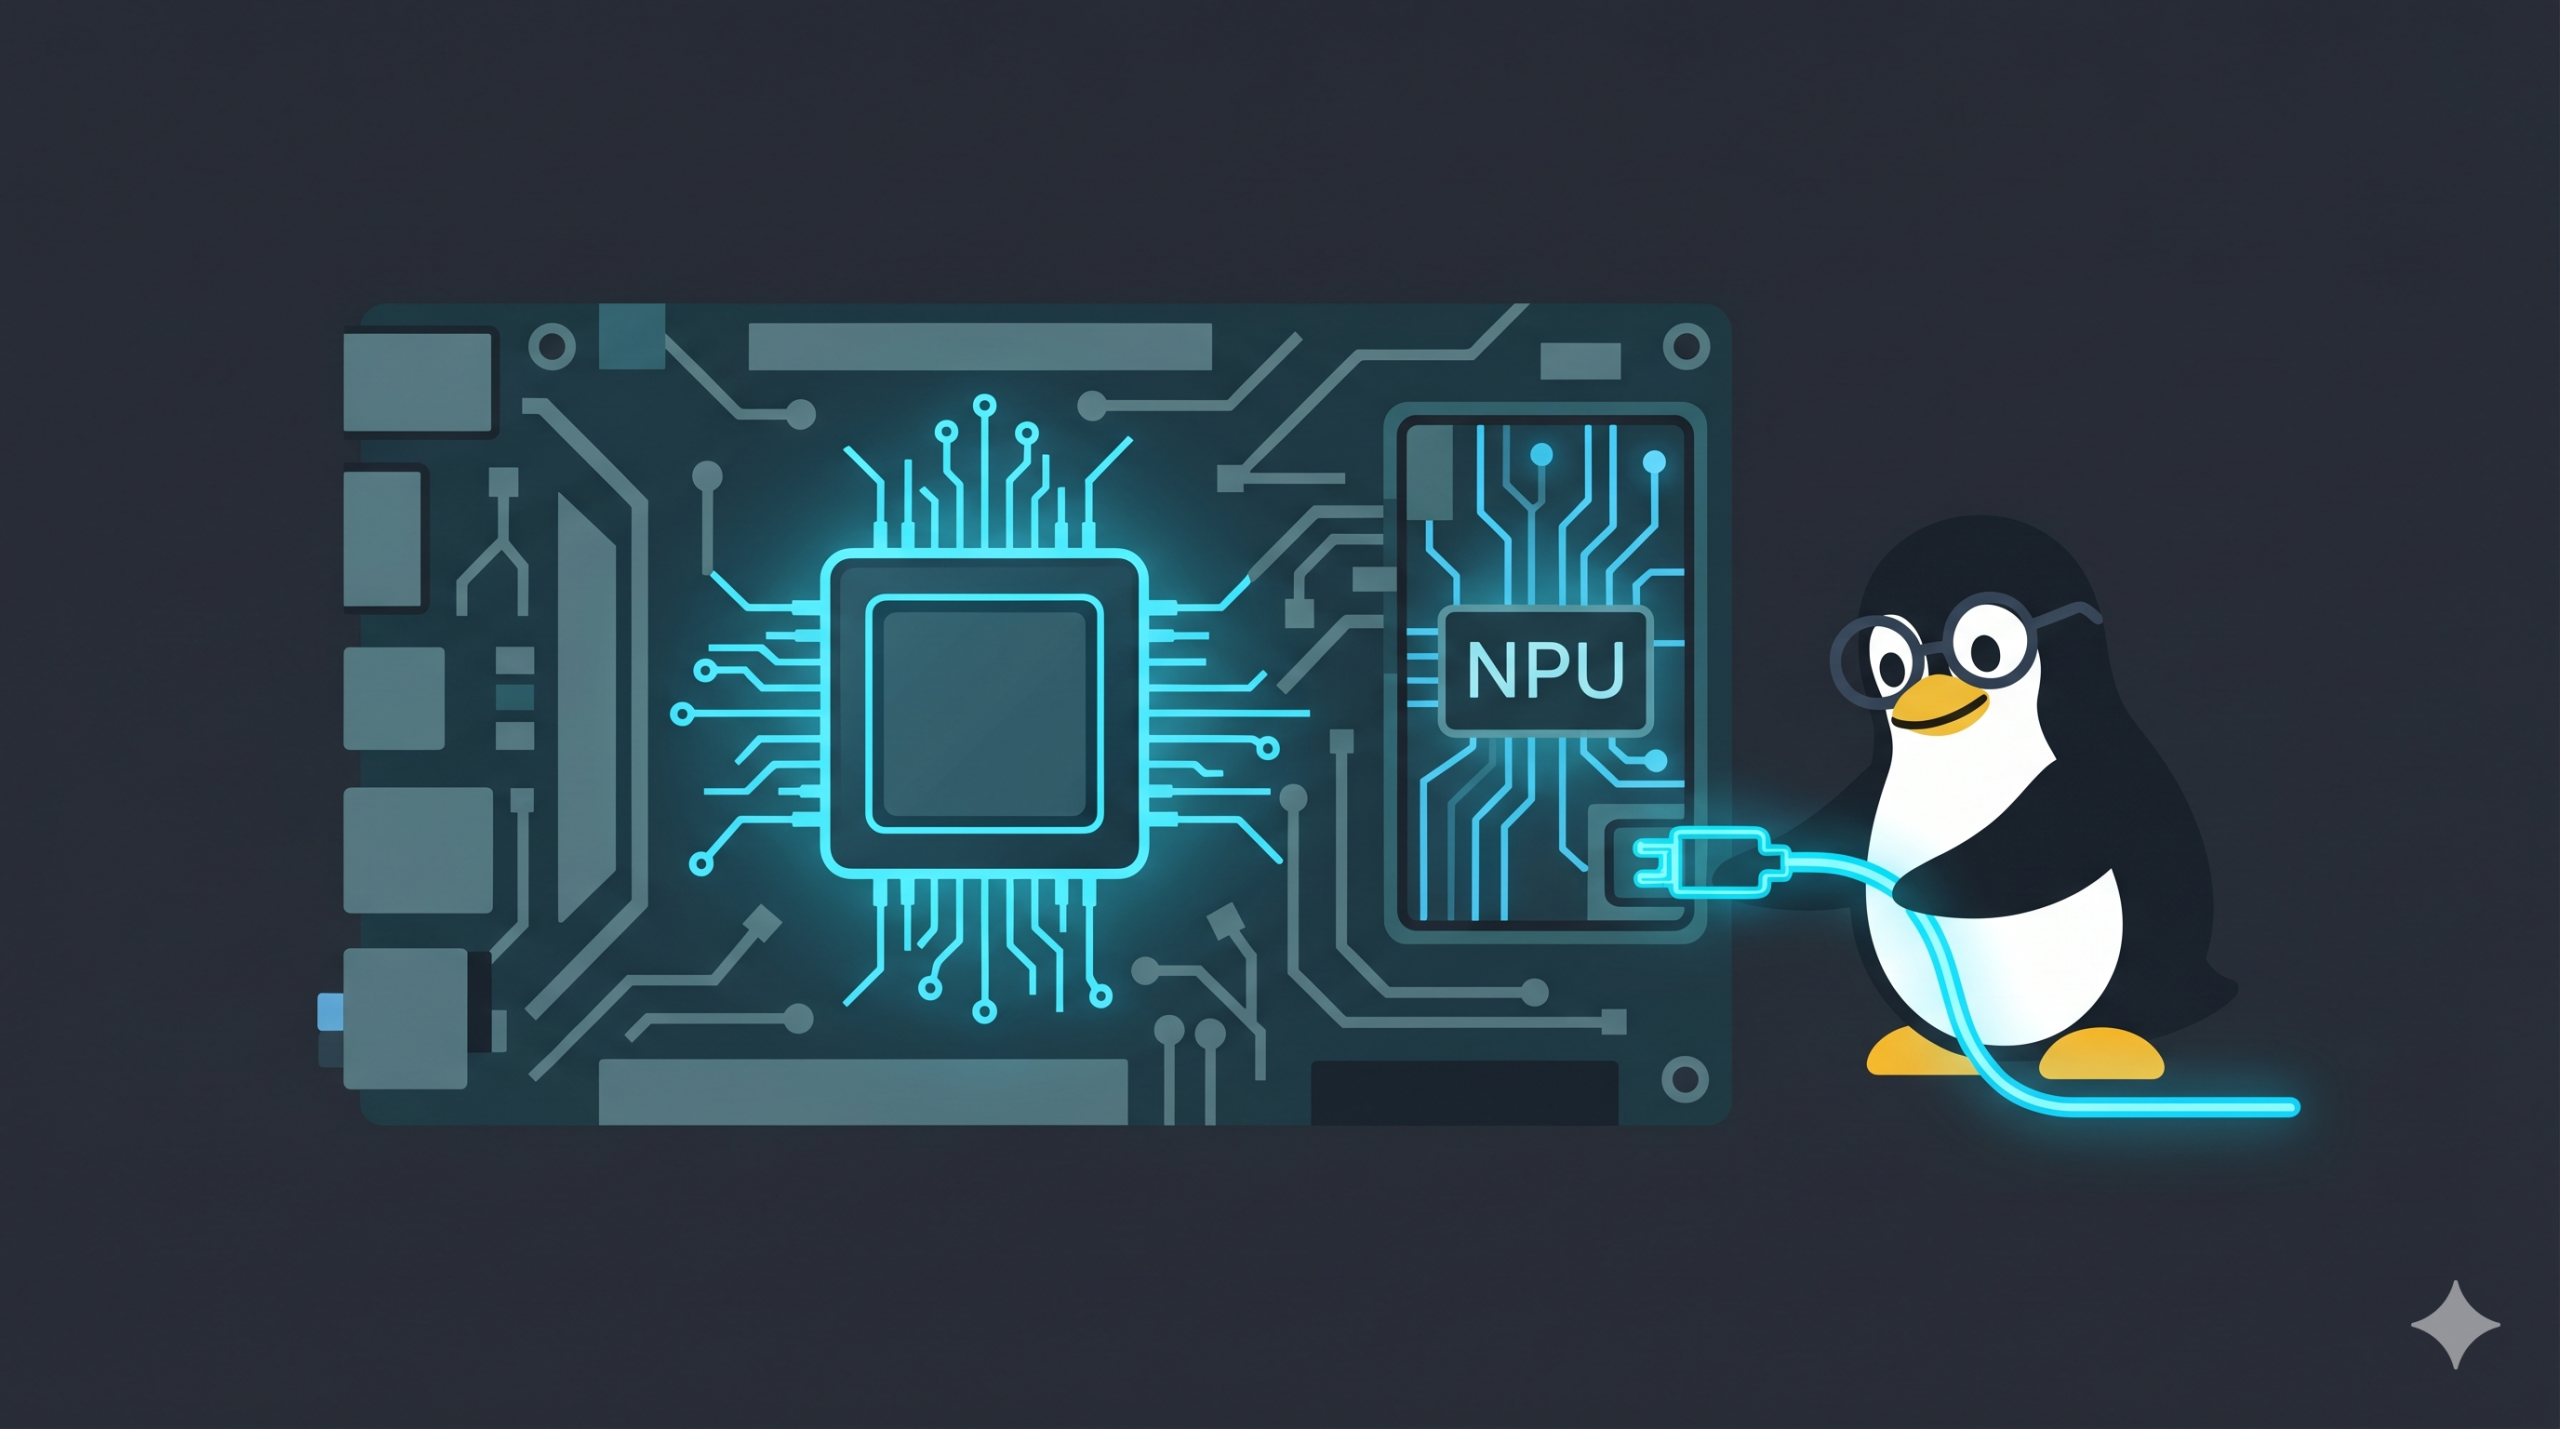
  • El Kernel de Linux abre las puertas a las NPU: IA local, libre y sin peajes propietarios

    El Kernel de Linux abre las puertas a las NPU: IA local, libre y sin peajes propietarios

    Imaginen la escena: compran un procesador de última hornada, de esos que presumen de llevar un «motor de IA» revolucionario integrado en el silicio, listos para ejecutar vuestros modelos de lenguaje locales a la velocidad del rayo. Formatean, instalan su distribución Linux favorita y… ¡pum! El sistema ni se inmuta. Ese flamante coprocesador neural se queda tan frío como un bloque de hielo porque el sistema operativo no tiene ni la más remota idea de cómo hablarle. Durante los últimos meses, tener una NPU (Neural Processing Unit) en un entorno GNU/Linux era, para muchos, tener un pisapapeles de silicio muy caro, o bien depender de binarios propietarios y módulos opacos de kernel que dinamitaban cualquier principio de soberanía digital.

    Por suerte, en el ecosistema del pingüino las cosas no se quedan paradas por mucho tiempo. Las últimas versiones del Kernel de Linux han empezado a integrar de forma oficial y nativa controladores de código abierto para las NPU de los principales fabricantes del mercado (Intel, AMD y Qualcomm). No estamos hablando de un parche menor; se trata de una reestructuración estratégica de la infraestructura del kernel para tratar a la inferencia de inteligencia artificial como un ciudadano de primera clase, al mismo nivel que los gráficos por computación o el almacenamiento en disco. Esta actualización silenciosa pero masiva promete cambiar las reglas del juego de la Edge AI y el desarrollo de software local.

    (más…)
  • PHP 8.4 y los Property Hooks: El fin de la era de los Getters y Setters infinitos

    PHP 8.4 y los Property Hooks: El fin de la era de los Getters y Setters infinitos

    Si llevas unos cuantos años picando código en el ecosistema web, seguro que tu editor de texto ha echado humo más de una vez generando métodos estructurales. Hablamos de esa vieja y monótona coreografía de la programación orientada a objetos: declarar una propiedad privada, crear un método para devolver su valor y diseñar otro para modificarlo. Sí, los famosos getters y setters. Esta práctica, aunque necesaria para mantener el encapsulamiento y validar los datos, a menudo transforma nuestras elegantes clases en archivos kilométricos llenos de código repetitivo (el temido boilerplate). El verdadero problema no es solo escribirlos, sino mantenerlos legibles cuando las reglas de negocio cambian.

    (más…)
  • El declive del commit tradicional: Por qué Git abraza los metadatos semánticos nativos

    El declive del commit tradicional: Por qué Git abraza los metadatos semánticos nativos

    Admitámoslo en la intimidad de nuestro entorno de desarrollo: escribir mensajes de commit es, para la mayoría de los programadores, una de las tareas más tediosas del universo. Todos hemos comenzado el día con un pulcro y académico feat(auth): implement OAuth2 token refresh architecture, para terminar a las tres de la mañana enviando un desesperado fix: por favor funciona ya o el clásico asdasdasd. Este factor humano introduce caos en los historiales de versiones, rompe las herramientas de automatización y drena energía mental.

    (más…)
  • Arqueología del Bit: Cómo los «Cementerios de Código» están Salvando el Pasado (y el Futuro) de la Informática

    Arqueología del Bit: Cómo los «Cementerios de Código» están Salvando el Pasado (y el Futuro) de la Informática

    ¿Alguna vez te has preguntado qué pasa con el código fuente de las plataformas que definieron nuestra vida digital hace veinte o treinta años? En el vertiginoso mundo del software, lo que hoy es revolucionario mañana es considerado un «fósil». Tendemos a pensar que internet es eterno, pero la realidad es mucho más frágil: páginas web enteras, foros míticos y plataformas pioneras de los años 90 y principios de los 2000 desaparecen cada día sin dejar rastro debido a servidores apagados, quiebras comerciales o discos duros que acaban en el contenedor.

    Este fenómeno ha dado lugar a una nueva y fascinante disciplina dentro de la informática: la arqueología digital y la gestión de los llamados «cementerios de código». No se trata de un simple ataque de nostalgia masiva o de un diógenes digital; es un movimiento global y estratégico. Universidades, bibliotecarios digitales e instituciones internacionales (como la UNESCO a través de la iniciativa Software Heritage) se están aliando para rescatar, catalogar y resucitar repositorios archivados. ¿El objetivo? Salvar la historia de la computación y, de paso, enseñarnos a programar mejor en el presente.

    (más…)
  • Microsoft Azure Linux 4.0: Cuando el pingüino se viste de gala para dominar los clústeres de IA

    Microsoft Azure Linux 4.0: Cuando el pingüino se viste de gala para dominar los clústeres de IA

    ¿Quién te ha visto y quién te ve, Redmond? Si a cualquiera de nosotros nos dicen hace quince años que Microsoft iba a presentar a bombo y platillo la versión 4.0 de su propia distribución de Linux en la Open Source Summit, habríamos revisado si nos habían echado algo en el café. Pero el software libre no entiende de rencores, y el mercado de la Inteligencia Artificial generativa menos aún.

    (más…)