El software libre vuelve a vivir uno de esos momentos bisagra que marcan época. Si tienes una edad informática respetable o si simplemente peinas canas en el ecosistema Linux, recordarás perfectamente las acaloradas discusiones que incendiaron foros, listas de correo y chats de IRC cuando systemd llegó para jubilar al clásico SysVinit. Aquello no fue un simple cambio de software; fue un debate filosófico sobre la modularidad, la simplicidad del sistema y hasta dónde debía extenderse la responsabilidad de un gestor de procesos central.
Pues bien, agárrate al teclado porque la historia se repite. Un conjunto de desarrolladores y arquitectos de sistemas ha puesto sobre la mesa una propuesta tan ambiciosa como polémica: crear una capa de abstracción unificada en el espacio de usuario dentro de Linux para gestionar los recursos de aceleración de Inteligencia Artificial. Sí, algo así como un «systemd para el kernel de IA». Y, como era de esperar, la comunidad ya ha sacado los destornilladores técnicos y las pancartas filosóficas.
El cuello de botella invisible: la torre de Babel de los aceleradores
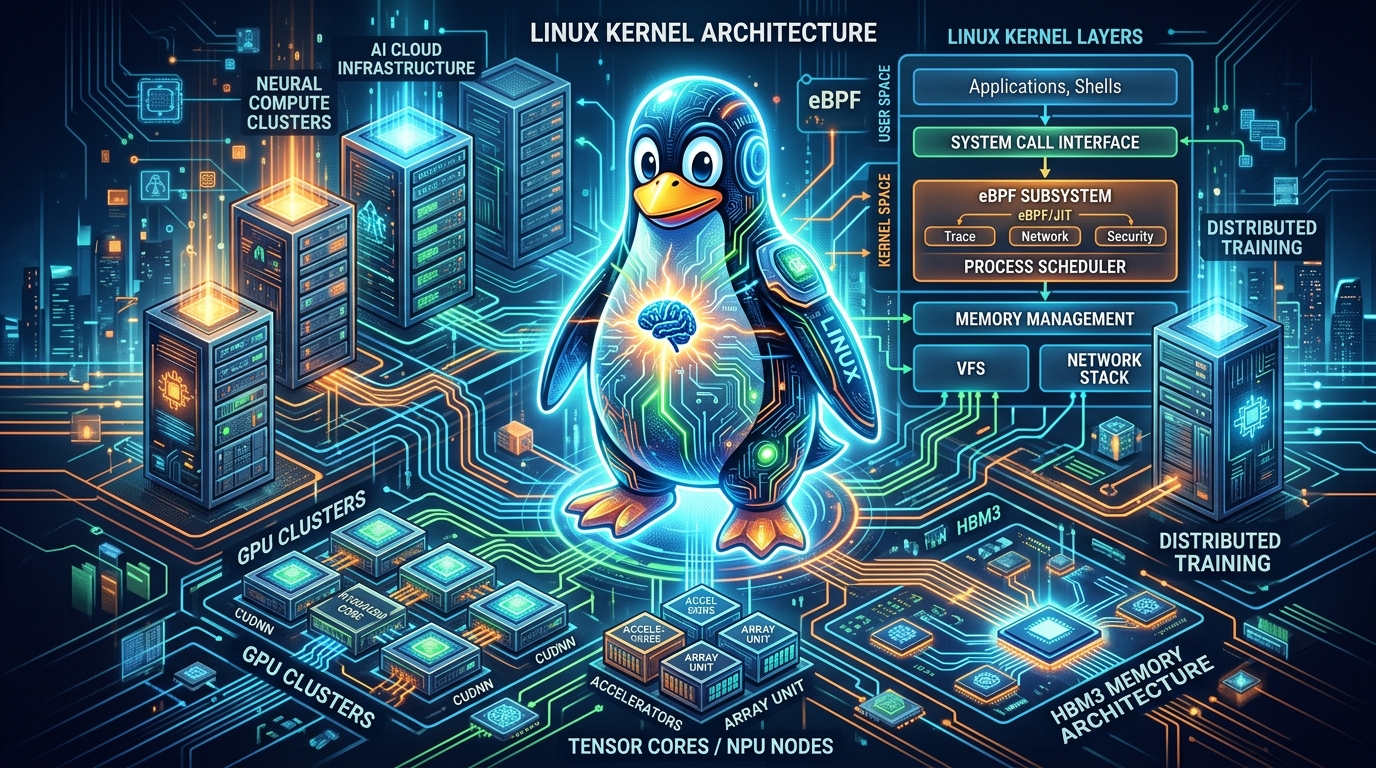
Para entender qué problema pretende resolver este movimiento, primero debemos mirar qué está pasando bajo el capó de un servidor moderno dedicado a cómputo intensivo o inferencia paralela. Hoy en día, entrenar o ejecutar un modelo de lenguaje amplio no es simplemente cuestión de escribir código limpio en Python y llamar a PyTorch. El rendimiento real depende de una jungla heterogénea de aceleradores hardware: desde clústeres GPU de Nvidia o AMD, pasando por unidades NPU en procesadores de consumo, hasta aceleradores ASIC personalizados en nubes públicas.
El gran dolor de cabeza radica en que cada fabricante impone su propia pila de software propietario o sus propios controladores en el kernel. Nos encontramos con una fragmentación sangrienta: llamadas a la memoria unificada inconsistentes, dinámicas de asignación de tensores que compiten agresivamente entre sí y una gestión de energía que depende de demonios propietarios en el espacio de usuario.
Cuando un administrador de sistemas o un ingeniero de infraestructura intenta coordinar varios modelos en un mismo nodo Linux, se topa con un caos organizativo. Los recursos no se reparten de forma justa, la latencia de conmutación de contextos entre procesos de IA es alta y depurar fugas de memoria en la GPU se convierte en un ejercicio de arqueología digital.
La propuesta: un orquestador estandarizado para la capa de usuario
Aquí es donde entra la propuesta controvertida. Un consorcio de ingenieros propone desarrollar un demonio centralizado y un conjunto de primitivas estandarizadas en el subsistema de Linux —apoyándose en capacidades avanzadas como eBPF (Extended Berkeley Packet Filter) y nuevas APIs en /dev/accel— para tomar el control unificado de estos aceleradores.
La idea central no es reemplazar los controladores gráficos de bajo nivel que comunican el silicio con el bus PCIe, sino proporcionar una interfaz estándar y neutra. Este servicio se encargaría de aspectos críticos como:
- Planificación y cola de tensores: Decidir qué proceso o modelo obtiene tiempo de cómputo prioritario en las NPUs o GPUs de forma justa, de manera idéntica a cómo el planificador del kernel (sched) distribuye los ciclos de reloj de la CPU.
- Aislamiento y cuotas de memoria VRAM: Evitar que un proceso descontrolado provoque un Out-Of-Memory (OOM) fatal en toda la GPU, aislando contextos de ejecución.
- Métricas y telemetría unificadas: Ofrecer una única vía de auditoría para medir consumo energético, temperatura e intensidad de cómputo, sin importar si estás usando silicio de un fabricante u otro.
Imagina que entrenar un modelo sea tan predecible para el sistema operativo como abrir un socket de red o montar un sistema de archivos. Desde el punto de vista puramente técnico y operativo, suena como música celestial para los equipos de DevOps y Maintaners de infraestructura en la nube.
La grieta filosófica: ¿eficiencia unificada o monolito gigante?
Sin embargo, como ocurre con casi cualquier innovación estructural en el software libre, la solución plantea sus propios interrogantes éticos y de diseño. Los detractores de la propuesta no han tardado en alzar la voz argumentando que estamos ante un nuevo intento de violar la filosofía Unix: «haz una sola cosa y hazla bien».
El principal temor es la creación de un monolito gigante en el espacio de usuario que acabe siendo un requisito obligatorio e indivisible para ejecutar cualquier tipo de inteligencia artificial en Linux. Si la capa de abstracción se vuelve demasiado compleja o rígida, podría ahogar la innovación de pequeños desarrolladores de hardware que busquen arquitecturas no convencionales. Además, delegar tanta lógica de orquestación a una herramienta centralizada incrementa la superficie de ataque del sistema y complica la depuración cuando algo falla a muy bajo nivel.
Por otro lado, los defensores sostienen que no hacer nada es peor. Dejar que gigantes tecnológicos dicten sus propios estándares cerrados solo fomenta el vendor lock-in (la dependencia absoluta de un proveedor de hardware). Un estándar abierto dentro del ecosistema Linux es, a su juicio, la única garantía de que la IA siga siendo accesible, auditable y verdaderamente open source.
El impacto en nuestro trabajo diario
¿Qué significa todo esto para los que programamos aplicaciones o administramos servidores en el día a día? Si esta iniciativa prospera y logra el consenso de la Linux Foundation, podríamos estar a las puertas de una verdadera democratización en el desarrollo de software impulsado por IA.
En lugar de lidiar con SDKs complejos y librerías C++ propietarias para cada tipo de acelerador, los frameworks de aprendizaje automático podrían interactuar con una API estándar del sistema operativo. Esto reduciría drásticamente el tamaño de los contenedores, aceleraría los tiempos de despliegue y permitiría que un mismo binario aproveche eficientemente la NPU de tu portátil local o el clúster GPU de un centro de datos sin tocar una sola línea de código.
El debate no ha hecho más que empezar, y las próximas conferencias de desarrolladores del kernel prometen ser intensas. La inteligencia artificial ha dejado de ser una simple carga de trabajo aplicativa para convertirse en un componente estructural de la informática moderna, y Linux necesita adaptar sus cimientos sin perder la esencia que lo hizo grande.
¿Qué opinas tú al respecto? ¿Crees que el ecosistema necesita urgentemente esta estandarización para frenar el dominio de las arquitecturas propietarias, o prefieres una gestión modular e independiente aunque suponga más trabajo de integración? Te leo en los comentarios. Si quieres curiosear más sobre la arquitectura propuesta, puedes revisar los borradores iniciales en los repositorios públicos de la comunidad.
Deja una respuesta