Etiqueta: Arquitectura de Sistemas

  • Más allá del silicio: Cómo el Kernel de Linux blinda las CPUs contra los ataques de canal lateral

    Más allá del silicio: Cómo el Kernel de Linux blinda las CPUs contra los ataques de canal lateral

    Durante años hemos vivido con la falsa sensación de que el hardware de un ordenador era un búnker inquebrantable: lo que ocurría dentro de la CPU se quedaba en la CPU. Sin embargo, la ciberseguridad moderna dio un vuelco drástico con el descubrimiento de vulnerabilidades de canal lateral como Spectre, Meltdown o ataques más recientes basados en la ejecución especulativa. El problema no residía en un fallo de código tradicional, sino en cómo los procesadores modernos optimizan la velocidad a costa de filtrar información confidencial a través del tiempo de respuesta y la caché. Ante este panorama, el núcleo de Linux ha tenido que evolucionar hasta convertirse en un escudo defensivo inteligente.

    (más…)
  • La niebla que aclara el tráfico: Cómo el ‘Fog Computing’ está salvando a las ciudades inteligentes del colapso de datos

    La niebla que aclara el tráfico: Cómo el ‘Fog Computing’ está salvando a las ciudades inteligentes del colapso de datos

    Imagina por un segundo que cada semáforo, cámara de tráfico, sensor de contaminación y farola de tu ciudad tuviera que enviar gigabytes de datos en tiempo real a un centro de datos en Fráncfort o Virginia solo para decidir si cambia de verde a rojo. El resultado no solo sería un consumo ridículo de ancho de banda, sino una latencia capaz de convertir un simple atasco en un caos circulatorio monumental. Durante años hemos vivido fascinados por la promesa de la nube, pero cuando la infraestructura salta al asfalto, enviar cada microdato al cloud se convierte en una receta para el desastre. Aquí es donde entra en juego la computación en la niebla (Fog Computing).

    (más…)
  • Del Caos Vectorial al Orden del Grafo: Por Qué Tu RAG Necesita GraphRAG

    Del Caos Vectorial al Orden del Grafo: Por Qué Tu RAG Necesita GraphRAG

    ¿Te ha pasado alguna vez que le pides a un sistema RAG (Retrieval-Augmented Generation) tradicional que te haga un resumen global de miles de documentos y acaba inventándose la mitad o ignorando conexiones clave? No estás solo. Las búsquedas por similitud semántica en bases de datos vectoriales nos salvaron de las rígidase e ineficientes búsquedas por palabras clave. Sin embargo, cuando la complejidad del conocimiento escala, los vectores empiezan a mostrar costuras bastante feas: miopía contextual, alucinaciones selectivas y una incapacidad casi cómica para entender relaciones entre conceptos distantes.

    Ahí es donde entra en juego GraphRAG, un enfoque que combina la potencia de los grafos de conocimiento estructurados con los modelos de lenguaje. ¿Estamos ante el fin de la hegemonía vectorial pura? Vamos a destripar la tecnología.

    (más…)
  • ¿El «systemd» de la Inteligencia Artificial? El debate que agita el kernel de Linux

    ¿El «systemd» de la Inteligencia Artificial? El debate que agita el kernel de Linux

    El software libre vuelve a vivir uno de esos momentos bisagra que marcan época. Si tienes una edad informática respetable o si simplemente peinas canas en el ecosistema Linux, recordarás perfectamente las acaloradas discusiones que incendiaron foros, listas de correo y chats de IRC cuando systemd llegó para jubilar al clásico SysVinit. Aquello no fue un simple cambio de software; fue un debate filosófico sobre la modularidad, la simplicidad del sistema y hasta dónde debía extenderse la responsabilidad de un gestor de procesos central.

    Pues bien, agárrate al teclado porque la historia se repite. Un conjunto de desarrolladores y arquitectos de sistemas ha puesto sobre la mesa una propuesta tan ambiciosa como polémica: crear una capa de abstracción unificada en el espacio de usuario dentro de Linux para gestionar los recursos de aceleración de Inteligencia Artificial. Sí, algo así como un «systemd para el kernel de IA». Y, como era de esperar, la comunidad ya ha sacado los destornilladores técnicos y las pancartas filosóficas.

    (más…)
  • Inmutabilidad al rescate: cómo Ubuntu Core elimina los fallos catastróficos en dispositivos embebidos y de alta seguridad

    Inmutabilidad al rescate: cómo Ubuntu Core elimina los fallos catastróficos en dispositivos embebidos y de alta seguridad

    ¿Alguna vez has experimentado el sudor frío de lanzar un apt upgrade remoto en un servidor crítico o en un dispositivo en producción y ver cómo la conexión SSH se corta para siempre? En el ámbito de la informática de consumo, un fallo en una actualización te deja una tarde entretenido reinstallando el sistema. Pero cuando ese sistema operativo está gestionando un robot industrial, una pasarela de pago, un punto de recarga o un satélite en órbita, un kernel panic o una dependencia rota significan desplazar a un técnico sobre el terreno o dar por perdida la máquina.

    El problema de las distribuciones Linux tradicionales para entornos embebidos (Edge Computing) radica en la mutabilidad de su sistema de archivos raíz (/). Los gestores de paquetes convencionales modifican archivos compartidos, librerías del sistema y binarios directamente en el disco. Si la corriente eléctrica se corta a mitad de un proceso de escritura o si un paquete introduce un conflicto de dependencias (dependency hell), el sistema puede quedar en un estado inconsistente e irrecuperable.

    (más…)
  • El día que Linux se volvió en tiempo real: Por qué la llegada de PREEMPT_RT al kernel 6.12 lo cambia todo

    El día que Linux se volvió en tiempo real: Por qué la llegada de PREEMPT_RT al kernel 6.12 lo cambia todo

    Si llevas unos cuantos años en el mundo de la informática, probablemente hayas escuchado la frase: «Linux no es un sistema operativo en tiempo real». Y durante más de tres décadas, la afirmación era completamente cierta. Podías usar Linux para mover servidores web masivos, renderizar películas en 3D o hacer funcionar supercomputadores, pero si intentabas controlar el sistema de frenos ABS de un coche o el brazo de un robot cirujano, corrías el riesgo de que una simple interrupción del sistema provocara un desastre.

    Hoy, esa limitación ha pasado oficialmente a la historia.

    Tras más de 20 años de desarrollo continuo, parches externos y acalorados debates en las listas de correo de los desarrolladores del kernel, el parche PREEMPT_RT (Real-Time Preemption) ha quedado integrado de forma nativa e incondicional en la rama principal (mainline) del kernel de Linux, a partir de la versión 6.12.

    (más…)
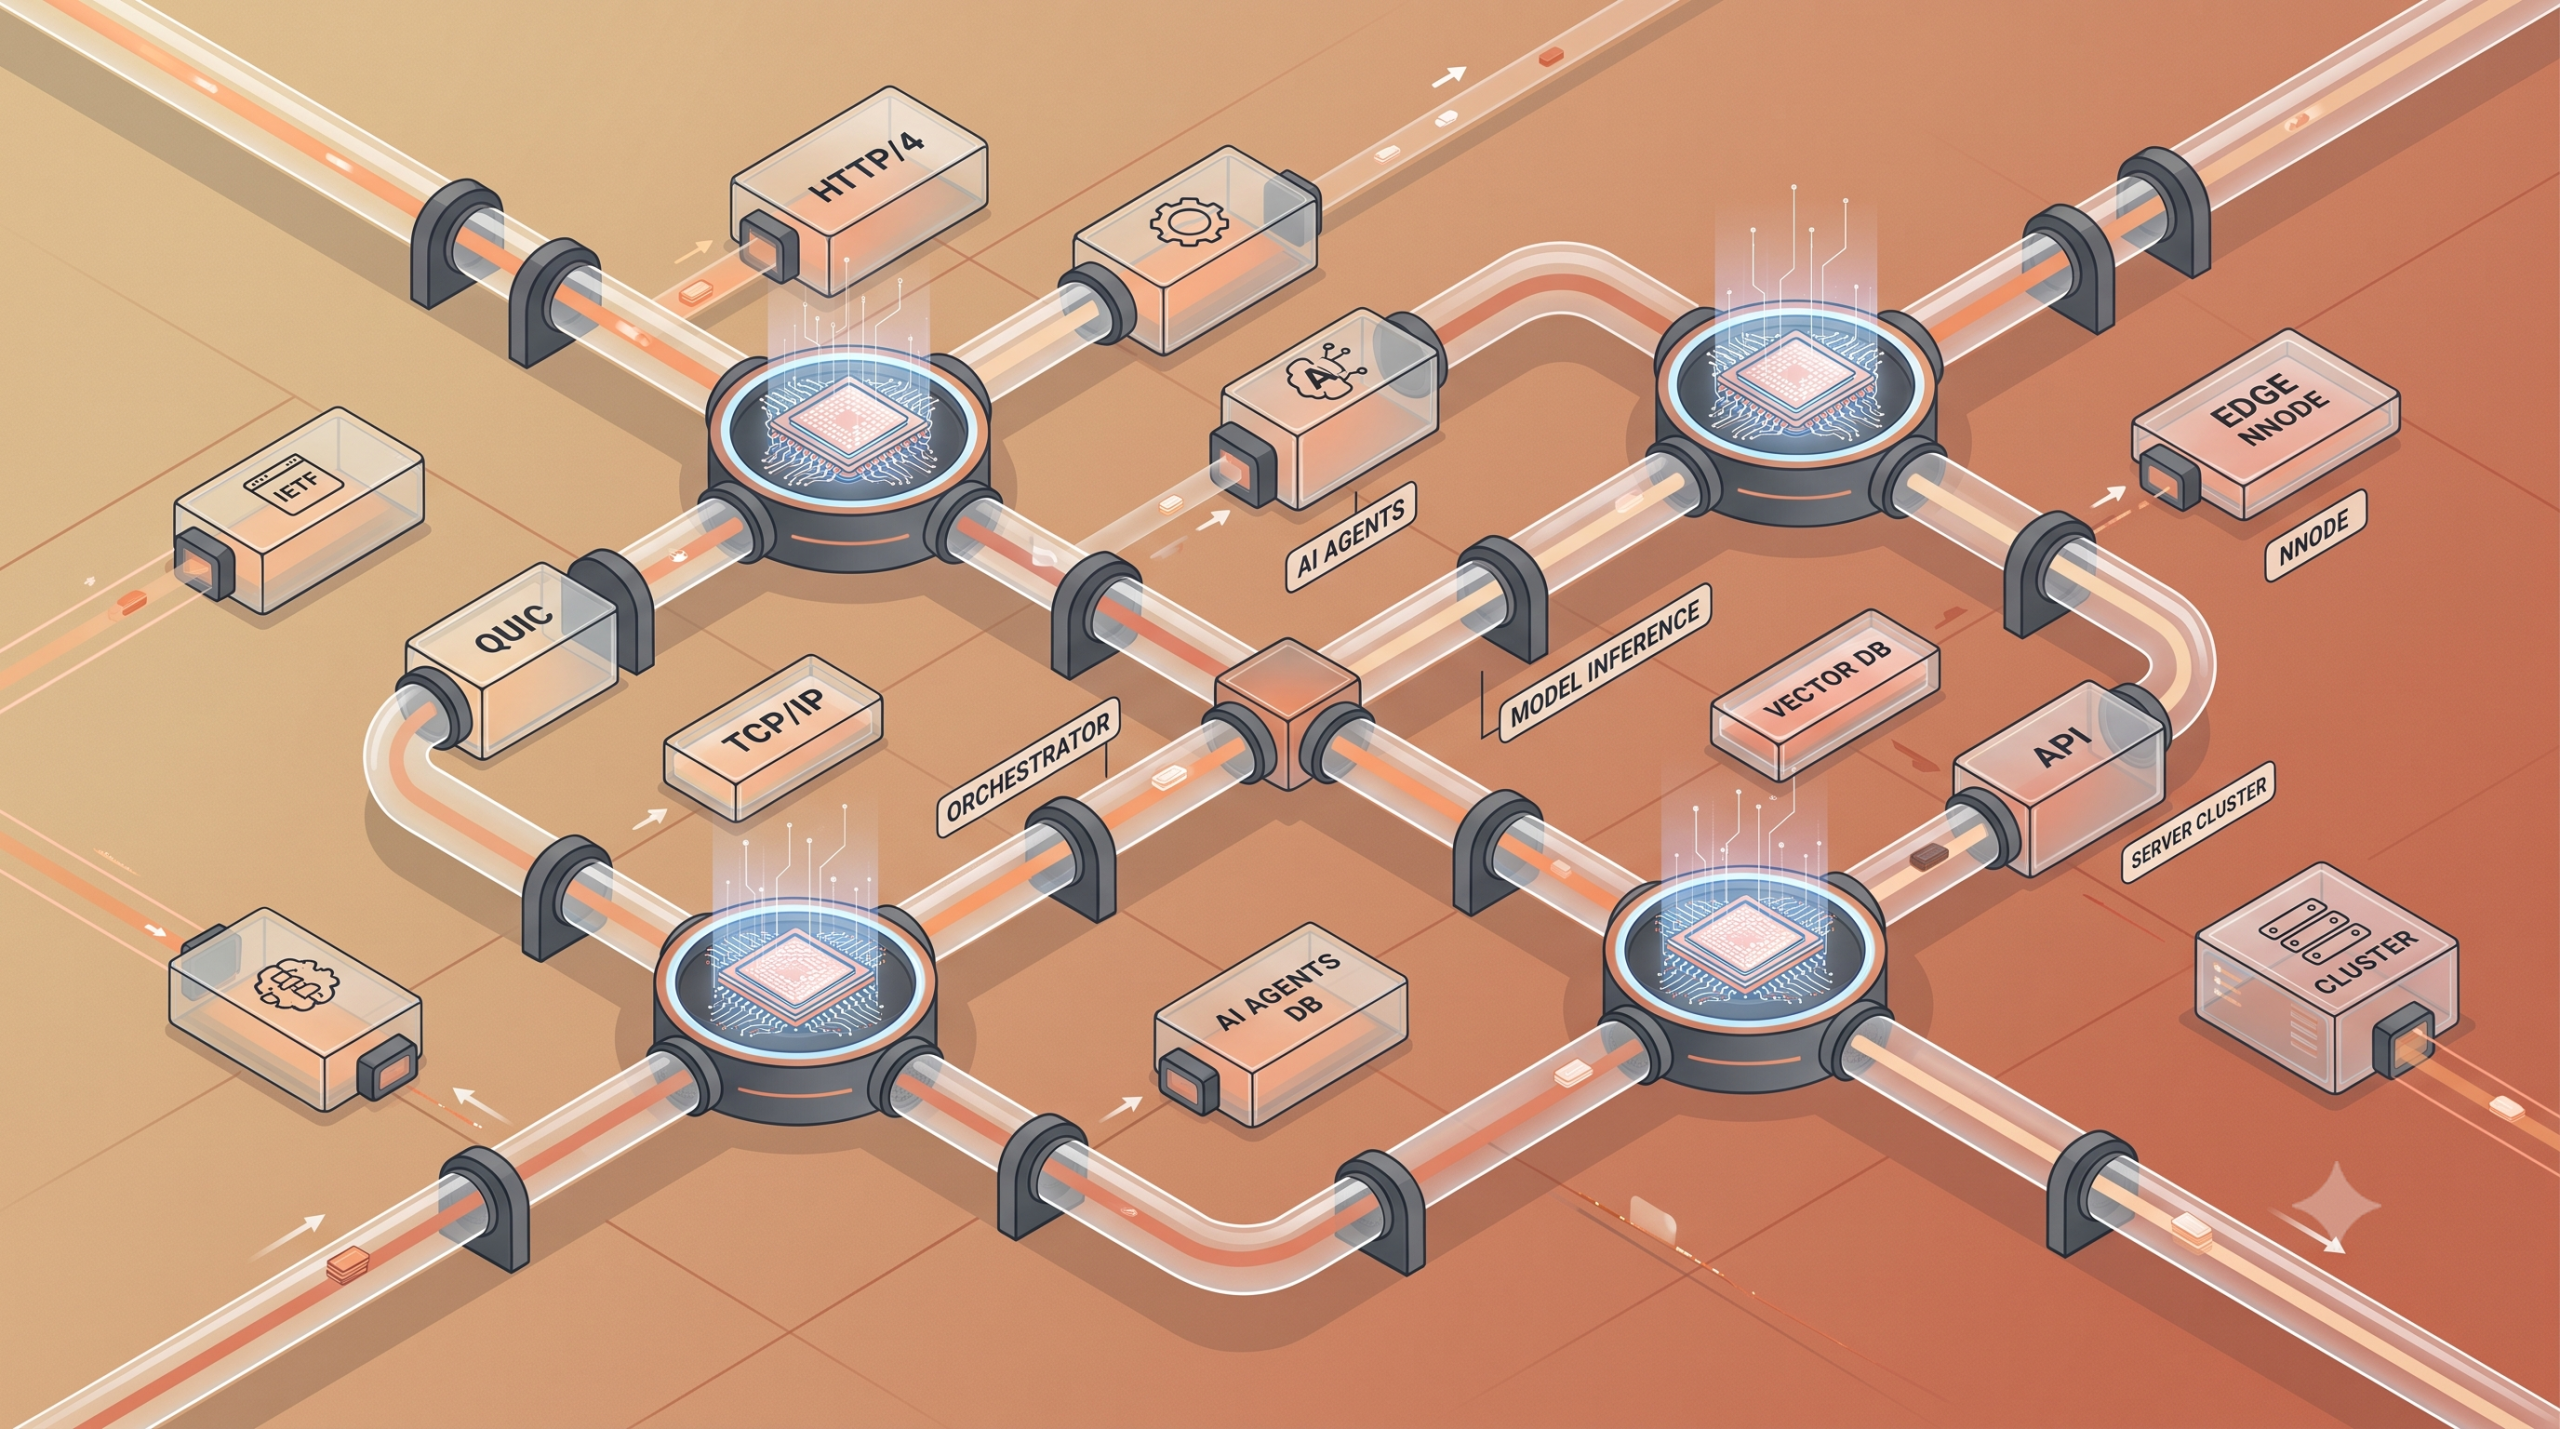
  • ¿Está internet preparado para la IA? El IETF ya diseña el nuevo protocolo HTTP/4

    ¿Está internet preparado para la IA? El IETF ya diseña el nuevo protocolo HTTP/4

    Imagínate que heredas una red de carreteras de los años cincuenta diseñada para que unos pocos camiones repartan leche por el pueblo, y de la noche a la mañana, te toca gestionar una flota de millones de vehículos autónomos hiperactivos que viajan a la velocidad de la luz, cruzando datos en tiempo real y hablando entre ellos en cada esquina. El colapso está garantizado. Pues bien, algo muy parecido le está ocurriendo a las bambalinas de internet. Las infraestructuras de red que heredamos del mundo de las páginas web estáticas y el streaming de vídeo se están empezando a quedar sin aliento. El culpable tiene nombres y apellidos: la explosión de los agentes de inteligencia artificial autónomos y la necesidad de procesar inferencia paralela masiva de forma distribuida por todo el planeta.

    Ante esta tesitura, el grupo de trabajo de ingeniería de Internet (IETF) no se ha quedado de brazos cruzados viendo cómo los servidores echan humo. Ya se han puesto en marcha los primeros borradores oficiales de lo que será el futuro protocolo HTTP/4. Y no, no se trata de una simple actualización de mantenimiento para arañar un par de milisegundos de velocidad al cargar tus fotos de gatitos; estamos ante una reingeniería estructural profunda pensada por y para un ecosistema dominado por modelos de lenguaje y agentes autónomos.

    (más…)
  • El hardware de tu usuario al rescate: La revolución de la Inteligencia Artificial nativa en el navegador

    El hardware de tu usuario al rescate: La revolución de la Inteligencia Artificial nativa en el navegador

    Durante los últimos años, el despliegue de cualquier aplicación basada en Inteligencia Artificial ha seguido un guion tan predecible como costoso. Un usuario escribe un prompt en su pantalla, este viaja por la red devorando milisegundos de latencia, aterriza en un descomunal centro de datos y es procesado por un mastodóntico clúster de GPUs sedientas de energía. Acto seguido, la infraestructura te devuelve la respuesta junto con una bonita factura por los costes de computación en la nube que te obliga a replantearte tu modelo de negocio.

    Mantener servidores encendidos procesando inferencias para miles de usuarios simultáneos es un pozo sin fondo financiero y un dolor de cabeza logístico. Además, nos enfrentamos constantemente al eterno dilema de la privacidad: ¿realmente queremos que los datos confidenciales de nuestros clientes viajen por servidores de terceros solo para resumir un PDF o sugerir una línea de código? La dependencia absoluta de las APIs en la nube ha creado un cuello de botella que amenaza con estancar la innovación en proyectos medianos y pequeños.

    (más…)
  • ¿El fin de los picateclas? Por qué la IA no te va a quitar el puesto (pero tu forma de programar sí va a cambiar)

    ¿El fin de los picateclas? Por qué la IA no te va a quitar el puesto (pero tu forma de programar sí va a cambiar)

    Seguro que te ha pasado. Estás tranquilamente en una cena familiar, comentas que trabajas en desarrollo de software y alguien, con una mirada entre condescendiente y apocalíptica, te suelta: «Aprovecha ahora, que con ChatGPT y los agentes autónomos os quedan dos telediarios». Es el mantra del momento. La narrativa pública insiste en que las Inteligencias Artificiales Generativas avanzan tan rápido que escribir código se convertirá en una reliquia del pasado, similar a operar una centralita telefónica manual. Para quienes pasamos el día peleando con punteros, arquitecturas distribuidas y dependencias rotas, esta afirmación no solo resulta molesta, sino que demuestra un profundo desconocimiento de lo que realmente significa programar. El verdadero problema no es que una máquina aprenda a escribir sintaxis; el problema es confundir el acto de teclear líneas de código con el arte de resolver problemas complejos de ingeniería.

    (más…)
  • El declive del commit tradicional: Por qué Git abraza los metadatos semánticos nativos

    El declive del commit tradicional: Por qué Git abraza los metadatos semánticos nativos

    Admitámoslo en la intimidad de nuestro entorno de desarrollo: escribir mensajes de commit es, para la mayoría de los programadores, una de las tareas más tediosas del universo. Todos hemos comenzado el día con un pulcro y académico feat(auth): implement OAuth2 token refresh architecture, para terminar a las tres de la mañana enviando un desesperado fix: por favor funciona ya o el clásico asdasdasd. Este factor humano introduce caos en los historiales de versiones, rompe las herramientas de automatización y drena energía mental.

    (más…)