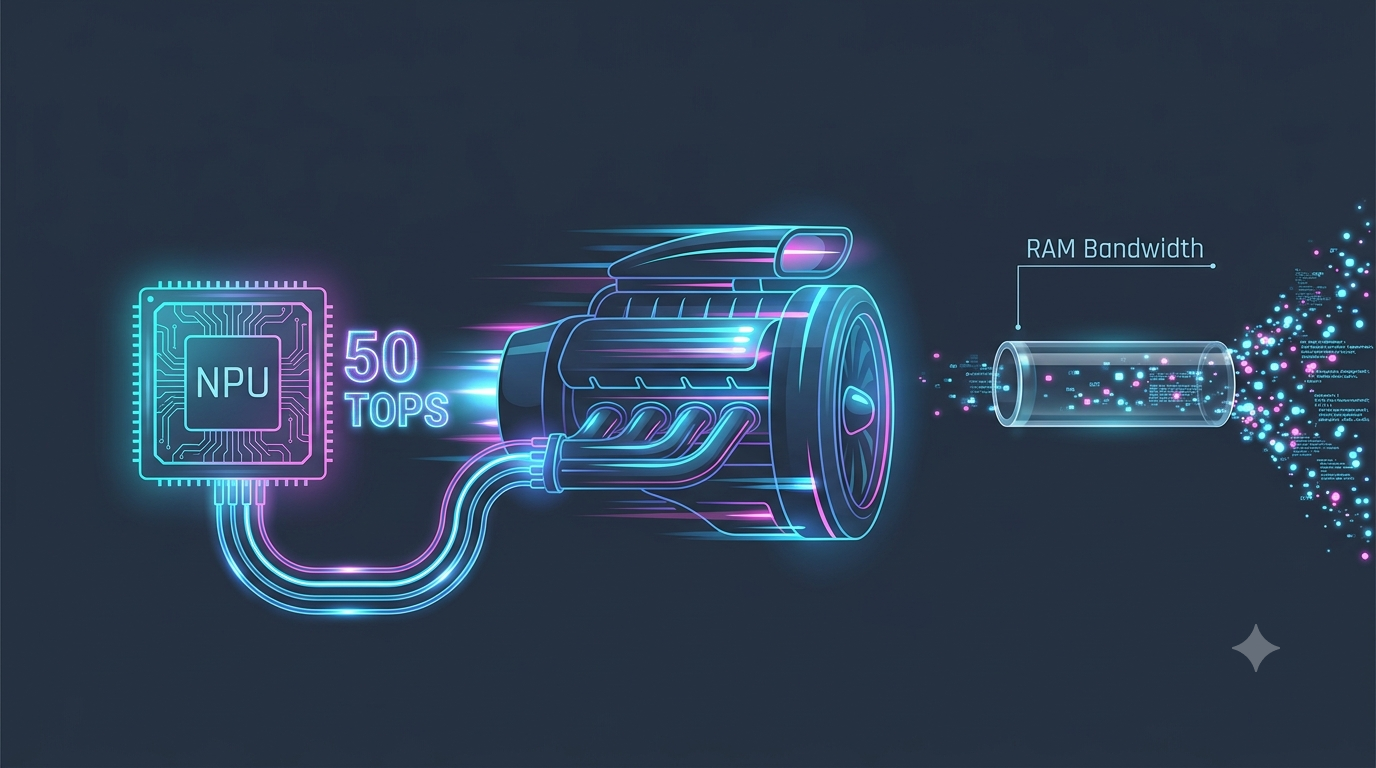
Pasear por la ficha técnica de un procesador de última generación se ha convertido en un ejercicio de fuegos artificiales. «¡50 TOPS de potencia para Inteligencia Artificial!», nos gritan las pegatinas en los portátiles y las presentaciones con música épica. Es la nueva carrera de los megahertzios, solo que esta vez el trofeo se mide en billones de operaciones por segundo (TOPS).
Sin embargo, cuando intentas ejecutar un modelo de lenguaje local (un LLM de unos discretos 7 u 8 billones de parámetros) para redactar código o analizar un documento, la realidad te da una bofetada en forma de tasa de tokens por segundo sorprendentemente ridícula.
¿Por qué esa impresionante NPU (Unidad de Procesamiento Neuronal) teórica se arrastra a la hora de la verdad? SPOILER: El marketing nos está vendiendo la velocidad punta de un Ferrari que solo puede circular por una calle llena de baches y restricciones de tráfico.
El engaño de las métricas: no todas las matemáticas de IA pesan lo mismo
Para entender el estancamiento, primero debemos desmontar qué mide exactamente la cifra de TOPS (Trillion Operations Per Second). Cuando un fabricante presume de 45 o 50 TOPS en una NPU integrada, casi siempre nos está dando la cifra teórica en operaciones de precisión entera ultra baja, típicamente INT8 o incluso INT4.
Estas métricas son fabulosas para tareas de visión artificial en tiempo real, eliminación de ruido de fondo en videoconferencias, clasificación de imágenes en segundo plano o aplicar filtros biométricos a la cámara web. En esos escenarios, la NPU brilla porque realiza millones de operaciones matemáticas simples sobre un flujo constante pero pequeño de datos. Son cargas de trabajo guiadas por la capacidad de cómputo (compute-bound).
El problema es que un LLM no funciona así. La fase de inferencia en un modelo de lenguaje —especialmente durante la generación token a token— no está limitada por cuántas operaciones matemáticas es capaz de escupir tu chip por segundo. Está brutalmente ahogada por la rapidez con la que el chip puede traer los pesos del modelo desde la memoria RAM hasta sus núcleos de cálculo. Es un problema clásico impulsado por el ancho de banda (memory-bound).
  VISIÓN / AUDIO (Compute-Bound)          INFERENCIA DE LLMs (Memory-Bound)
┌─────────────────────────────────┐      ┌─────────────────────────────────┐
│ Datos pequeños + Cómputo denso  │      │ Pesos masivos + Cómputo secuencial│
│  [RAM] ──> (NPU) 🔥 🔥 🔥      │      │  [RAM] ══════════> (NPU/GPU)    │
│  La NPU trabaja al 100%         │      │     Cuello de botella de VRAM    │
└─────────────────────────────────┘      └─────────────────────────────────┘
La ley de hierro del ancho de banda: matemáticas de servilleta
Hagamos un cálculo rápido para entender la magnitud del drama sin ponernos demasiado solemnes.
Imagina un modelo muy popular como Llama-3 de 8B cuantizado a 4 bits (INT4). Cada parámetro ocupa medio byte. O lo que es lo mismo, el modelo ocupa unos 4 GB en memoria. Para que tu procesador genere un único token (una palabra o fragmento de palabra), necesita leer de la memoria la totalidad de esos 4 GB de pesos, uno a uno, para calcular la siguiente probabilidad.
Si pretendes alcanzar una velocidad fluida de lectura —digamos, 30 tokens por segundo—, tu sistema tiene que mover:
4 GB × 30 tokens/s = 120 GB/s
¿Cuál es el ancho de banda medio de la memoria RAM LPDDR5X en un portátil convencional donde la NPU comparte bus con la CPU y la GPU? Con suerte, ronda entre los 60 GB/s y 80 GB/s.
Ahí tienes la triste realidad. Da igual que tu NPU prometa 1000 TOPS: si la memoria solo puede abastecerla a 60 GB/s, el chip pasará el 80 % de su tiempo esperando cruzado de brazos a que lleguen los datos. Es como ponerle el motor de un avión de combate a un camión de la basura que está atrapado en un atasco a las ocho de la mañana.
| Arquitectura de Hardware | Ancho de Banda Típico | Rendimiento Real en LLMs (Local) |
|---|---|---|
| NPU Integrada (RAM Compartida) | ~60 – 100 GB/s | 10 – 20 tokens/seg (Sufre cuello de botella) |
| GPU Dedicada (VRAM GDDR6) | ~300 – 500 GB/s | 60 – 100 tokens/seg (Fluido) |
| SoC con Memoria Unificada Ancha | ~400 – 800 GB/s | 80 – 150 tokens/seg (Muy eficiente) |
La paradoja del software y los compiladores
Por si el cuello de botella físico no fuera suficiente, se suma el factor software. Mientras que la GPU lleva décadas refinando sus runtimes y frameworks (con CUDA a la cabeza o bibliotecas consolidadas como llama.cpp e ONNX Runtime), las NPUs sufren una fragmentación feroz. Cada fabricante de silicio utiliza su propio compilador de grafos, obligando a los desarrolladores a convertir y optimizar modelos con herramientas específicas que a menudo carecen de soporte nativo para primitivas avanzadas.
Al final, la mayoría de herramientas de inferencia local como Ollama, LM Studio o vLLM terminan delegando el trabajo duro a los núcleos de la GPU integrada o dedicada, dejando a la flamante NPU libre… para difuminar el fondo en tus llamadas de Teams.
¿Hacia dónde va el hardware real para desarrolladores?
¿Significa esto que las NPUs son inútiles? En absoluto. Tienen un rendimiento por vatio imbatible en tareas puntuales y continuadas de bajo consumo, librando a la CPU y GPU de tareas accesorias. Pero si tu objetivo como informático, desarrollador o entusiasta es ejecutar agentes autónomos, asistentes de código o LLMs locales sin desesperar en el intento, la métrica en la que debes fijarte no es la etiqueta promocional de TOPS.
El criterio real a evaluar en el hardware moderno para IA se resume en tres pilares:
- Ancho de banda de memoria (GB/s): Es el verdadero factor limitante en la generación de texto.
- Capacidad de memoria unificada o VRAM dedicadas: Para evitar la latencia de transferencia PCIe.
- Ecosistema de drivers y soporte en
llama.cpp/ PyTorch: De nada sirve un silicio potente si ningún entorno ejecutable puede compilar sus instrucciones.
La próxima vez que veas un anuncio presumiendo de decenas de TOPS, sonríe con condescendencia técnica. La IA local no va de cuántas operaciones teóricas puede calcular un chip en el vacío, sino de la anchura de las tuberías por las que fluyen los datos.
¿Y tú? ¿Has probado a ejecutar modelos locales en portátiles de última generación? ¿Te has chocado contra el muro del ancho de banda o has conseguido exprimir la NPU de tu equipo? ¡Te leo en los comentarios!
Deja una respuesta