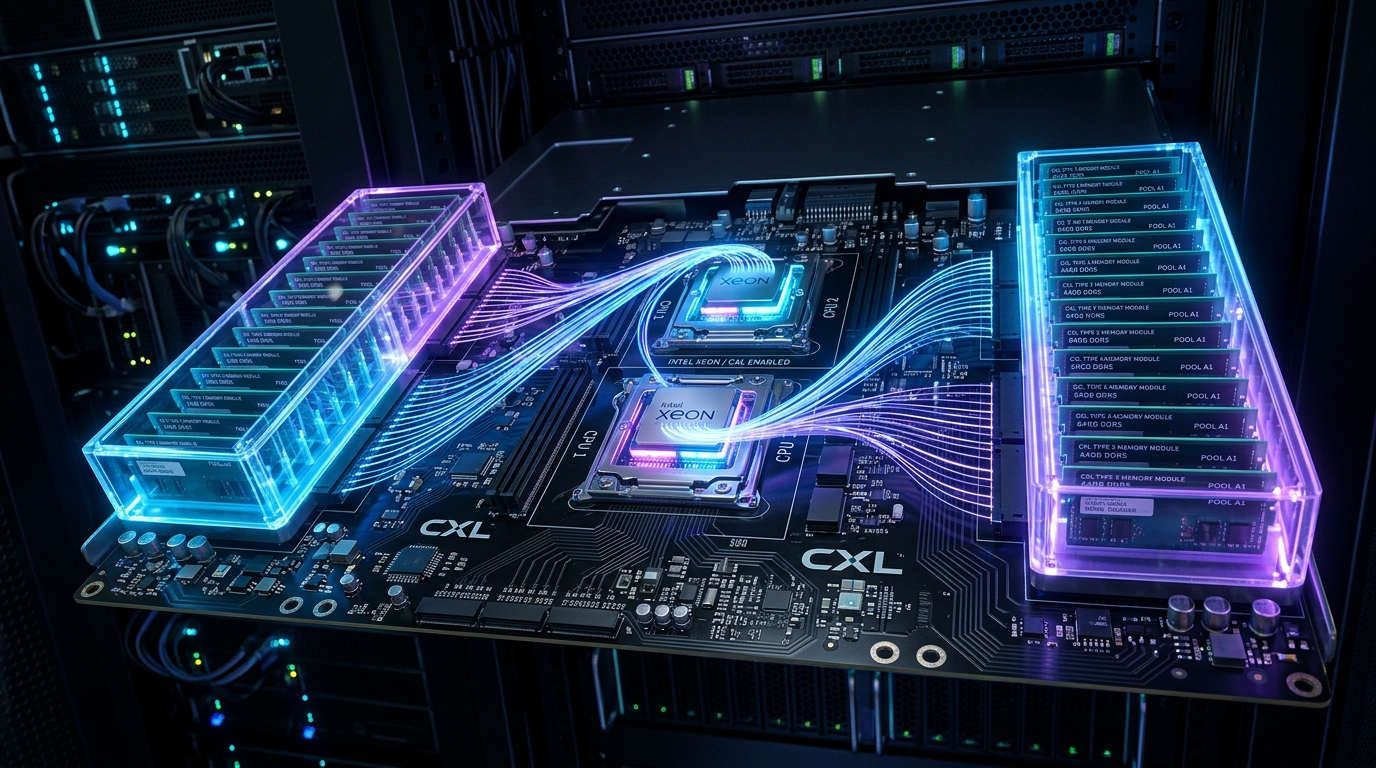
Imagina que acabas de comprar la mejor tarjeta gráfica o la CPU de servidor más potente del mercado para entrenar tu nuevo modelo de IA. Todo va fluido, los núcleos vuelan… hasta que recibes el temido mensaje: OutOfMemoryError. La triste realidad del hardware actual es que, por mucho músculo de procesamiento que añadas a un centro de datos, si la memoria RAM se agota, tus preciados chips se quedan esperando con los brazos cruzados. Este cuello de botella, conocido técnicamente como el «muro de la memoria» (memory wall), ha traído de cabeza a ingenieros de Google, Microsoft y Meta durante años.
(más…)Etiqueta: Arquitectura de Computadores
-
TOPS de escaparate: por qué la NPU de tu nuevo portátil se ahoga con los LLMs
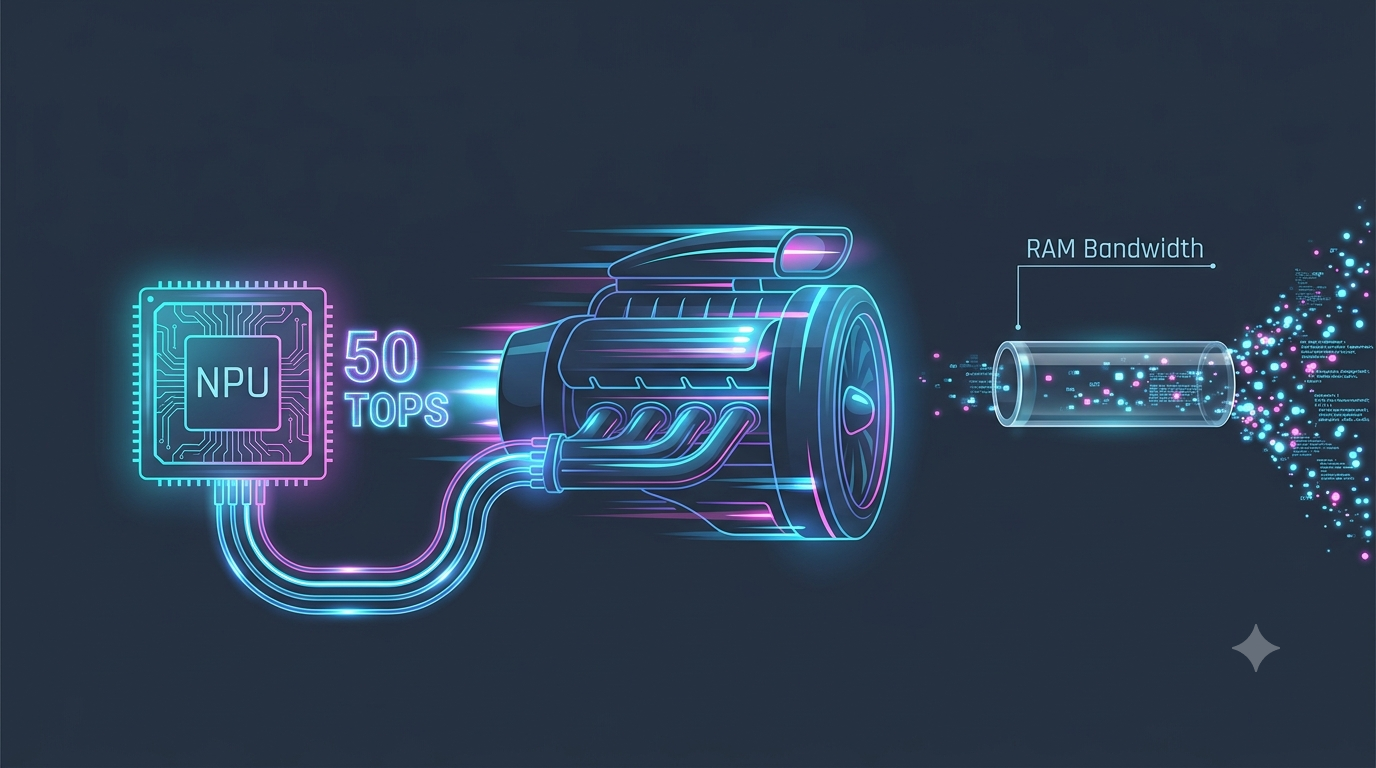
Pasear por la ficha técnica de un procesador de última generación se ha convertido en un ejercicio de fuegos artificiales. «¡50 TOPS de potencia para Inteligencia Artificial!», nos gritan las pegatinas en los portátiles y las presentaciones con música épica. Es la nueva carrera de los megahertzios, solo que esta vez el trofeo se mide en billones de operaciones por segundo (TOPS).
Sin embargo, cuando intentas ejecutar un modelo de lenguaje local (un LLM de unos discretos 7 u 8 billones de parámetros) para redactar código o analizar un documento, la realidad te da una bofetada en forma de tasa de tokens por segundo sorprendentemente ridícula.
¿Por qué esa impresionante NPU (Unidad de Procesamiento Neuronal) teórica se arrastra a la hora de la verdad? SPOILER: El marketing nos está vendiendo la velocidad punta de un Ferrari que solo puede circular por una calle llena de baches y restricciones de tráfico.
(más…)