Etiqueta: llama.cpp

  • TOPS de escaparate: por qué la NPU de tu nuevo portátil se ahoga con los LLMs

    TOPS de escaparate: por qué la NPU de tu nuevo portátil se ahoga con los LLMs

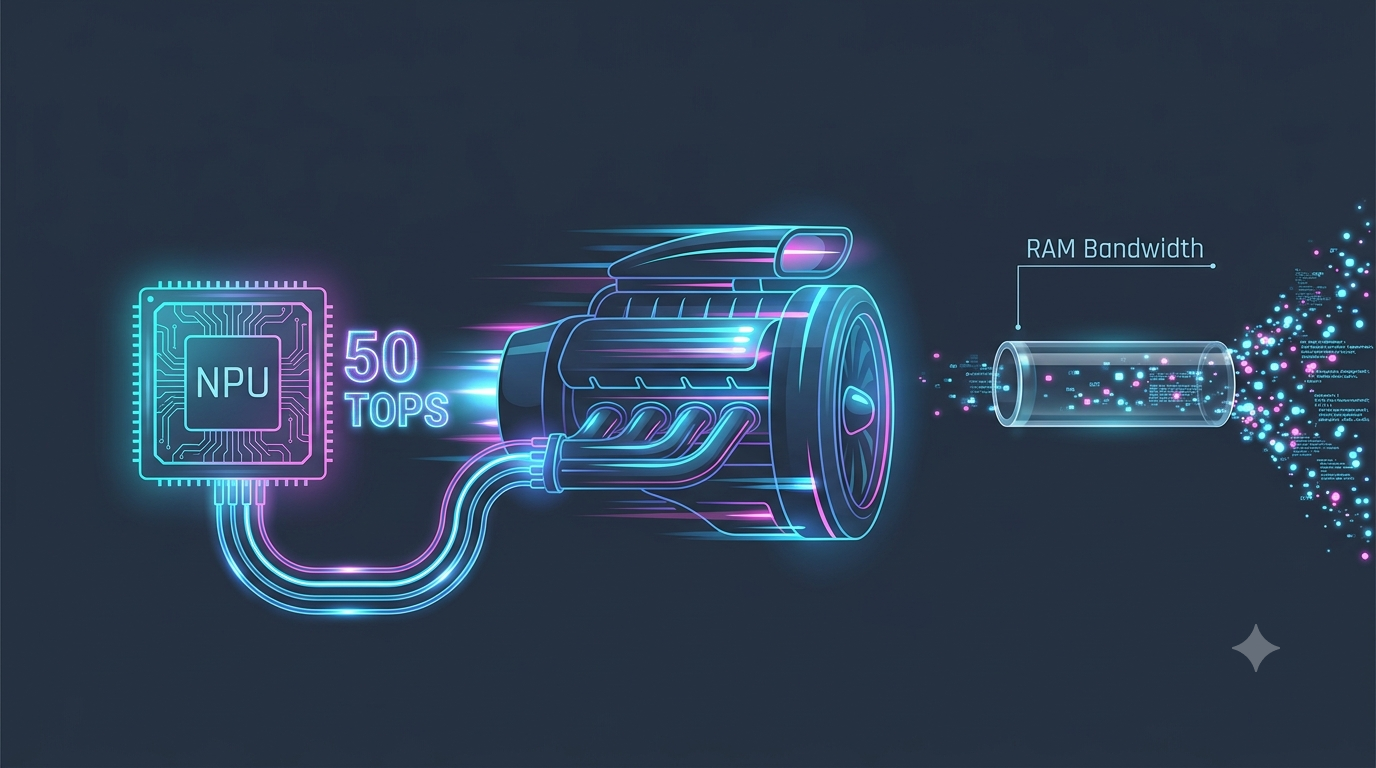
    Pasear por la ficha técnica de un procesador de última generación se ha convertido en un ejercicio de fuegos artificiales. «¡50 TOPS de potencia para Inteligencia Artificial!», nos gritan las pegatinas en los portátiles y las presentaciones con música épica. Es la nueva carrera de los megahertzios, solo que esta vez el trofeo se mide en billones de operaciones por segundo (TOPS).

    Sin embargo, cuando intentas ejecutar un modelo de lenguaje local (un LLM de unos discretos 7 u 8 billones de parámetros) para redactar código o analizar un documento, la realidad te da una bofetada en forma de tasa de tokens por segundo sorprendentemente ridícula.

    ¿Por qué esa impresionante NPU (Unidad de Procesamiento Neuronal) teórica se arrastra a la hora de la verdad? SPOILER: El marketing nos está vendiendo la velocidad punta de un Ferrari que solo puede circular por una calle llena de baches y restricciones de tráfico.

    (más…)
  • El milagro de la cuantización extrema: Cómo meter un LLM gigante en la CPU de tu patinete eléctrico (o casi)

    El milagro de la cuantización extrema: Cómo meter un LLM gigante en la CPU de tu patinete eléctrico (o casi)

    Imaginas que mañana decides montar un centro de datos en tu propia casa para correr una Inteligencia Artificial de última generación. Vas a tu tienda de hardware de confianza, miras el precio de un clúster de GPUs de nivel empresarial y, de repente, vender un riñón ya no te parece una mala idea financiera. Hasta hace dos días, si querías ejecutar un modelo de lenguaje (LLM) con cara y ojos de manera local, o tenías una tarjeta gráfica que consumías más energía que una pequeña ciudad del norte de España, o estabas condenado a ver cómo tu ordenador procesaba un token cada tres minutos. La dependencia de las API de pago y de los servidores en la nube parecía el único camino para los mortales. Sin embargo, la comunidad del open source se ha cansado de pedir permiso (y créditos bancarios) a las grandes tecnológicas.

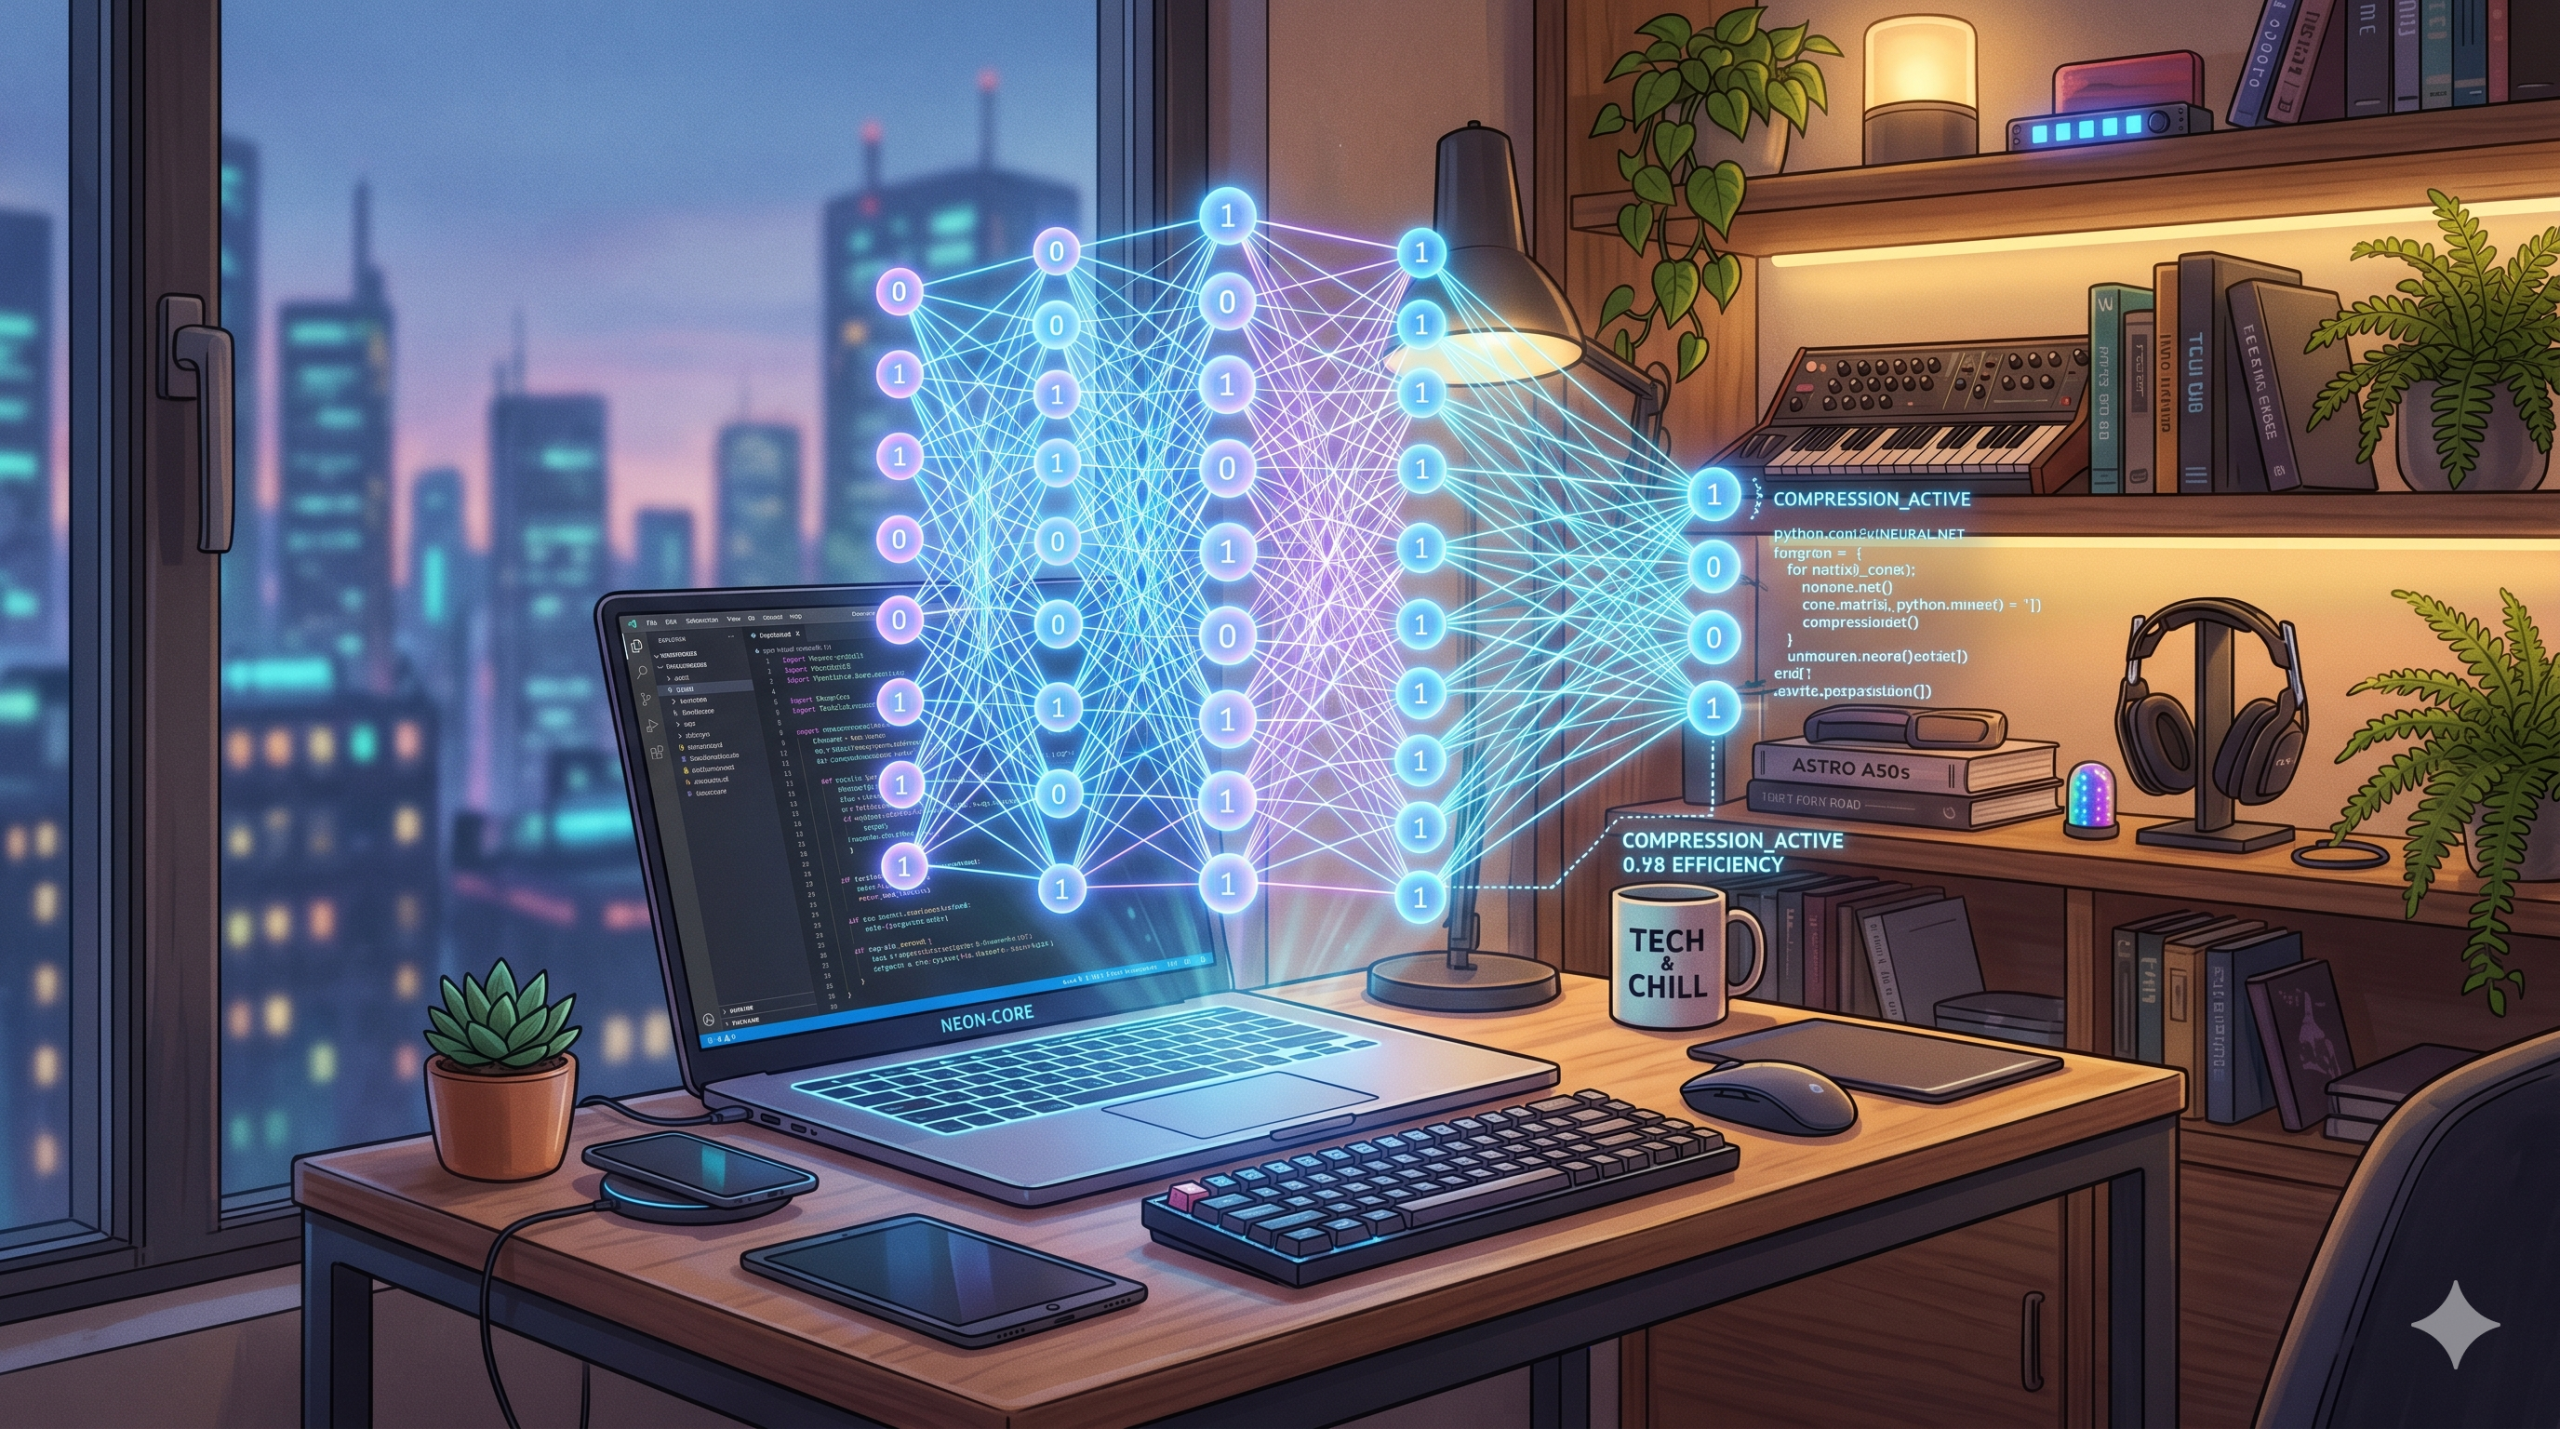
    El cuello de botella de la IA generativa local nunca ha sido únicamente la potencia de cálculo bruta, sino algo mucho más mundano: la memoria RAM y el ancho de banda. Cuando descargamos un modelo de lenguaje convencional, nos encontramos con gigabytes y gigabytes de coeficientes numéricos llamados «parámetros». Originalmente, estos pesos se guardan en formatos de alta precisión, como FP16 (punto flotante de 16 bits). Hagan las matemáticas conmigo, queridos desarrolladores: un modelo modesto de 70.000 millones de parámetros (70B) en FP16 requiere algo más de 140 GB de VRAM solo para cargarse en memoria. Eso descarta automáticamente al 99% de los ordenadores del planeta. Durante el proceso de inferencia paralela, la CPU o la GPU tienen que mover continuamente todos esos gigabytes desde la memoria de almacenamiento hasta los registros del procesador. Es el clásico problema informático donde la autopista es demasiado estrecha para tanto tráfico.

    (más…)