Imagina abrir la tapa de tu portátil en medio de un vuelo transatlántico sin conexión a internet, ejecutar un modelo de lenguaje de última generación para auditar miles de líneas de código o redactar informes confidenciales, y obtener respuestas instantáneas sin que un solo byte abandone tu máquina. Durante años nos acostumbraremos a delegar la inteligencia artificial a clústeres lejanos de GPUs en la nube, pero la nueva era de la informática personal ha marcado una raya en el suelo: la IA del futuro se ejecuta en tu propio silicio, local, privada y a máxima velocidad.
(más…)Etiqueta: Hardware IA
-
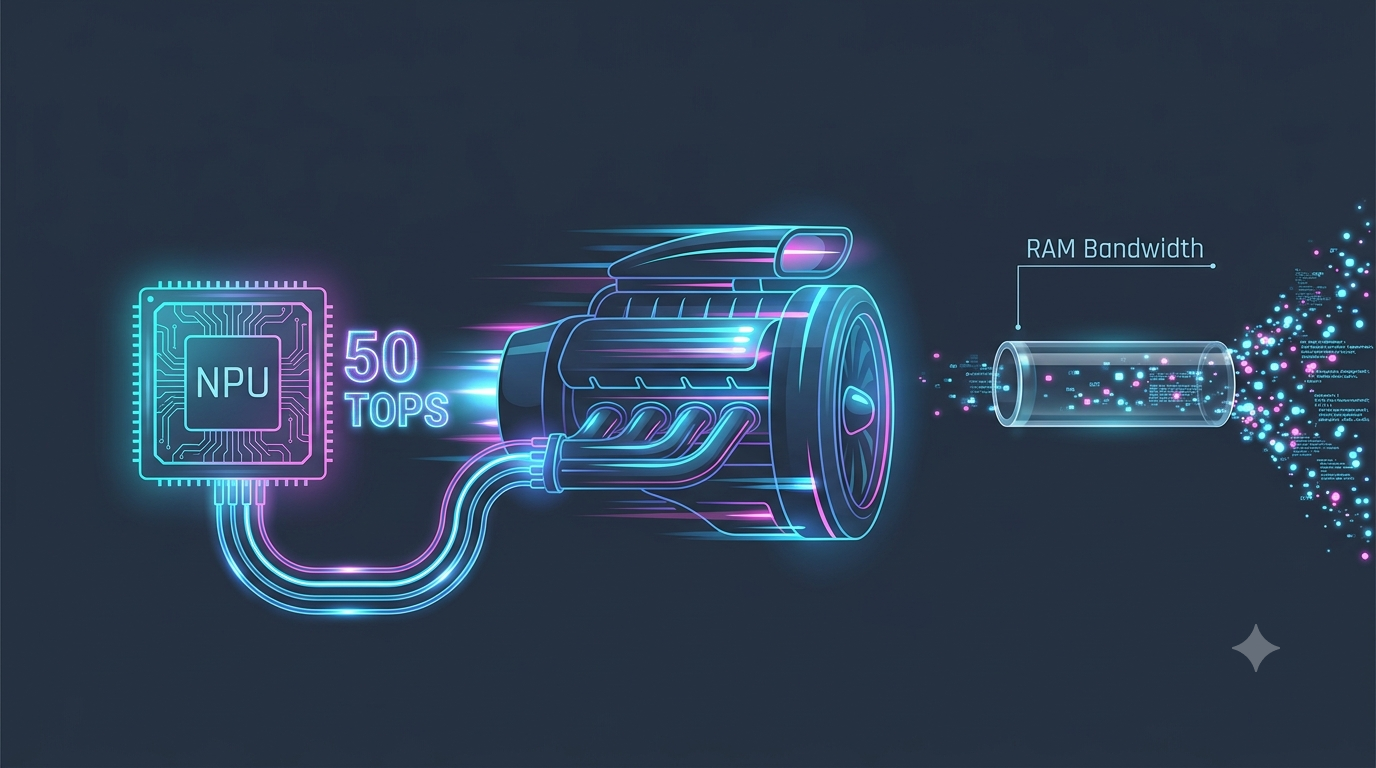
TOPS de escaparate: por qué la NPU de tu nuevo portátil se ahoga con los LLMs
Pasear por la ficha técnica de un procesador de última generación se ha convertido en un ejercicio de fuegos artificiales. «¡50 TOPS de potencia para Inteligencia Artificial!», nos gritan las pegatinas en los portátiles y las presentaciones con música épica. Es la nueva carrera de los megahertzios, solo que esta vez el trofeo se mide en billones de operaciones por segundo (TOPS).
Sin embargo, cuando intentas ejecutar un modelo de lenguaje local (un LLM de unos discretos 7 u 8 billones de parámetros) para redactar código o analizar un documento, la realidad te da una bofetada en forma de tasa de tokens por segundo sorprendentemente ridícula.
¿Por qué esa impresionante NPU (Unidad de Procesamiento Neuronal) teórica se arrastra a la hora de la verdad? SPOILER: El marketing nos está vendiendo la velocidad punta de un Ferrari que solo puede circular por una calle llena de baches y restricciones de tráfico.
(más…)