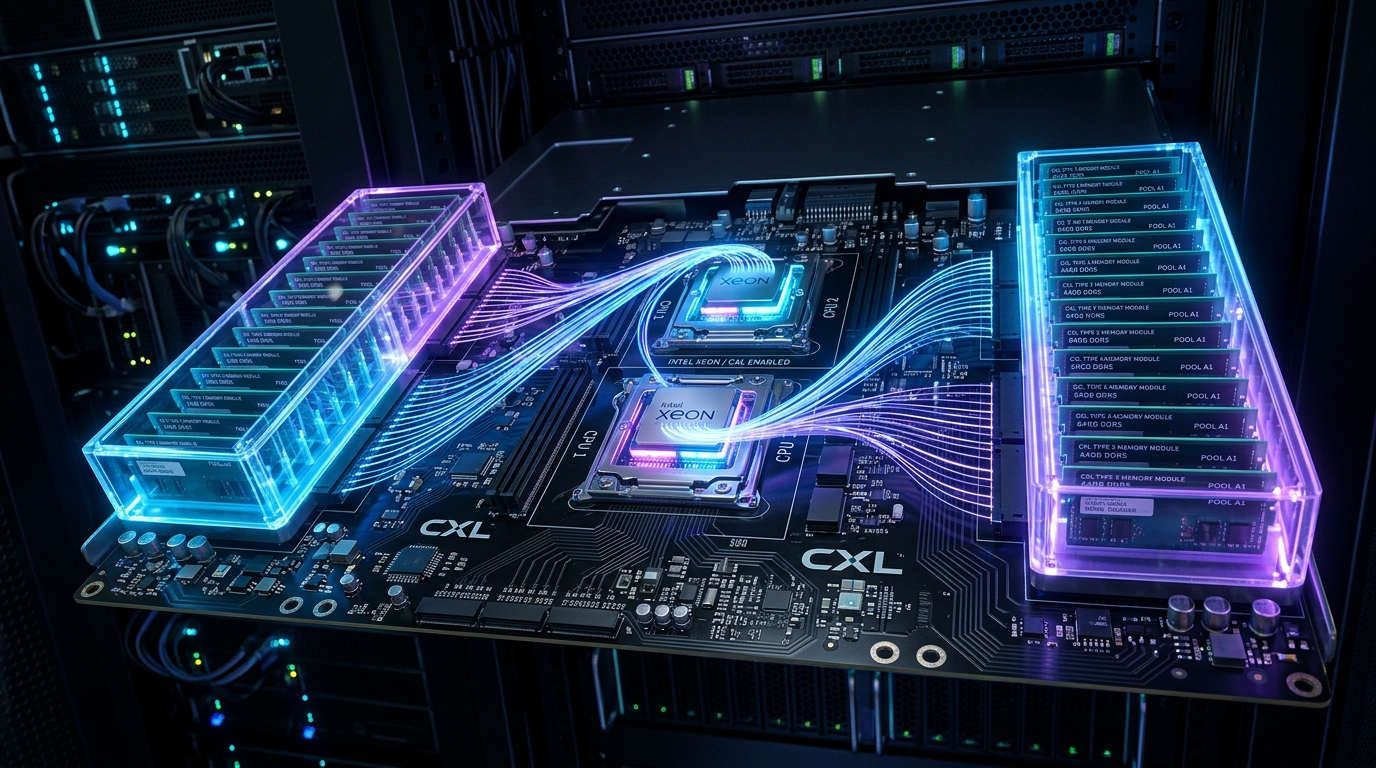
Imagina que acabas de comprar la mejor tarjeta gráfica o la CPU de servidor más potente del mercado para entrenar tu nuevo modelo de IA. Todo va fluido, los núcleos vuelan… hasta que recibes el temido mensaje: OutOfMemoryError. La triste realidad del hardware actual es que, por mucho músculo de procesamiento que añadas a un centro de datos, si la memoria RAM se agota, tus preciados chips se quedan esperando con los brazos cruzados. Este cuello de botella, conocido técnicamente como el «muro de la memoria» (memory wall), ha traído de cabeza a ingenieros de Google, Microsoft y Meta durante años.
Hasta la fecha, aumentar la capacidad de memoria RAM en una arquitectura convencional de servidor era un dolor de cabeza económico e ingenieril. La RAM vive ligada férreamente a las ranuras DIMM adosadas al zócalo del procesador. ¿Necesitas el doble de gigabytes para sostener el contexto de un modelo de lenguaje masivo? La solución tradicional te obligaba a comprar otro servidor entero o cambiar la CPU por un modelo superior, sobredimensionando la infraestructura y dejando recursos desperdiciados. Como diríamos en la jerga de sistemas: estabas pagando por un chalet entero solo porque necesitabas una habitación extra para guardar libros.
La situación se ha vuelto insostenible con la explosión de los *Large Language Models* (LLM) y el procesamiento paralelo en clústeres de GPUs. Cuando procesamos inferencias masivas, almacenar las cachés de claves y valores (KV cache) requiere cientos de gigabytes de memoria rápida accesible al instante. Ni siquiera las codiciadas memorias HBM apiladas dentro de los aceleradores son suficientes en términos de capacidad por dólar. Aquí es donde entra en juego el estándar Compute Express Link (CXL).
¿Qué es exactamente CXL y cómo rompe esta barrera?
En términos sencillos, CXL es un protocolo de interconexión abierto y de alta velocidad montado sobre la capa física de PCIe (PCIe 5.0 y PCIe 6.0/7.0 en las revisiones CXL 2.0 a 4.0). Su gran magia estriba en algo llamado coherencia de caché. A diferencia de un SSD rápido donde la CPU debe gestionar lecturas/escrituras mediante operaciones de E/S tradicionales, el bus CXL permite que el procesador trate la memoria remota acoplada externamente como si estuviera directamente insertada en la placa base, utilizando instrucciones estándar de carga y almacenamiento (load/store).
Dentro del ecosistema CXL encontramos tres tipos de dispositivos principales:
- Type 1: Aceleradores sin memoria propia (como tarjetas de red inteligentes o SmartNICs) que necesitan acceder de forma coherente a la RAM de la CPU.
- Type 2: Procesadores gráficos y FPGAs con su propia memoria integrada (HBM o GDDR) que comparten su espacio de direcciones con el procesador.
- Type 3: Expansores de memoria puros. Módulos en formato de tarjeta PCIe o ranura EDSFF repletos de chips DDR5 que añaden terabytes adicionales al sistema a golpe de clic.
Lo revolucionario de CXL no es solo enchufar más tarjetas de memoria a una máquina individual. La verdadera disrupción reside en el pooling de memoria (o memoria desagregada). Con arquitecturas CXL 2.0 y superiores, puedes conectar decenas de servidores a un «estante de memoria compartido» gestionado por conmutadores (CXL switches). Si el servidor A necesita 512 GB extra para asimilar una carga pico de datos, la red CXL se los asigna dinámicamente en nanosegundos. Cuando la tarea termina, esa memoria se devuelve al pool central para que la use el servidor B.
«CXL transforma la memoria de un componente estático soldado al procesador en un recurso fluido y orquestable por software a escala de rack.»
Latencias y rendimiento real: ¿Vale la pena la penalización?
Sé lo que estás pensando como buen apasionado del hardware: «Traer datos a través del bus PCIe añade latencia. ¿No ralentizará eso mis algoritmos?». La respuesta técnica es: sí, pero muy poco. Un controlador de memoria CXL añade un retardo adicional de aproximadamente 70 nanosegundos en comparación con la RAM conectada directamente al socket. Sin embargo, esta cifra es hasta 50 veces más rápida que el acceso a un almacenamiento NVMe ultrarrápido.
En pruebas recientes de despliegue en entornos cloud, un grupo de GPUs ejecutando inferencia sobre un pool CXL de 1 Terabyte demostró alcanzar hasta un 92% de la velocidad de la DRAM pura, pero permitiendo manejar modelos sustancialmente más amplios sin caer en fallos de ejecución. En el plano económico, gigantes como Microsoft apuntan a que la adición de pooling de memoria CXL puede reducir los requerimientos globales de RAM en centros de datos cerca de un 10%, ahorrando millones de dólares en infraestructura. 🤖
Un cambio de paradigma en la computación en la nube
El estándar Compute Express Link no busca sustituir a la memoria HBM de las aceleradoras ni a la RAM DDR5 local, sino actuar como un nivel intermedio indispensable (Tiered Memory). Nos encamina hacia una arquitectura verdaderamente «composable», donde el concepto de servidor cerrado desaparece para dar paso a piscinas de recursos de cómputo, red y memoria orquestadas de forma independiente.
¿Has tenido que lidiar ya con límites de VRAM o RAM en tus proyectos de inferencia local o en la nube? Te leo en los comentarios para debatir cómo crees que afectará la llegada masiva de CXL al precio de los módulos de memoria tradicionales.
Deja una respuesta