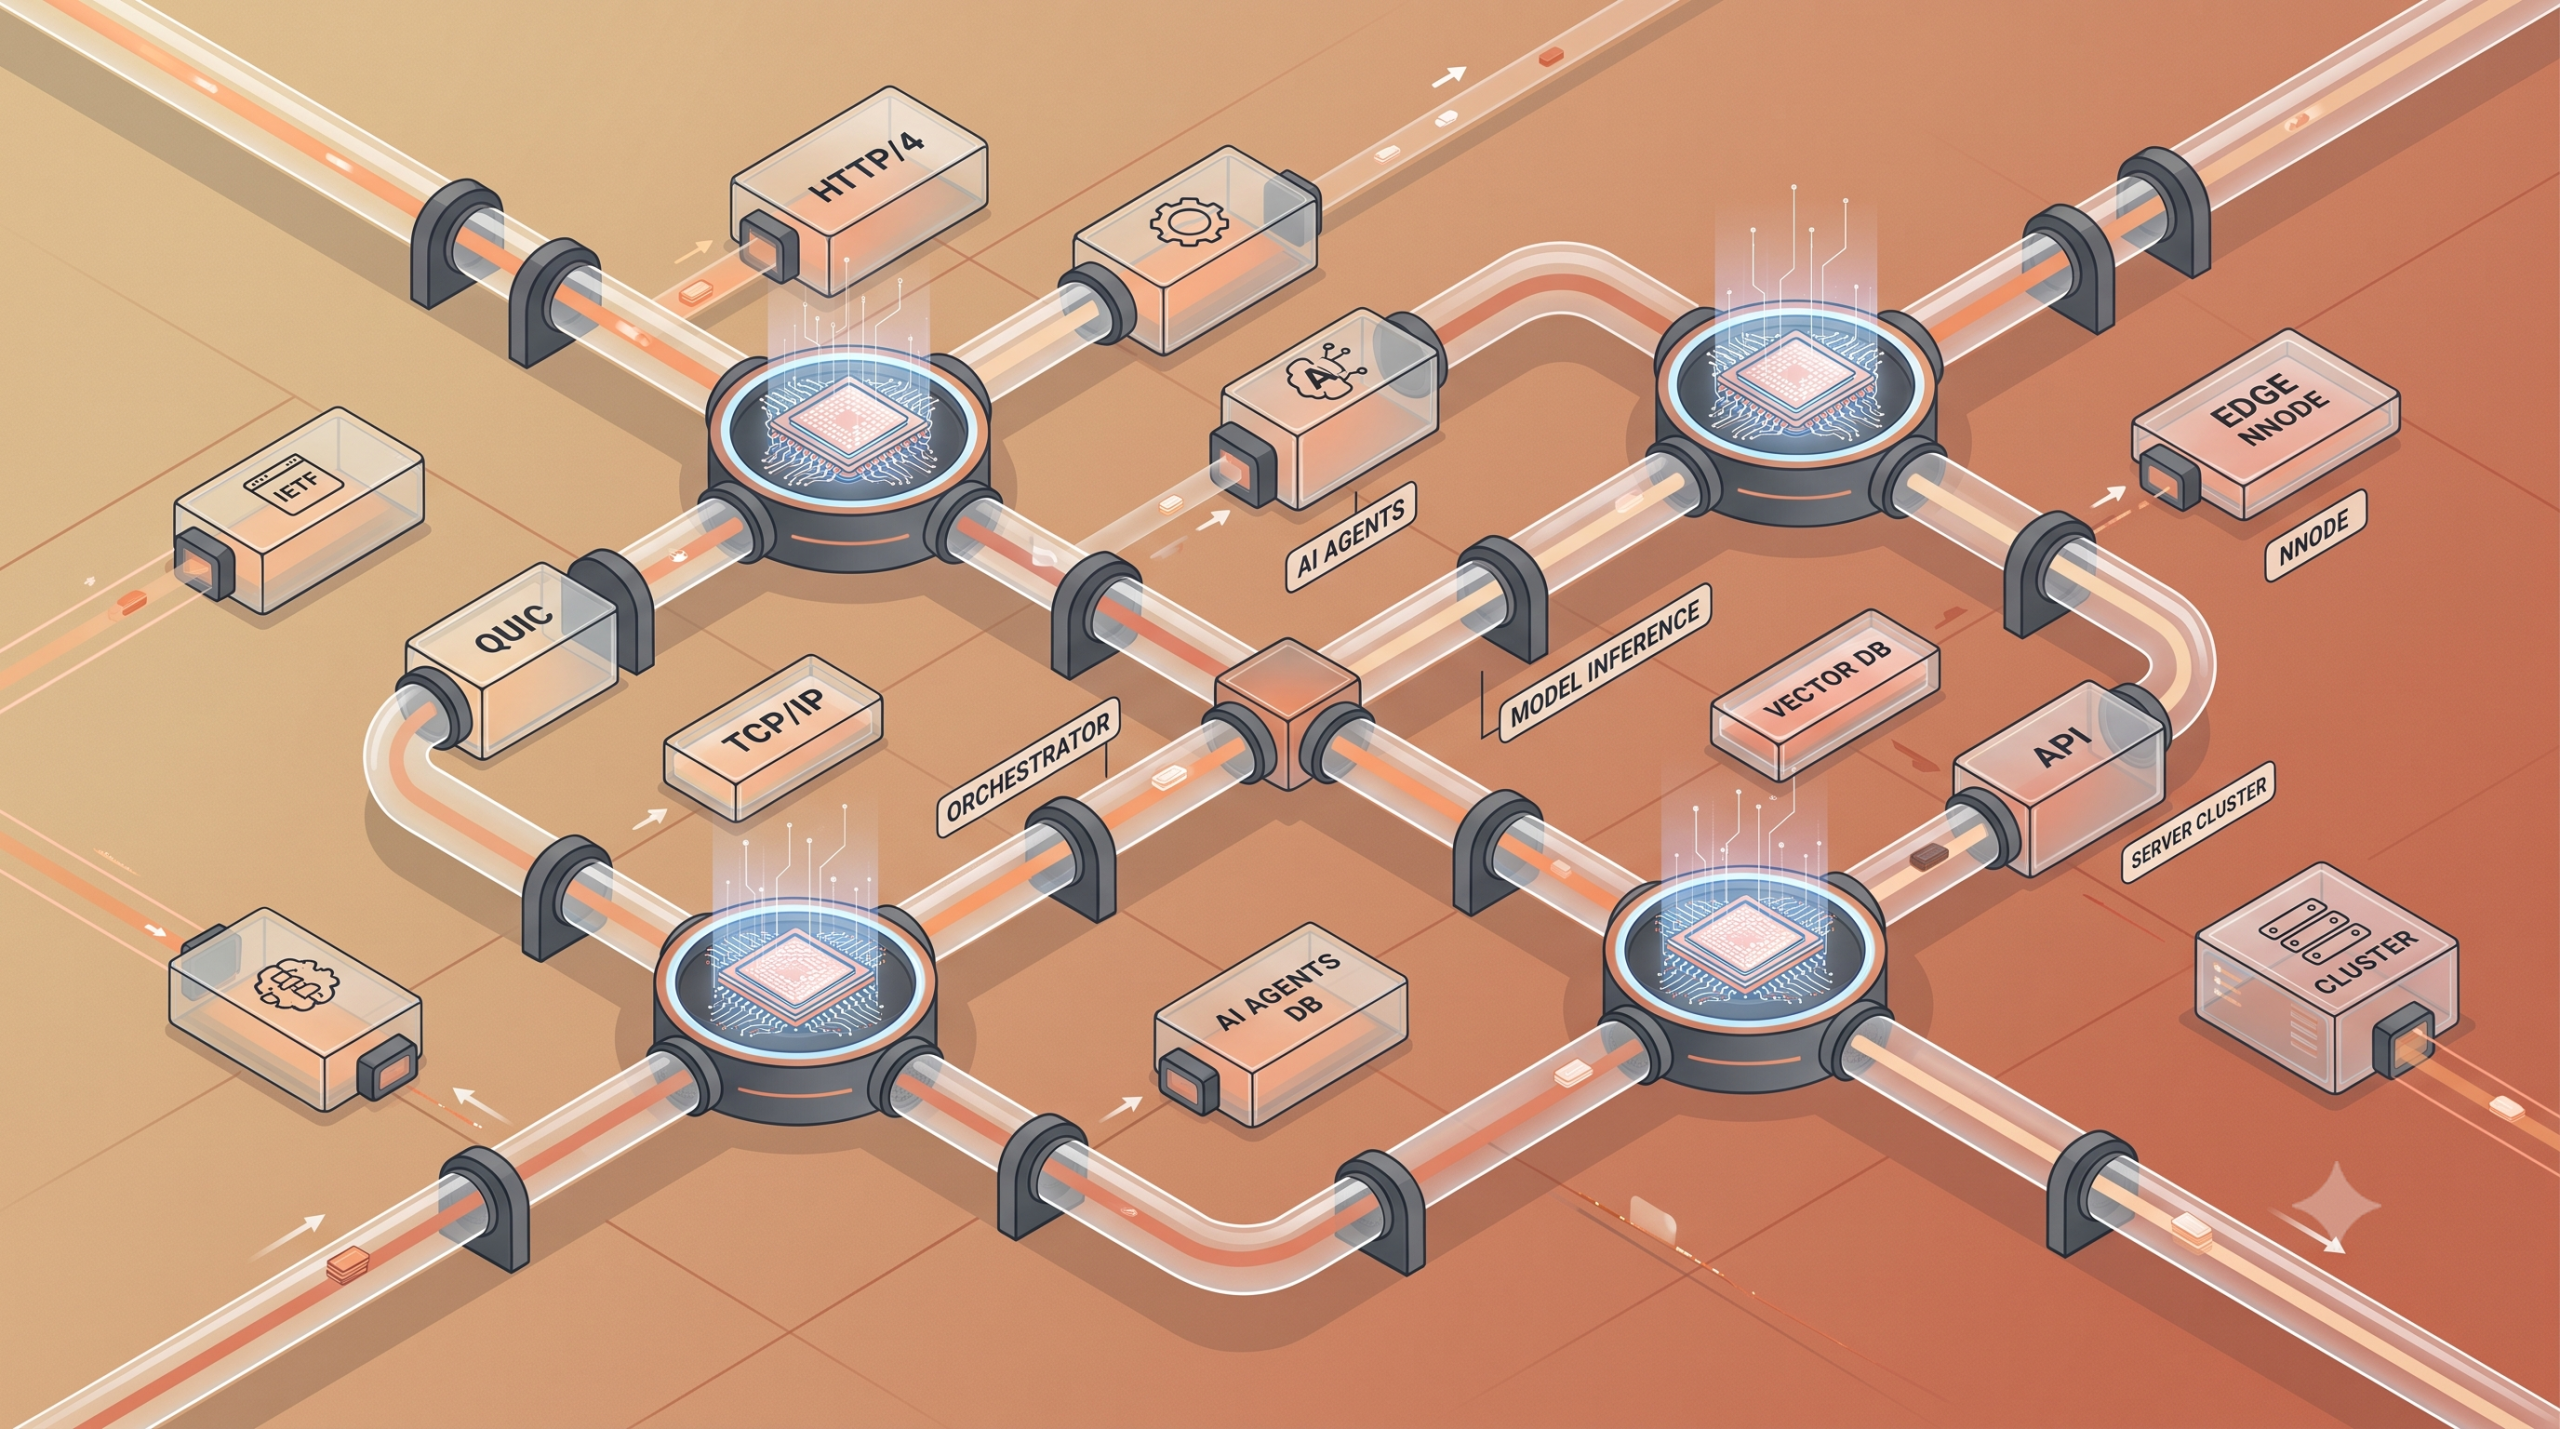
Imagínate que heredas una red de carreteras de los años cincuenta diseñada para que unos pocos camiones repartan leche por el pueblo, y de la noche a la mañana, te toca gestionar una flota de millones de vehículos autónomos hiperactivos que viajan a la velocidad de la luz, cruzando datos en tiempo real y hablando entre ellos en cada esquina. El colapso está garantizado. Pues bien, algo muy parecido le está ocurriendo a las bambalinas de internet. Las infraestructuras de red que heredamos del mundo de las páginas web estáticas y el streaming de vídeo se están empezando a quedar sin aliento. El culpable tiene nombres y apellidos: la explosión de los agentes de inteligencia artificial autónomos y la necesidad de procesar inferencia paralela masiva de forma distribuida por todo el planeta.
Ante esta tesitura, el grupo de trabajo de ingeniería de Internet (IETF) no se ha quedado de brazos cruzados viendo cómo los servidores echan humo. Ya se han puesto en marcha los primeros borradores oficiales de lo que será el futuro protocolo HTTP/4. Y no, no se trata de una simple actualización de mantenimiento para arañar un par de milisegundos de velocidad al cargar tus fotos de gatitos; estamos ante una reingeniería estructural profunda pensada por y para un ecosistema dominado por modelos de lenguaje y agentes autónomos.
De cargar texto a digerir flujos de inferencia paralela
Para entender el problema conceptual, hagamos un poco de memoria informática. El viejo HTTP/1.1 abría una conexión para cada recurso (un dolor de muelas). HTTP/2 introdujo el multiplexado para enviar varios archivos por el mismo canal. Luego llegó HTTP/3, que mandó al veterano protocolo TCP al banquillo de los suplentes para adoptar QUIC (basado en UDP), reduciendo la latencia de establecimiento de conexión a niveles espectaculares. Todo esto funcionaba de fábula cuando el usuario típico era un humano que pinchaba en un enlace, esperaba a que su navegador descargara un puñado de archivos estáticos y leía la pantalla.
Sin embargo, el paradigma de la inteligencia artificial generativa ha cambiado las reglas del juego de forma radical. Un solo agente de IA moderno no se limita a pedir un archivo HTML. Para responder a una consulta compleja, ese agente puede necesitar fragmentar la tarea en diez subprocesos, consultar simultáneamente tres bases de datos vectoriales distintas en la otra punta del mundo, lanzar una petición de análisis de imagen a un clúster de GPUs y coordinar la respuesta final mediante una cadena de pensamiento estructurada.
El tráfico web ya no es un viaje de ida y vuelta lineal; es un enjambre asíncrono, caótico y ultra-denso de pequeños paquetes de datos con dependencias críticas entre sí. Bajo los protocolos actuales, esta tormenta de consultas paralelas genera un fenómeno de saturación en las cabeceras de red y obliga a mantener abiertas miles de conexiones WebSocket simultáneas, devorando los recursos de memoria de los servidores de manera ineficiente. Entrenar un modelo de lenguaje es caro, pero mantener la infraestructura de red para que millones de usuarios hagan inferencia paralela al unísono se estaba convirtiendo en un auténtico pozo sin fondo financiero y técnico.
Las armas secretas de HTTP/4: Conexiones persistentes multi-agente
¿Cómo pretende solucionar este desaguisado el nuevo borrador de HTTP/4? La respuesta clave es la optimización nativa de flujos asíncronos persistentes. En lugar de tratar cada petición de un agente de IA como un evento aislado o un flujo multiplexado básico, el protocolo introduce el concepto de "canales cognitivos orquestados".
- Multiplexación semántica: El protocolo es capaz de priorizar los paquetes de datos no solo por su orden de llegada o su tamaño, sino por la urgencia del pipeline de ejecución de la IA. Si un subproceso de inferencia necesita un token específico para desbloquear el resto de la cadena de razonamiento de un modelo de lenguaje, HTTP/4 puede identificarlo en la capa de transporte y darle vía libre en el canal de datos.
- Negociación de carga de inferencia distribuida: HTTP/4 incluirá metadatos nativos en sus cabeceras para que los servidores comuniquen en tiempo real su capacidad de computación disponible. Un enrutador de red inteligente podrá desviar una petición de análisis sintáctico al nodo de la red (edge computing) que tenga menos saturación en sus aceleradores de hardware, optimizando la latencia antes incluso de que la petición llegue a tocar la capa de aplicación.
- Streaming bidireccional puro sin penalización: A diferencia de los parches actuales basados en Server-Sent Events (SSE) o WebSockets (que requieren arquitecturas de software pesadas), HTTP/4 integra el flujo constante de datos estructurados en su propio ADN, ideal para la generación de texto token a token a velocidades de vértigo.
Nota de arquitectura: Los primeros bancos de pruebas con el borrador preliminar de HTTP/4 estiman una reducción del 40% en la latencia de respuestas complejas de agentes multi-modelo distribuidos, lo que podría suponer un ahorro colosal de ancho de banda en infraestructuras cloud.
Un internet más eficiente, verde y descentralizado
El impacto a largo plazo de este cambio arquitectónico es monumental. En primer lugar, democratizará el uso de la inteligencia artificial. Al reducir drásticamente la sobrecarga de red (overhead) de las APIs de inferencia, las pequeñas empresas de desarrollo de software podrán integrar agentes autónomos avanzados en sus aplicaciones sin temor a que la factura de los proveedores de la nube arruine sus proyectos.
Además, hay un factor medioambiental ineludible. Menos conexiones ineficientes y un enrutamiento más inteligente significan que los centros de datos gastarán menos energía eléctrica en gestionar el tráfico de red de relleno, alineando el desarrollo del software con las prácticas de optimización energética globales. HTTP/4 no es solo un capricho de los ingenieros de redes para colgarse una medalla; es la autopista de información imprescindible que la próxima década digital necesita para no morir de éxito. El tejido de internet está madurando para dejar de ser una biblioteca de documentos y convertirse en un cerebro global distribuido. 🧠
¿Y tú cómo lo ves? ¿Crees que las grandes tecnológicas implementerán este estándar de forma nativa con rapidez o viviremos una guerra de protocolos propietarios antes de ver HTTP/4 en nuestros servidores habituales? Si te apasiona la arquitectura de sistemas y el backend, te leo en los comentarios. ¡Hablemos de redes!
Deja una respuesta