Etiqueta: Infraestructura Cloud

  • PostgreSQL 18 y el soporte experimental para índices vectoriales nativos: la revolución sin extensiones en bases de datos de IA

    PostgreSQL 18 y el soporte experimental para índices vectoriales nativos: la revolución sin extensiones en bases de datos de IA

    La inteligencia artificial y los modelos de lenguaje (LLM) han cambiado drásticamente la forma en que interactuamos con la información. Hoy en día, una aplicación moderna no solo busca coincidencias exactas de texto; necesita entender el significado implícito de las palabras. Para lograrlo, los datos se transforman en vectores numéricos de alta dimensión (embeddings), los cuales permiten realizar búsquedas por similitud semántica en tiempo récord.

    Hasta ahora, si querías trabajar con vectores en la base de datos relacional más querida y sólida del mundo del código abierto, la respuesta era casi unánime: instalar la extensión pgvector. Sin embargo, las reglas del juego están a punto de cambiar de forma radical. En el desarrollo activo de PostgreSQL 18, los mantenedores del motor han comenzado a probar soporte experimental para índices vectoriales nativos, directamente integrados en el núcleo (core) del sistema.

    El cuello de botella de la IA en arquitecturas RAG

    Cuando diseñamos sistemas de Generación Aumentada por Recuperación (RAG) o buscadores semánticos en tiempo real, el rendimiento y la complejidad de la arquitectura son las principales preocupaciones del equipo de ingeniería. Depender de extensiones externas para tareas críticas introduce varios retos técnicos de primer nivel:

    • Gestión de dependencias y despliegue: Mantener y actualizar extensiones en entornos distribuidos o gestionados (managed databases) requiere permisos elevados, comprobaciones de compatibilidad en cada actualización del motor y posibles desajustes de versiones en entornos multicloud.
    • Capa de abstracción y rendimiento: Aunque pgvector ha demostrado un rendimiento excelente con algoritmos como HNSW (Hierarchical Navigable Small World) e IVFFlat, las llamadas a través de las APIs de extensiones añaden una pequeña sobrecarga respecto a los tipos de datos primarios del núcleo.
    • Planificador de consultas (Query Planner): El planificador de PostgreSQL es extraordinariamente preciso estimando costes de acceso en índices B-Tree o GiST, pero no siempre dispone del mismo nivel de estadísticas profundas cuando interactúa con estructuras de datos vectoriales definidas por extensiones de terceros.
    (más…)
  • La gran fuga de las nubes propietarias: por qué el código abierto es la vacuna definitiva contra el ‘Vendor Lock-In’ en la era de la IA

    La gran fuga de las nubes propietarias: por qué el código abierto es la vacuna definitiva contra el ‘Vendor Lock-In’ en la era de la IA

    Imagina la siguiente escena: has diseñado la arquitectura de software de tu vida. Todo encaja a la perfección, las peticiones fluyen con la suavidad de un buen algoritmo de ordenación y el negocio escala sin pestañear. Pero, de repente, una mañana te llega un correo electrónico de tu proveedor de servicios en la nube favorito con un asunto aséptico: «Actualización en nuestros términos de servicio y tarifas». Al abrirlo, el café se te atraganta. Las API propietarias de las que depende toda tu lógica de negocio han duplicado su coste de inferencia paralela y, para colmo, han descatalogado la versión del modelo de lenguaje que alimentaba tus agentes autónomos. Intentas buscar alternativas y te das cuenta de la cruda realidad: tu código está tan acoplado a sus servicios que migrar a otro ecosistema te costaría meses de refactorización, miles de horas de desarrollo y un dolor de cabeza de proporciones épicas. Estás atrapado. Has caído en las garras del temido vendor lock-in.

    Esta pesadilla técnica no es una hipótesis de ciencia ficción para asustar a los programadores novatos en Halloween; es la realidad diaria a la que se enfrentan miles de CTOs e ingenieros de sistemas en todo el mundo. Durante la última década, la comodidad del «pago por uso» de las grandes plataformas propietarias nos hizo bajar la guardia, delegando la infraestructura crítica en manos de unos pocos gigantes tecnológicos que ahora controlan las llaves del reino digital.

    (más…)
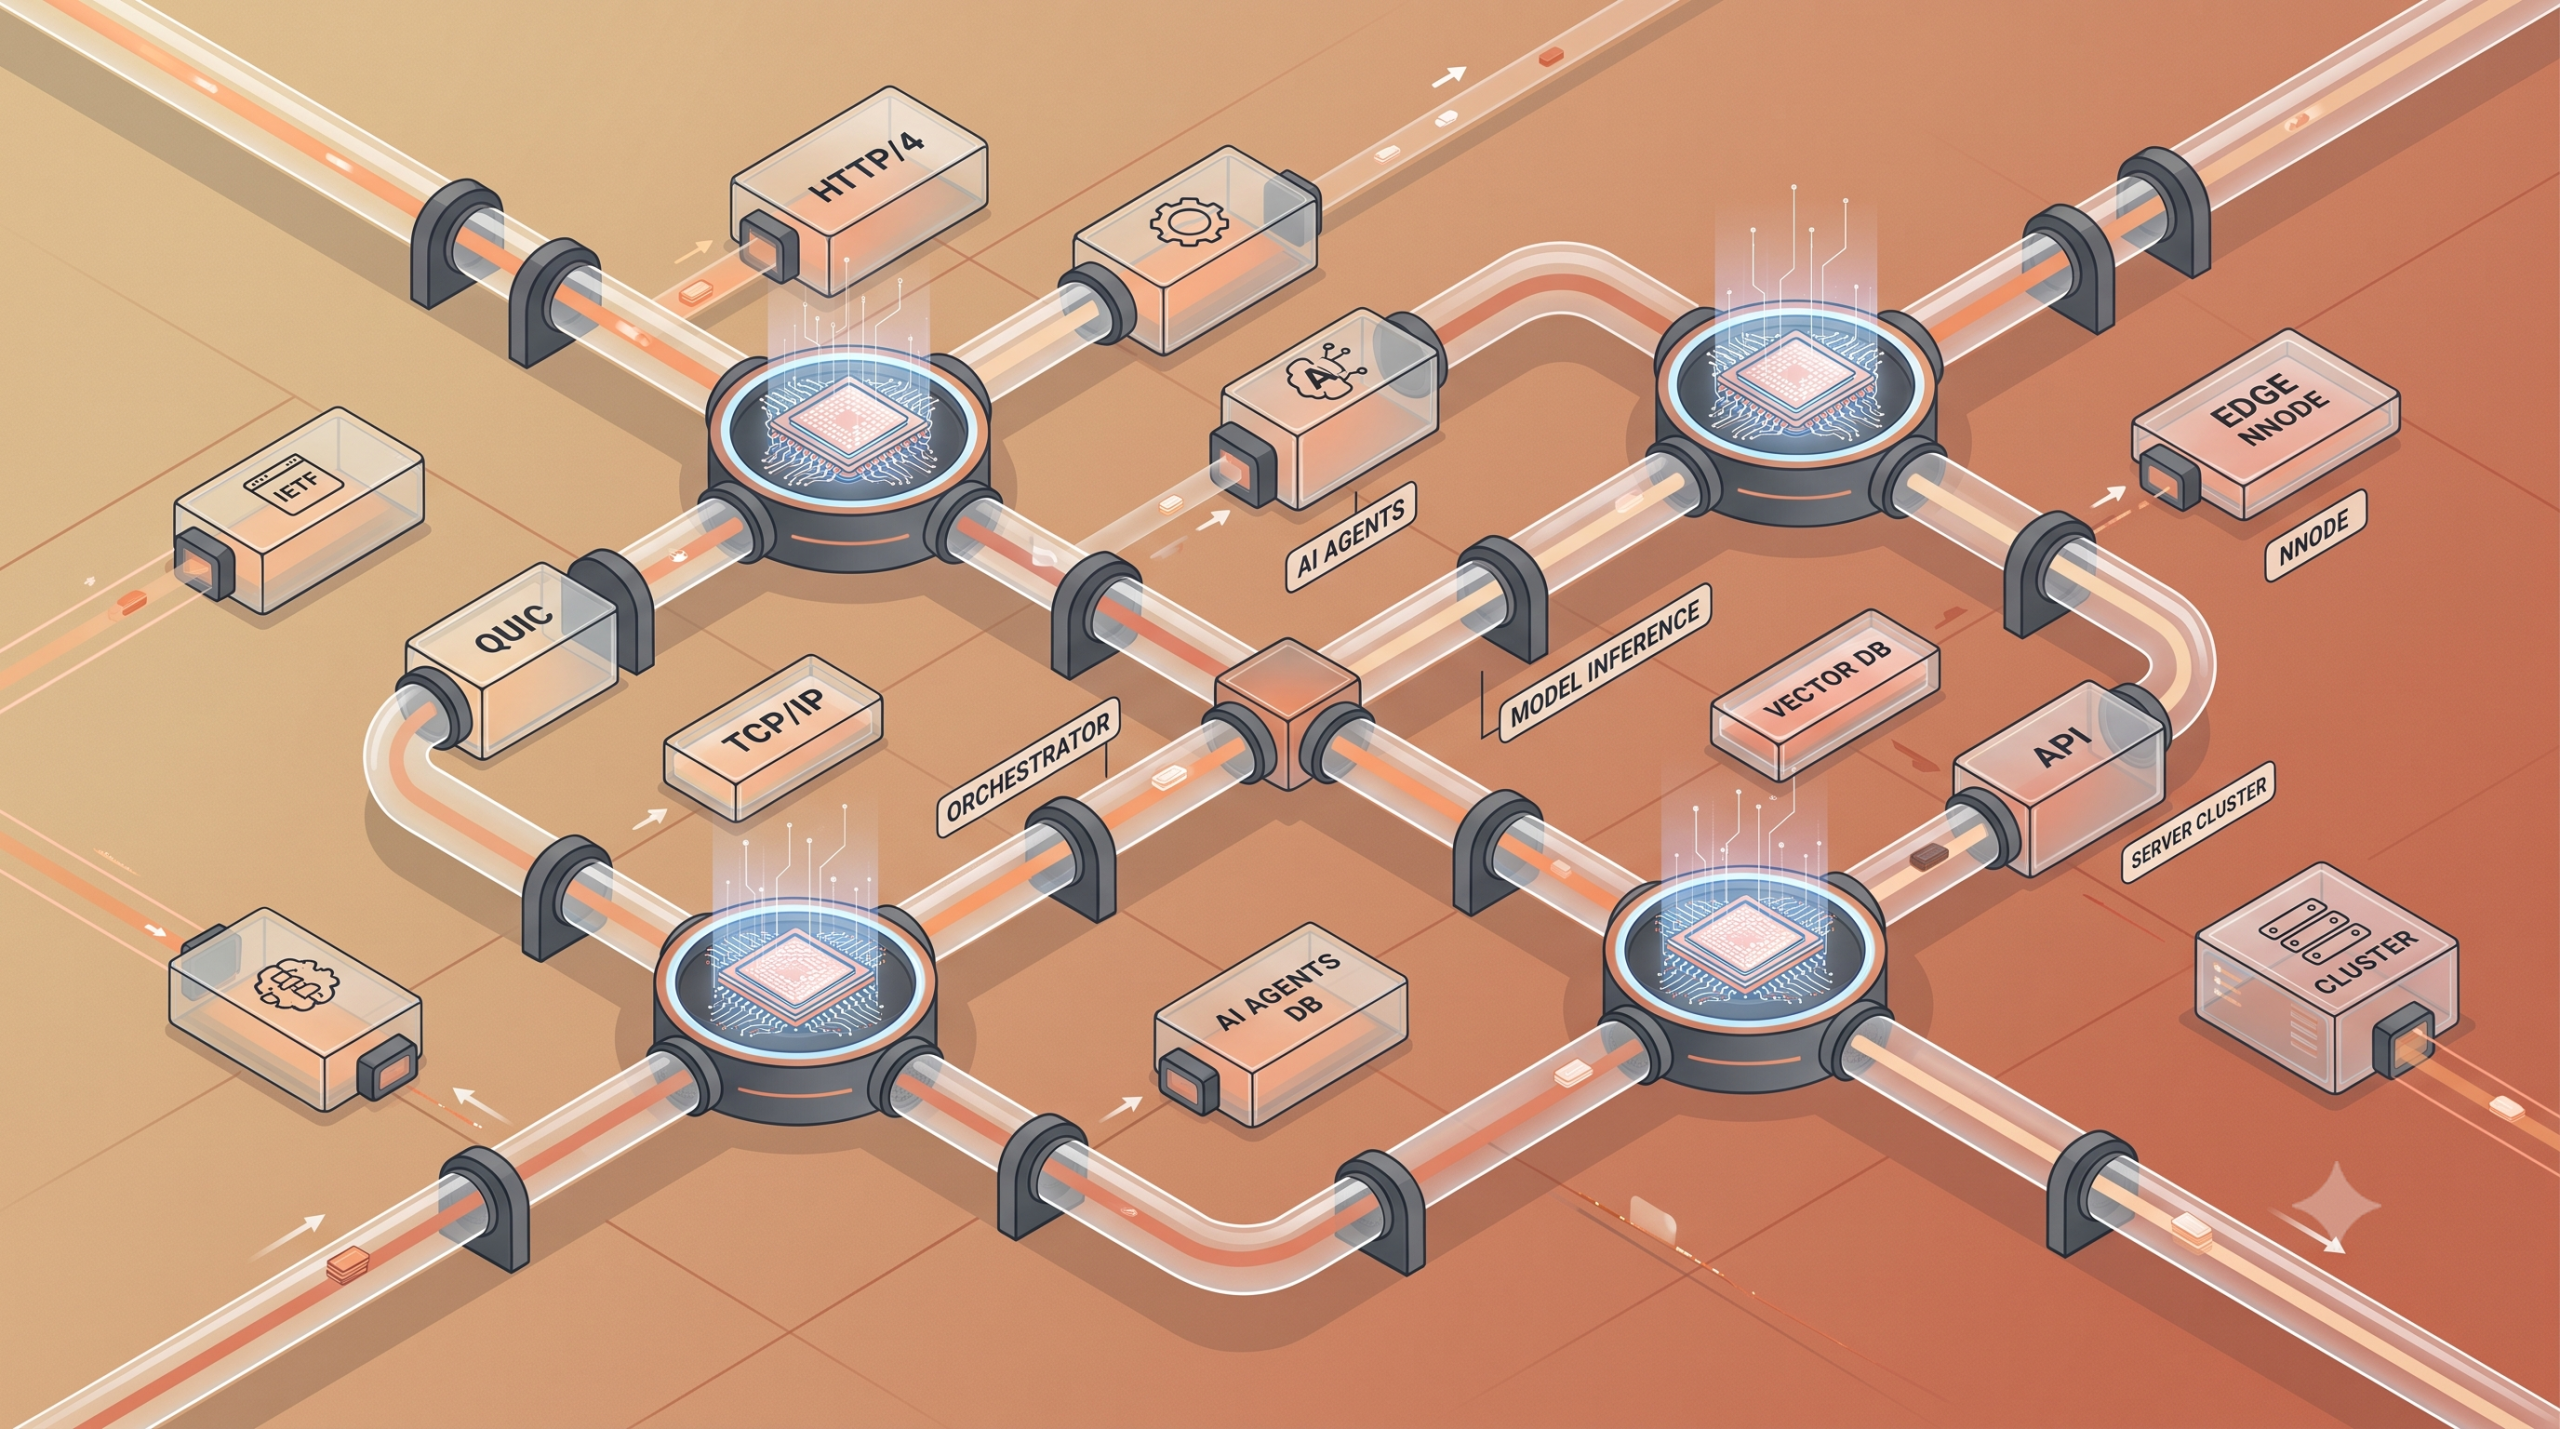
  • ¿Está internet preparado para la IA? El IETF ya diseña el nuevo protocolo HTTP/4

    ¿Está internet preparado para la IA? El IETF ya diseña el nuevo protocolo HTTP/4

    Imagínate que heredas una red de carreteras de los años cincuenta diseñada para que unos pocos camiones repartan leche por el pueblo, y de la noche a la mañana, te toca gestionar una flota de millones de vehículos autónomos hiperactivos que viajan a la velocidad de la luz, cruzando datos en tiempo real y hablando entre ellos en cada esquina. El colapso está garantizado. Pues bien, algo muy parecido le está ocurriendo a las bambalinas de internet. Las infraestructuras de red que heredamos del mundo de las páginas web estáticas y el streaming de vídeo se están empezando a quedar sin aliento. El culpable tiene nombres y apellidos: la explosión de los agentes de inteligencia artificial autónomos y la necesidad de procesar inferencia paralela masiva de forma distribuida por todo el planeta.

    Ante esta tesitura, el grupo de trabajo de ingeniería de Internet (IETF) no se ha quedado de brazos cruzados viendo cómo los servidores echan humo. Ya se han puesto en marcha los primeros borradores oficiales de lo que será el futuro protocolo HTTP/4. Y no, no se trata de una simple actualización de mantenimiento para arañar un par de milisegundos de velocidad al cargar tus fotos de gatitos; estamos ante una reingeniería estructural profunda pensada por y para un ecosistema dominado por modelos de lenguaje y agentes autónomos.

    (más…)
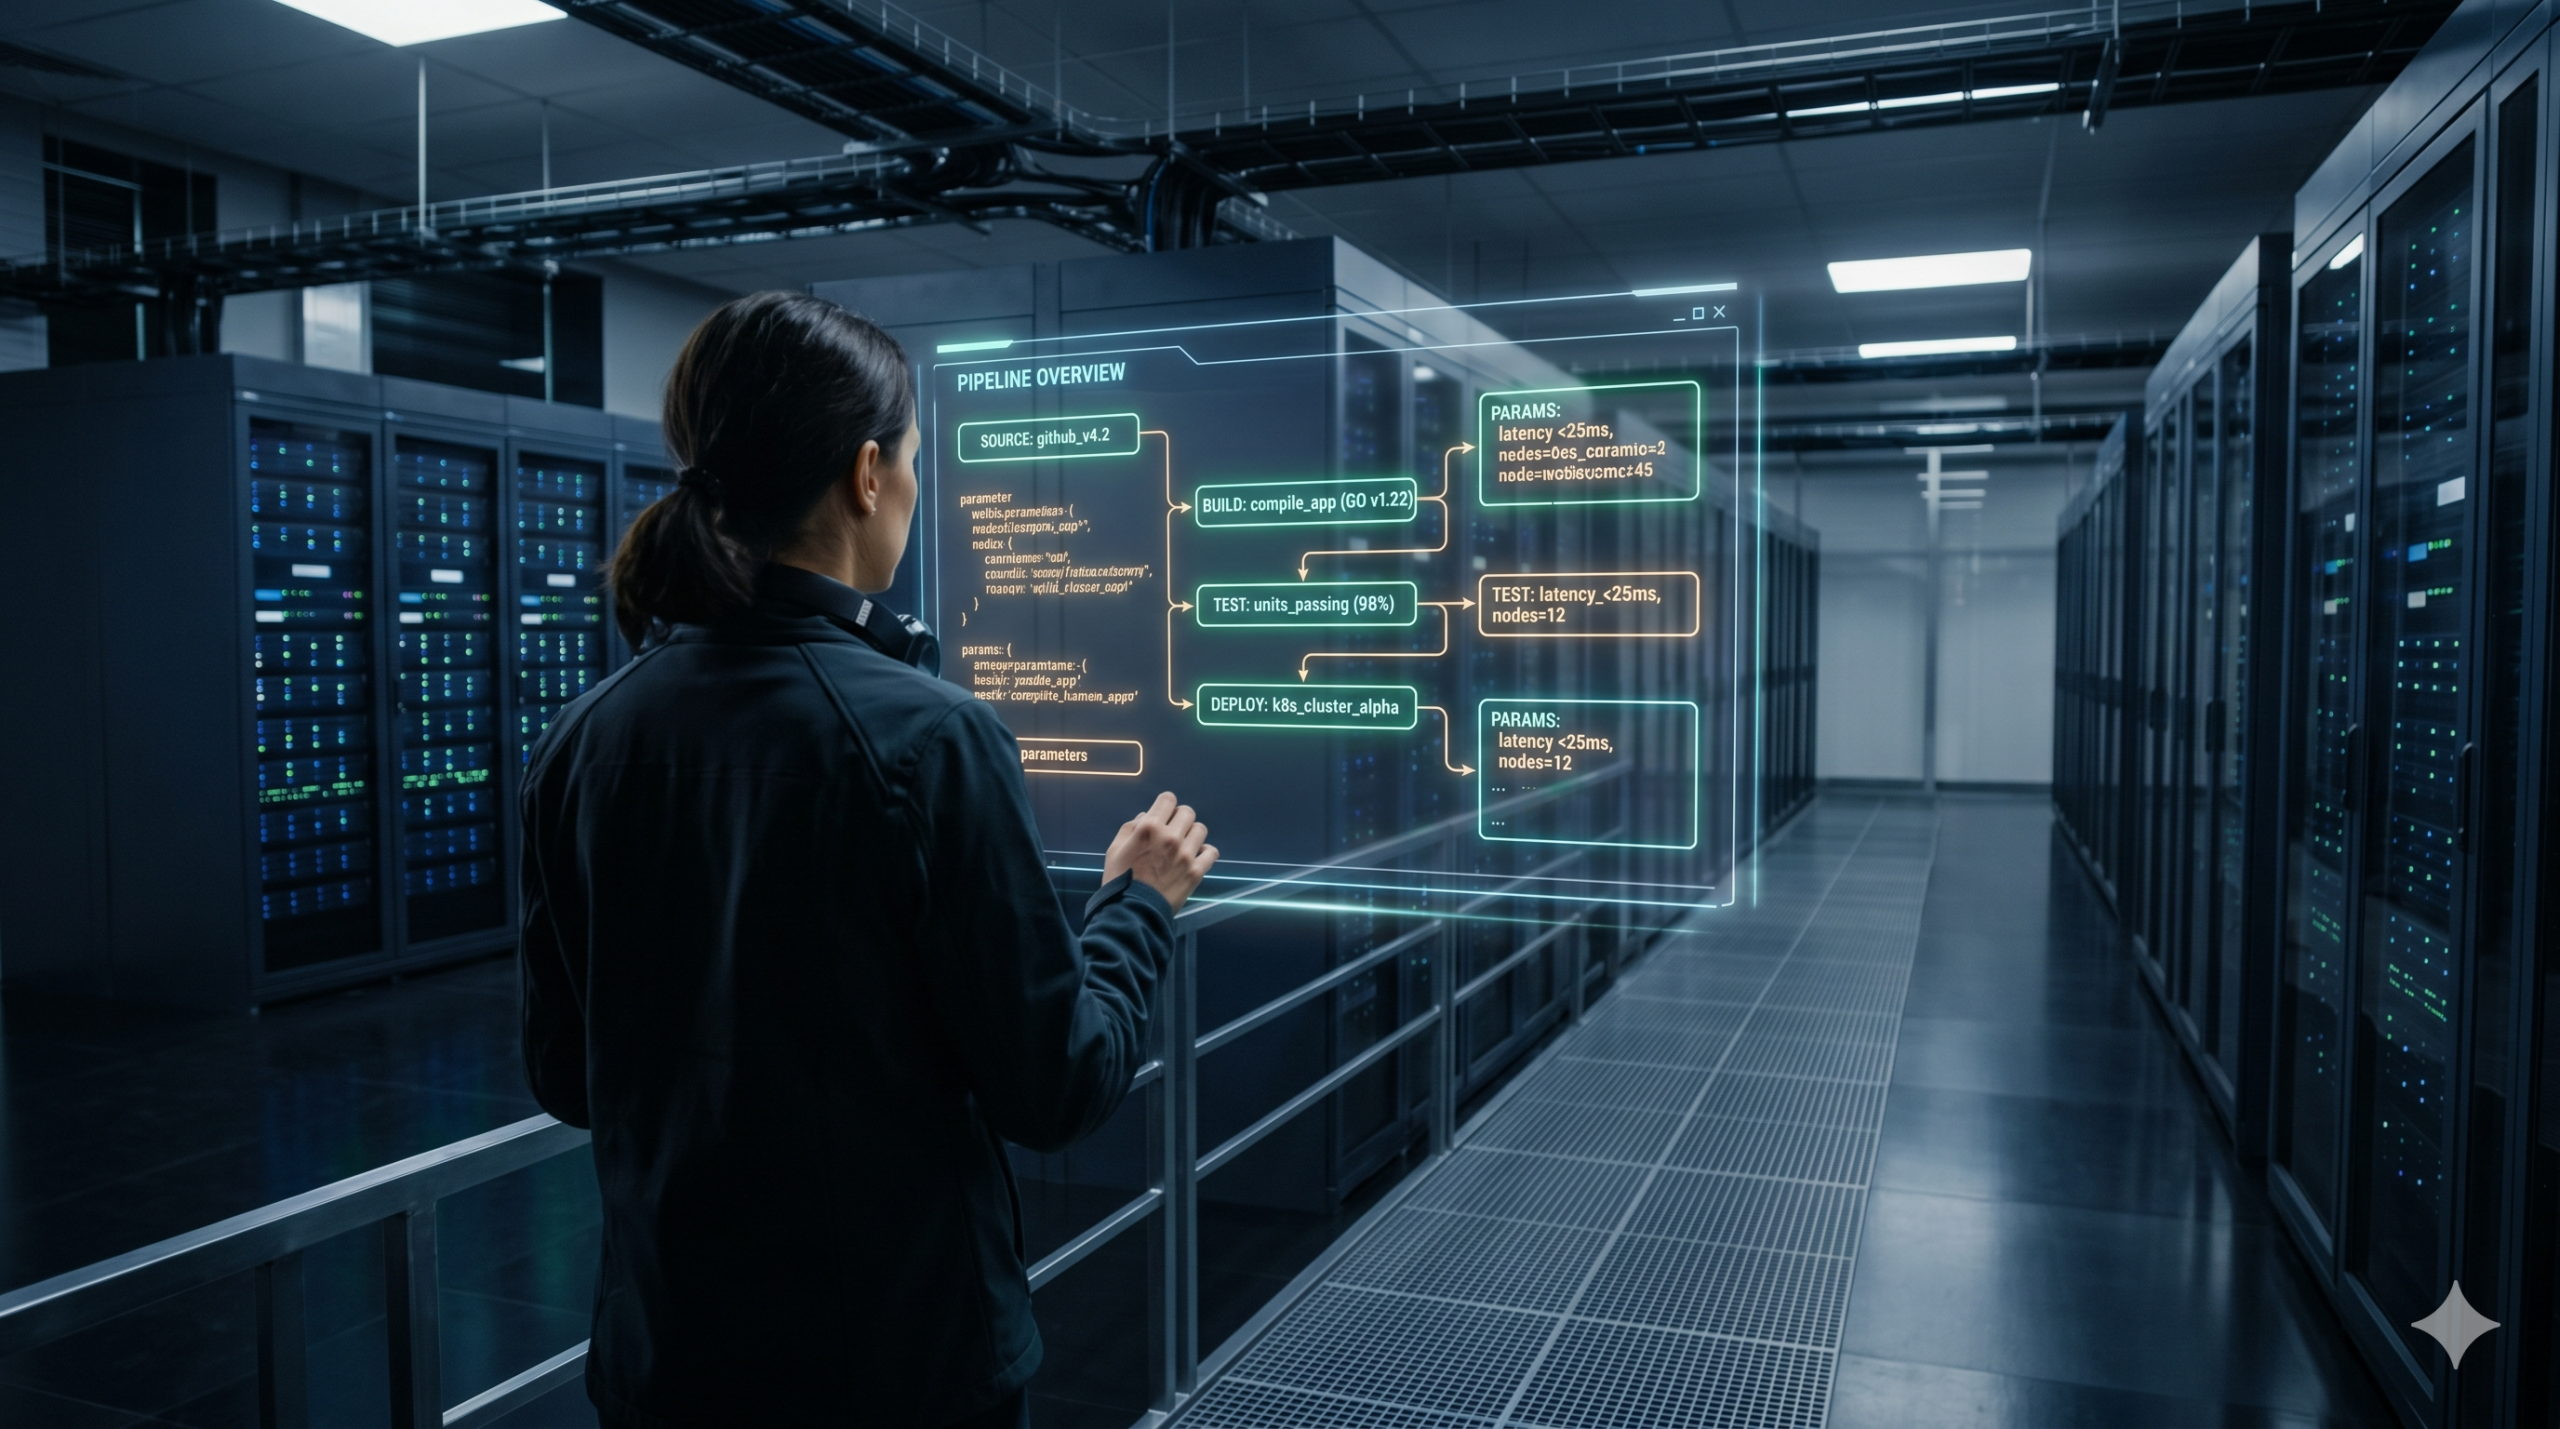
  • El fin de las noches de guardia: Cómo el DevOps predictivo va a salvar tu fin de semana

    El fin de las noches de guardia: Cómo el DevOps predictivo va a salvar tu fin de semana

    Son las siete de la tarde de un viernes. Tienes el código listo, los tests unitarios están en verde y la tentación de pulsar el botón de deploy es casi irresistible. Pero una voz interior, esa que ha nacido de años de café frío y servidores caídos a medianoche, te susurra al oído: «No lo hagas, la producción huele el miedo». Todos hemos estado ahí. La gestión de despliegues ha sido, históricamente, un acto de fe envuelto en scripts de Bash y alarmas de Monitorización. Sabes cómo entra el código en el pipeline, pero nunca estás 100% seguro de cómo va a salir al mundo real. La eterna batalla entre el equipo de desarrollo que quiere innovar rápido y el equipo de operaciones que busca estabilidad sigue provocando fricciones en miles de departamento tecnológicos.

    Afortunadamente, el ecosistema de Integración y Despliegue Continuo (CI/CD) está viviendo su mayor revolución técnica desde la invención de Docker. Estamos pasando de sistemas puramente reactivos —aquellos que se limitan a llorar en un canal de Slack cuando un contenedor entra en bucle de reinicio— a un paradigma completamente nuevo: el DevOps Predictivo. La idea ya no es medir el impacto del desastre una vez que los usuarios empiezan a reportar errores en la pasarela de pago, sino calcular la probabilidad matemática de que tu código rompa la infraestructura antes incluso de que los servidores de integración comiencen a compilar el proyecto.

    (más…)
  • El Temblor de la Nube: La Caída de AWS y la Peligrosa Concentración del Internet Moderno

    El Temblor de la Nube: La Caída de AWS y la Peligrosa Concentración del Internet Moderno

    La Caída de AWS y la Peligrosa Concentración del Internet Moderno

    Cuando el Internet se Concentra Demasiado

    El Problema: La Nube nos prometió flexibilidad y resiliencia, pero ¿y si hemos centralizado el riesgo en tres grandes pilares tecnológicos?

    Imagina que toda la energía de una ciudad dependiera de una única subestación. Si esa subestación falla, el apagón no es parcial; es total. Eso es precisamente lo que experimentamos cuando una de las grandes infraestructuras de Cloud Computing tropieza. Hace apenas unas semanas, un fallo masivo en la región US-EAST-1 de Amazon Web Services (AWS) —el nervio central de la nube de Amazon— paralizó una porción enorme del ecosistema digital global. Plataformas de streaming, e-commerce, sistemas financieros y hasta dispositivos de smart home cayeron en un efecto dominó que duró horas. El incidente no solo generó pérdidas económicas incalculables; nos recordó la vulnerabilidad que acarrea la extrema dependencia de un puñado de gigantes tecnológicos.

    El Dominó Técnico Detrás del Desastre

    El Contexto: La complejidad del DNS y el DynamoDB en el corazón de un fallo en cascada.

    Para que entendamos qué se rompió, debemos ir a la sala de máquinas. La causa raíz, según el informe post-mortem de AWS, no fue un ataque externo ni un fallo de hardware. Fue algo más sutil y, a la vez, más insidioso: un error en el software de automatización relacionado con el sistema de resolución DNS (Sistema de Nombres de Dominio) de DynamoDB en la región de Virginia.

    Para el profano, el DNS es la guía telefónica del internet. Los servicios que dependen de DynamoDB —una base de datos clave de AWS utilizada internamente por muchísimos otros servicios— no pudieron encontrar las direcciones IP correctas. Es como si el sistema de navegación de todos los camiones de reparto de una ciudad se estropeara simultáneamente: el tráfico sigue existiendo, pero nadie sabe dónde ir.

    El fallo se convirtió rápidamente en una falla en cascada (o cascading failure). DynamoDB, al fallar, afectó a servicios esenciales como EC2 (servidores virtuales), SQS (colas de mensajes) y Lambda (funciones sin servidor). Estos servicios son los ladrillos fundamentales de miles de empresas. La dependencia interna de los propios servicios de AWS en sus otros componentes de «capa uno» amplificó el problema hasta proporciones globales. El sistema no supo autocorregrirse, requiriendo intervención manual, lo que disparó el tiempo de inactividad.

    Solución – Diversificación y Resiliencia Distribuida

    La Solución: Más allá de «usar la nube», el reto es diseñar la resiliencia dentro de ella, o incluso fuera de ella.

    ¿Cómo evitamos que la caída de un único centro de datos en Virginia tumbe media internet? Los expertos en sistemas distribuidos llevamos años predicando la redundancia y la diversificación. Las empresas tienen dos caminos principales para mitigar este «riesgo de concentración»:

    1. Arquitectura Multi-Región: El primer paso es diseñar las aplicaciones para operar activamente en múltiples regiones geográficas de un mismo proveedor (cloud). Si US-EAST-1 falla, el tráfico se redirige automáticamente, o incluso se reparte activamente, a US-WEST-2 o Europa. Esto requiere una programación avanzada, clusters de bases de datos replicados y balanceadores de carga inteligentes, pero garantiza la continuidad operativa.
    2. Estrategia Multi-Cloud: La opción más robusta y compleja es la arquitectura Multi-Cloud. Esto implica utilizar a propósito varios proveedores (AWS, Azure, Google Cloud) para diferentes partes de la infraestructura. Si AWS cae, los servicios críticos pueden seguir operando en Azure. Este enfoque requiere dominar múltiples frameworks y enfrentarse a los altos costos de la «tasa de egreso de datos» (el coste de sacar datos de la nube de un proveedor), un mecanismo que a veces funciona como un candado (vendor lock-in).

    Este incidente subraya la necesidad de que los desarrolladores y arquitectos cloud abandonen la comodidad del proveedor único y asuman la responsabilidad de diseñar sistemas que, aunque estén en la nube, sean intrínsecamente descentralizados y tolerantes a fallos.

    La Fragilidad de la Interconexión y el Rol del Programador

    El Impacto: El incidente es un recordatorio ético y práctico para los líderes tecnológicos.

    Este apagón nos deja varias reflexiones cruciales, que van más allá del rigor técnico. La extrema dependencia de tres gigantes (AWS, Azure, Google Cloud) no es solo un riesgo de uptime; es un riesgo de soberanía digital y competencia. Si solo tres entidades controlan la infraestructura base, el poder que ostentan sobre startups y gobiernos es inmenso.

    Para nosotros, los profesionales informáticos, el takeaway es claro: la fiabilidad del código y la resiliencia de la arquitectura son más valiosas que nunca. No basta con desplegar en la nube; hay que saber cómo y dónde desplegar.

    “Una arquitectura monolítica en la nube es como cambiar un edificio de ladrillo por un rascacielos de cristal; se ve moderno y ágil, pero un solo punto débil lo rompe todo.”

    El evento de AWS es una lección de humildad para el sector, que nos obliga a reexaminar la automatización ciega y a reforzar las defensas contra lo que parecía impensable: el fallo interno de la infraestructura digital más robusta del planeta.

    ¿Cómo tienes configurada la resiliencia de tus proyectos? ¿Confías plenamente en el auto-healing de un único proveedor, o ya estás experimentando con estrategias Multi-Cloud?

    Aquí puedes revisar el análisis detallado del fallo de AWS (en inglés) si quieres bucear en el informe técnico. Te animo a compartir tu experiencia: ¿qué alternativa cloud consideras más preparada para un desastre global? ¡Te leo en los comentarios!