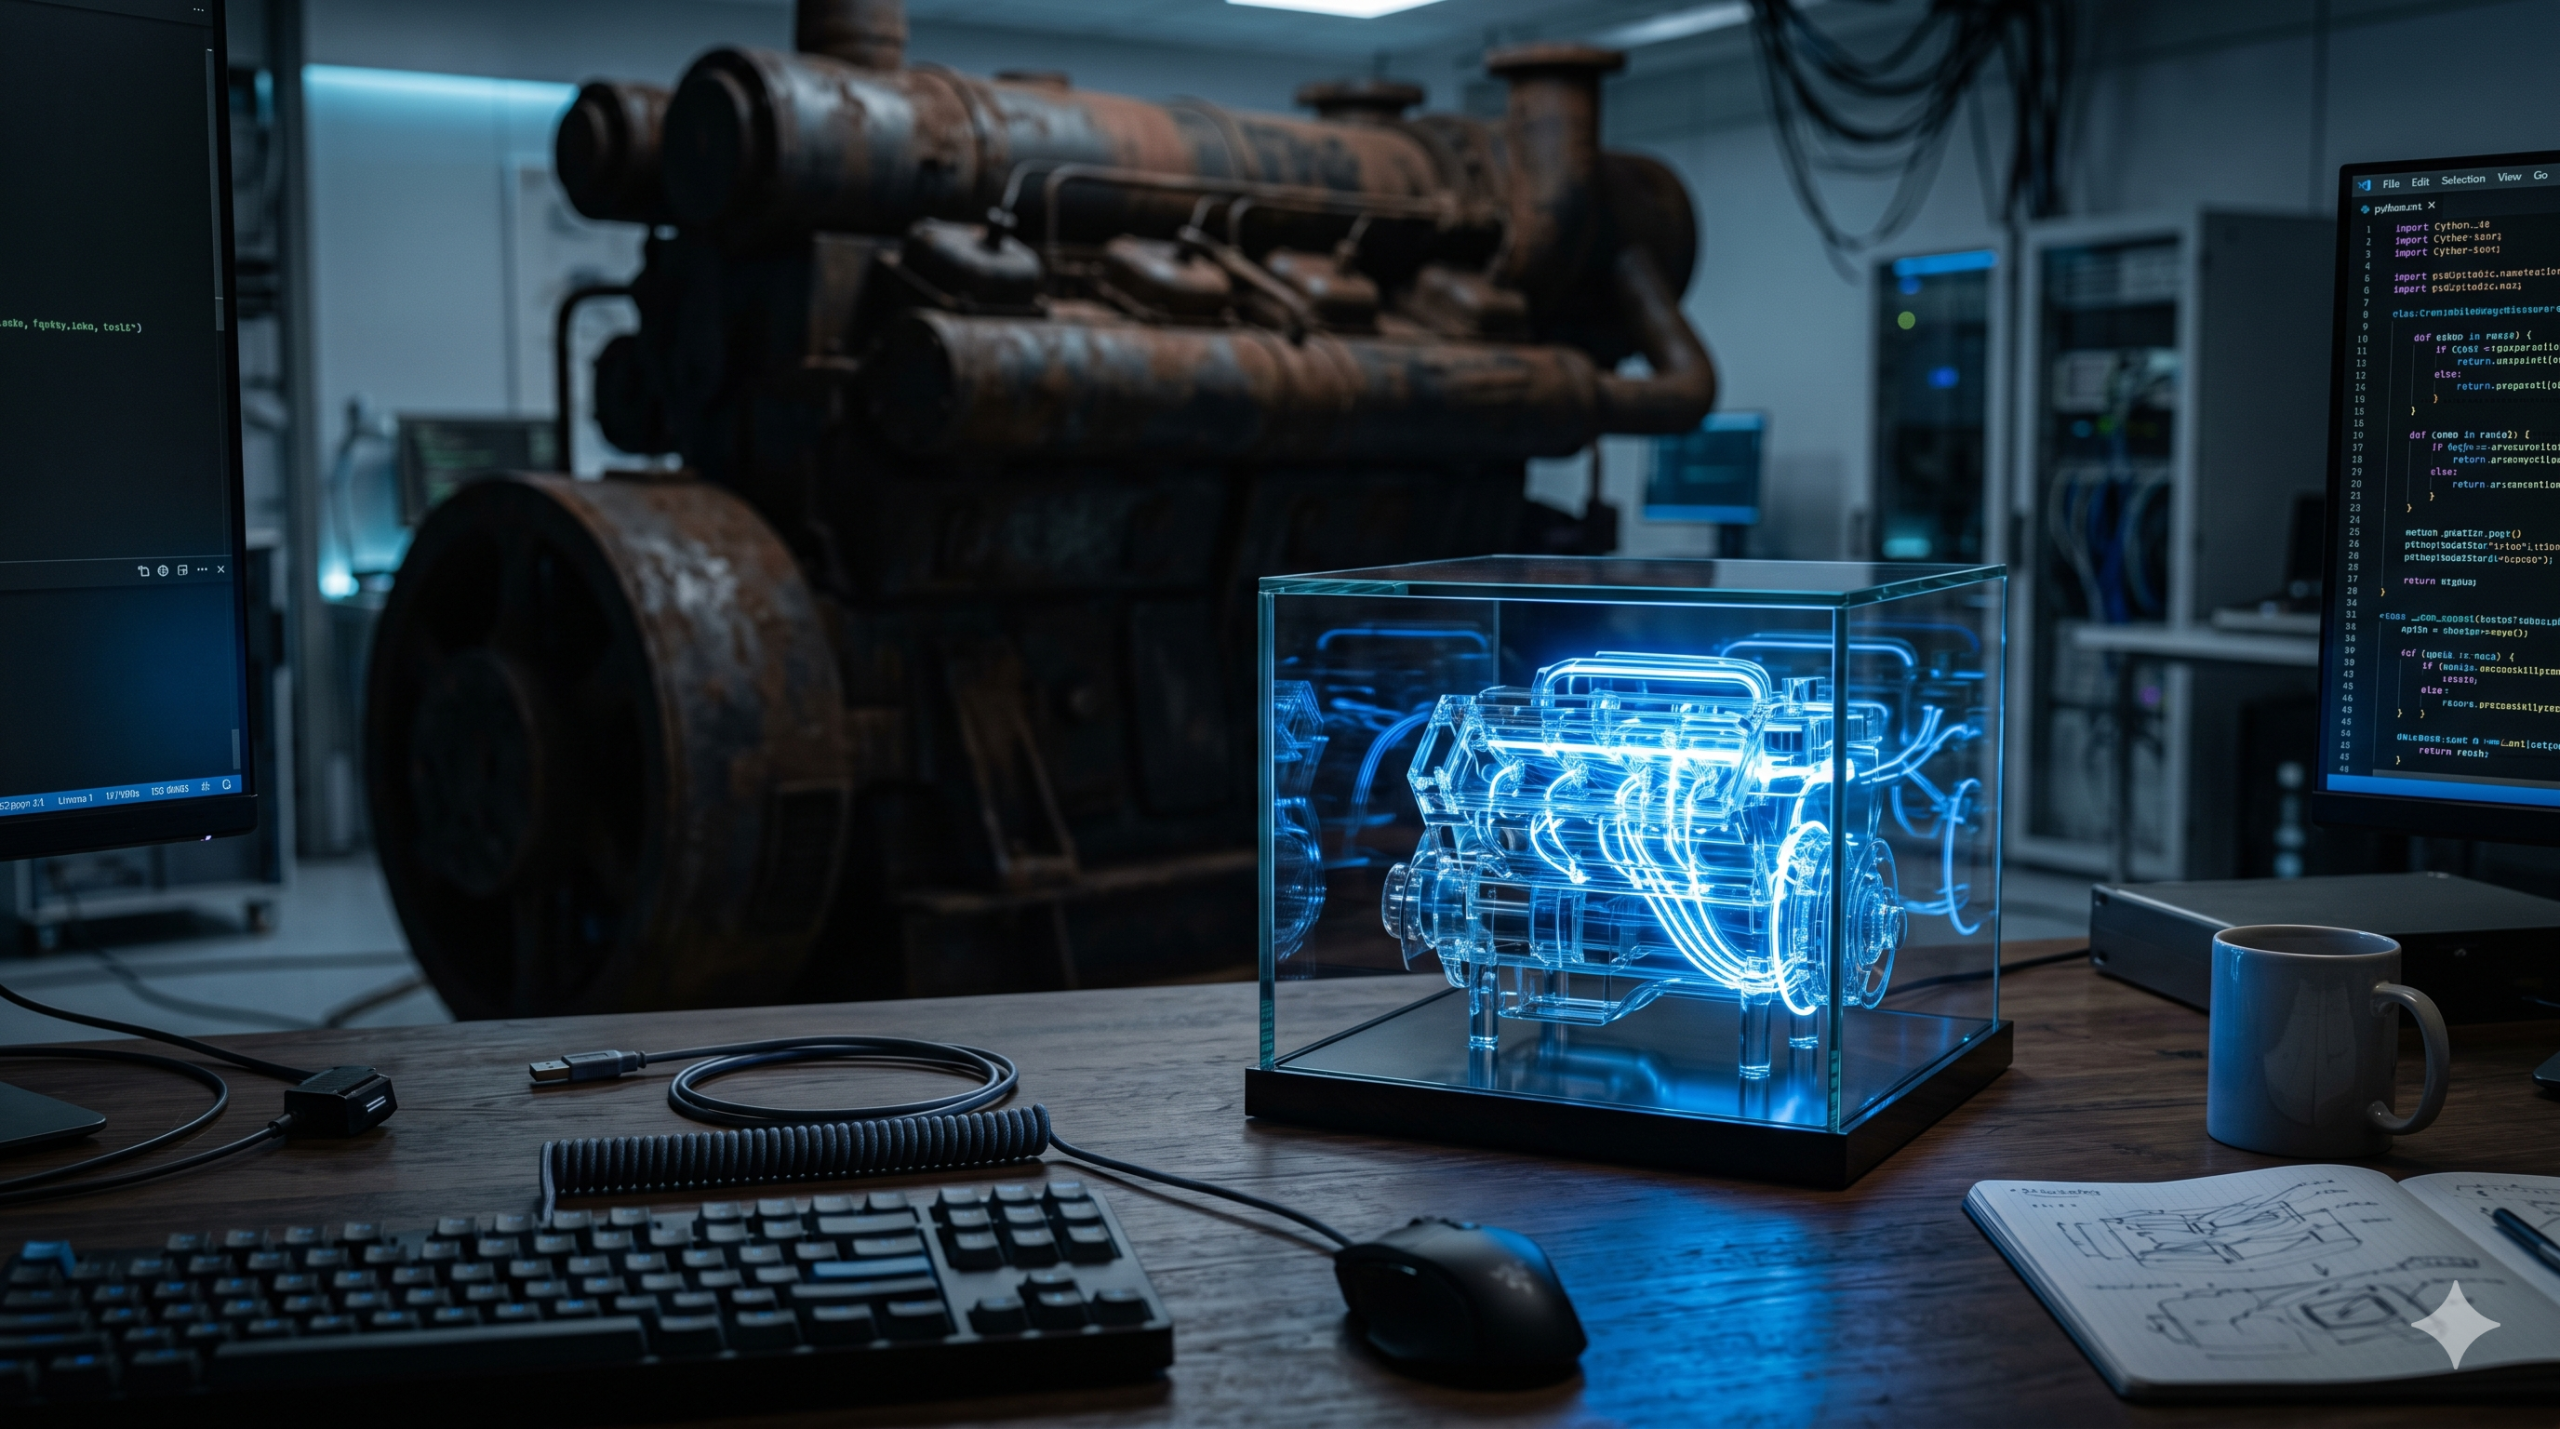
Hubo un tiempo, allá por 2023 o 2024, en el que la industria de la Inteligencia Artificial parecía una competición de gimnasio: «¿Cuántos billones de parámetros tiene tu modelo?». La respuesta corta era «muchos», y la solución a cualquier problema de rendimiento era, invariablemente, inyectar más GPUs y más petabytes de datos extraídos de los rincones más oscuros de internet. Sin embargo, algo ha cambiado en los laboratorios de computación este 2026. Hemos descubierto que alimentar a una IA con todo Reddit es como intentar formar a un científico dándole de comer solo comida rápida: obtendrás volumen, pero no necesariamente inteligencia.
El mito del gigantismo: Cuando los parámetros estorban
El contexto técnico es fascinante. Durante años, nos obsesionamos con la ley de escalado (Scaling Laws), que sugería una correlación casi lineal entre la potencia de cómputo, el tamaño del dataset y la «inteligencia» resultante. Pero nos topamos con un muro: el colapso del modelo. Al entrenar modelos con datos generados por otras IAs, la calidad empezó a degradarse. Los modelos se volvían redundantes, propensos a alucinaciones creativas pero inútiles para el razonamiento lógico.
Aquí es donde entra el Small-Scale Training. La premisa es simple pero técnica: en lugar de un modelo de 1.7 billones de parámetros, estamos viendo arquitecturas de apenas 7 o 10 billones de parámetros que rinden igual o mejor en tareas de lógica, matemáticas y programación. ¿El secreto? No es el tamaño del motor, sino el octanaje del combustible.
Datos de «etiqueta negra»: La curación es el nuevo código
La solución que está revolucionando el sector no es algorítmica, sino curativa. Los ingenieros están utilizando técnicas de Deduplicación Semántica y Filtrado de Alta Fidelidad. En lugar de usar 10 trillones de tokens de texto genérico, se seleccionan 500 billones de tokens de alta calidad técnica.
- Eficiencia Energética: Modelos que corren en una sola GPU doméstica.
- Inferencia Paralela: Velocidad de respuesta multiplicada por diez.
- Menor Alucinación: Precisión quirúrgica en entornos técnicos.
Es como pasar de un motor V12 que consume 30 litros a los 100, a un motor eléctrico ultraeficiente. Ambos te llevan a la misma velocidad, pero uno no necesita una central eléctrica propia para funcionar.
El impacto en nuestro flujo de trabajo
Para nosotros, los que picamos código y configuramos sistemas, esto es una bendición. Significa que pronto podremos tener un asistente de IA corriendo en local, bajo nuestro control total, que realmente entienda la arquitectura de microservicios que estamos montando. Ya no necesitamos que la IA sepa escribir un poema; necesitamos que encuentre ese leak de memoria en Docker.
La democratización de la IA no vendrá de modelos más grandes, sino de modelos más listos que quepan en nuestro bolsillo. Estamos pasando de la «IA de fuerza bruta» a la «IA de precisión». Y sinceramente, ya era hora de que aplicáramos el principio KISS a las redes neuronales.
¿Habéis probado ya a ejecutar estos modelos en vuestras máquinas? La diferencia en latencia es para saltar una lágrima de alegría. Contadme en los comentarios si habéis logrado que vuestra GPU local supere a la API de turno.
Deja una respuesta