Etiqueta: Machine Learning

  • Un sistema de IA aprende a jugar a juegos de mesa antiguos sin conocer las reglas

    Un sistema de IA aprende a jugar a juegos de mesa antiguos sin conocer las reglas

    Imagina que te sientan frente a un tablero de madera gastado, con fichas de formas extrañas dispuestas de manera misteriosa. Nadie te explica cómo se mueven, cuál es el objetivo ni qué significan los símbolos grabados en los bordes. Simplemente te dicen: «Juega». Para un ser humano esto suena a pesadilla kafkiana, pero para un sistema de IA moderno es el tipo de reto de ingeniería que nos hace saltar de la silla con una sonrisa.

    Recientemente, un equipo de investigadores ha logrado algo sorprendente: un modelo basado en aprendizaje por refuerzo profundo ha sido capaz de deducir las reglas completas y la estrategia óptima de juegos de mesa milenarios a partir de la observación pasiva de partidas grabadas sin etiquetar. No había un archivo de configuración con los movimientos válidos, no había una función de evaluación explícita ni un árbitro digital corrigiendo los fallos. El algoritmo simplemente miró las secuencias, identificó las restricciones subyacentes y acabó dominando la partida mejor que los propios historiadores.

    (más…)
  • El purgatorio de las Demos: Por qué solo el 25% de los proyectos de Inteligencia Artificial llegan a producción

    El purgatorio de las Demos: Por qué solo el 25% de los proyectos de Inteligencia Artificial llegan a producción

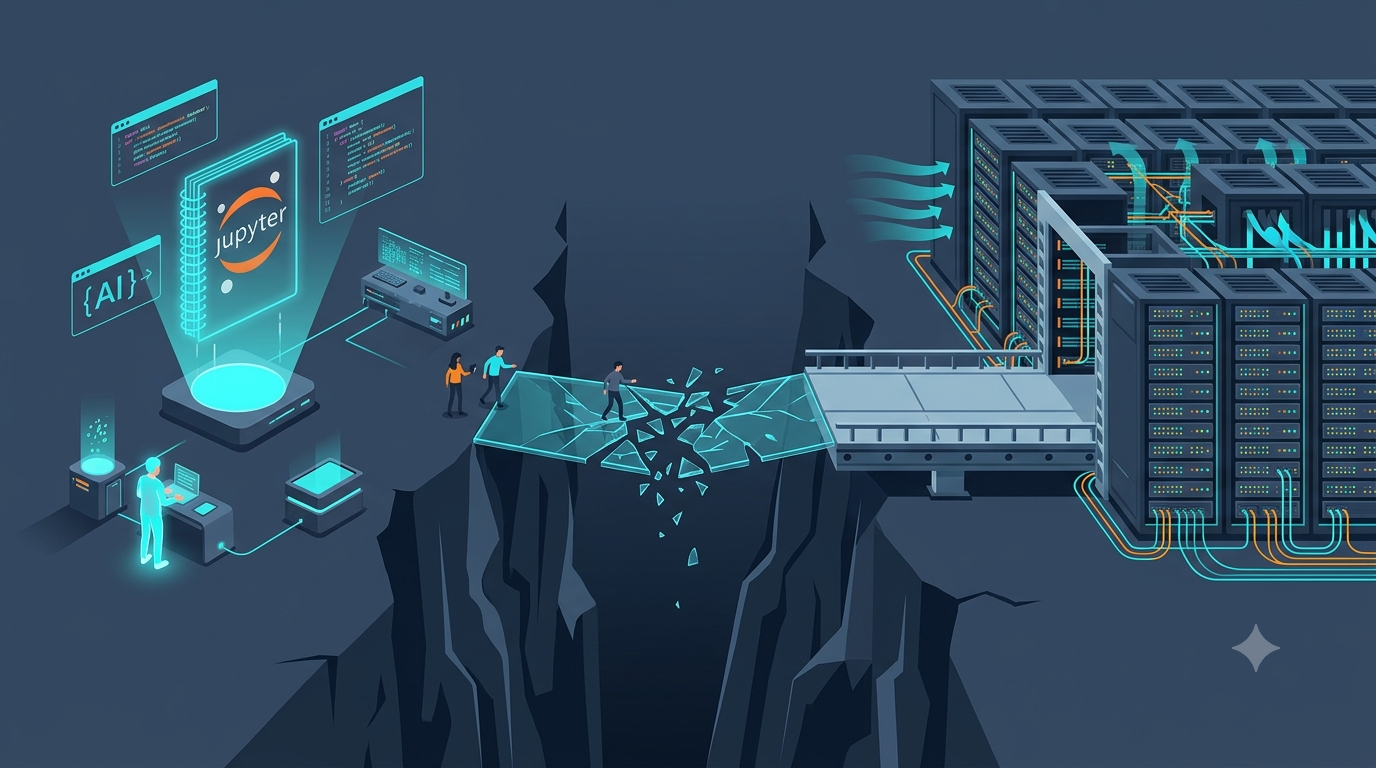
    Imagine la escena: un equipo de ciencia de datos presenta emocionado una prueba de concepto (PoC) interna. El prototipo responde preguntas sobre documentación corporativa con una precisión matemática casi mágica, el comité de dirección aplaude y el presupuesto para su implementación obtiene luz verde de inmediato. Sin embargo, seis meses después, la herramienta yace abandonada en un servidor de pruebas, las incidencias se multiplican y el proyecto se cancela silenciosamente.

    Esta historia no es una excepción; es la norma. Diversos estudios sectoriales y análisis recientes de firmas como Gartner y la RAND Corporation revelan una realidad incómoda para el sector tecnológico: entre el 75% y el 85% de las iniciativas piloto de inteligencia artificial jamás logran cruzar la frontera hacia un entorno de producción real. En otras palabras, solo uno de cada cuatro proyectos sobrevive al choque directo con la realidad corporativa.

    ¿Por qué existe un abismo tan profundo entre un bot funcional en un script local y un sistema en producción capaz de atender a miles de usuarios simultáneos? La respuesta corta es que entrenar o ajustar un modelo es un problema de Ciencia de Datos, pero operar un sistema inteligente, confiable y escalable es, en un 90%, un problema complejo de Ingeniería de Software, infraestructura y DevOps.

    (más…)
  • ¿Pueden los algoritmos tener curiosidad? La revolución de las IA que diseñan sus propios experimentos científicos

    ¿Pueden los algoritmos tener curiosidad? La revolución de las IA que diseñan sus propios experimentos científicos

    Vivimos en una época maravillosa para la informática, pero reconozcámoslo: hasta ahora, nuestros flamantes modelos de lenguaje se han comportado como becarios increíblemente rápidos y sabelotodo, pero un tanto pasivos. Les pides un script en Python, te lo dan; les pides resumir un informe, lo hacen. Sin embargo, carecen de iniciativa propia. En el ámbito de la investigación científica, el cuello de botella actual no es la falta de potencia de cálculo ni el almacenamiento en la nube, sino el factor humano. Diseñar hipótesis válidas, estructurar experimentos químicos o biológicos sin dar palos de ciego y descartar callejones sin salida consume años de trabajo y recursos millonarios. El verdadero problema del desarrollo científico tradicional es que la mente humana, aunque brillante, avanza a velocidad analógica en un universo de datos que ya es puramente digital. ¿Cómo podemos acelerar el descubrimiento de nuevos materiales o fármacos si los investigadores pasan más tiempo diseñando la logística del ensayo que analizando resultados?

    (más…)
  • ¿Más grande es siempre mejor? El ascenso de la IA «minimalista» y la muerte del dato basura

    ¿Más grande es siempre mejor? El ascenso de la IA «minimalista» y la muerte del dato basura

    Hubo un tiempo, allá por 2023 o 2024, en el que la industria de la Inteligencia Artificial parecía una competición de gimnasio: «¿Cuántos billones de parámetros tiene tu modelo?». La respuesta corta era «muchos», y la solución a cualquier problema de rendimiento era, invariablemente, inyectar más GPUs y más petabytes de datos extraídos de los rincones más oscuros de internet. Sin embargo, algo ha cambiado en los laboratorios de computación este 2026. Hemos descubierto que alimentar a una IA con todo Reddit es como intentar formar a un científico dándole de comer solo comida rápida: obtendrás volumen, pero no necesariamente inteligencia.

    (más…)
  • ¿El fin del Prompt Engineering? Por qué los modelos de lenguaje están empezando a ignorar tus instrucciones

    ¿El fin del Prompt Engineering? Por qué los modelos de lenguaje están empezando a ignorar tus instrucciones

    Apenas habíamos terminado de aprender que para que una IA nos hiciera caso debíamos hablarle como si fuera un becario muy literal, rodeando nuestras peticiones de contexto, roles psicológicos y amenazas veladas de «esto es importante para mi carrera», cuando el suelo bajo nuestros pies ha vuelto a moverse. Resulta que la habilidad de redactar prompts kilométricos —esa disciplina que algunos ya llamaban pomposamente «ingeniería»— podría tener los días contados. No porque la IA haya dejado de necesitarlos, sino porque está empezando a escribirlos mejor que nosotros, y lo que es más inquietante: dentro de su propio proceso de pensamiento.

    (más…)
  • El Canibalismo Digital: ¿Qué pasa cuando la IA se queda sin humanos a los que leer?

    El Canibalismo Digital: ¿Qué pasa cuando la IA se queda sin humanos a los que leer?

    Imagínate que decides alimentarte exclusivamente de fotocopias de fotocopias de una receta de tarta de manzana. Al principio, la tarta está rica. En la décima iteración, el azúcar parece sal. En la centésima, lo que tienes entre manos no es un postre, sino un amasijo de pixeles borrosos sin sabor a nada. Este fenómeno, que en el mundillo técnico empezamos a conocer como Model Collapse (colapso del modelo), es el gran muro invisible contra el que la inteligencia artificial generativa está a punto de chocar.

    (más…)
  • ¿Tu IDE te está juzgando? La llegada de la IA que detecta el «Code Smell» antes de que pulses una tecla

    ¿Tu IDE te está juzgando? La llegada de la IA que detecta el «Code Smell» antes de que pulses una tecla

    Imagínate la escena: son las siete de tarde, llevas cinco cafés encima y estás a punto de implementar un singleton global porque «es lo más rápido» para pasar esos datos al componente Z. Tu mano vuela hacia el teclado, pero antes de que termines la primera línea, tu editor de código se pone rojo, suena un sutil suspiro electrónico y una notificación te dice: «No lo hagas, Borja. Sabemos que ese acoplamiento te va a costar tres fines de semana de refactorización en junio». No es ciencia ficción ni un fantasma en la máquina; es la nueva generación de extensiones para VS Code basadas en modelos de inferencia de flujo de pensamiento.

    (más…)
  • ¿El fin del «Junior» o el nacimiento del Programador Aumentado? El fenómeno Devin

    ¿El fin del «Junior» o el nacimiento del Programador Aumentado? El fenómeno Devin

    Imagina que un lunes por la mañana, después de tu tercer café, le pasas un enlace de un repositorio de GitHub con un par de bugs de esos que dan dolor de cabeza a una IA y le dices: «Arréglalo, despliégalo y avísame cuando esté en producción». Lo normal es que ChatGPT te devuelva un trozo de código que, con suerte, compila. Pero Devin no es «lo normal». Devin se pone manos a la obra, abre el navegador, consulta la documentación, escribe el código, lo testea en su propia consola y, si algo falla, depura el error hasta que funciona. Todo esto sin que tú hayas movido un dedo del ratón.

    (más…)
  • Más allá del SQL: Por qué las Bases de Datos Vectoriales son el nuevo cerebro de la IA

    Más allá del SQL: Por qué las Bases de Datos Vectoriales son el nuevo cerebro de la IA

    ¿Alguna vez has intentado explicarle a una base de datos relacional convencional cómo se «siente» una puesta de sol o por qué una línea de código es similar a otra aunque usen sintaxis distintas? Si lo intentas con SQL, probablemente acabes con un error de sintaxis o una consulta eterna que no lleva a ninguna parte. El problema es que nuestras bases de datos tradicionales son expertas en datos estructurados (filas y columnas), pero la Inteligencia Artificial necesita algo más: necesita contexto semántico.

    (más…)
  • FastAPI en 2025: ¿Por qué medio mundo está migrando sus APIs al «rayo» de Python?

    FastAPI en 2025: ¿Por qué medio mundo está migrando sus APIs al «rayo» de Python?

    Históricamente, los programadores de Python hemos aceptado un trato con el diablo: te damos una sintaxis legible y una productividad asombrosa, a cambio de que no nos pidas la velocidad de ejecución de C++ o Go. Durante años, Django y Flask fueron los pilares de la web, pero el mundo de los microservicios y la inteligencia artificial empezó a pedir algo más. En este contexto, un desarrollador llamado Sebastián Ramírez (tiangolo) decidió que no teníamos por qué elegir entre velocidad y elegancia. Así nació FastAPI, un framework que en apenas unos años ha logrado lo impensable: superar en estrellas de GitHub a veteranos como Flask y convertirse en el estándar de facto para desplegar modelos de IA.

    (más…)