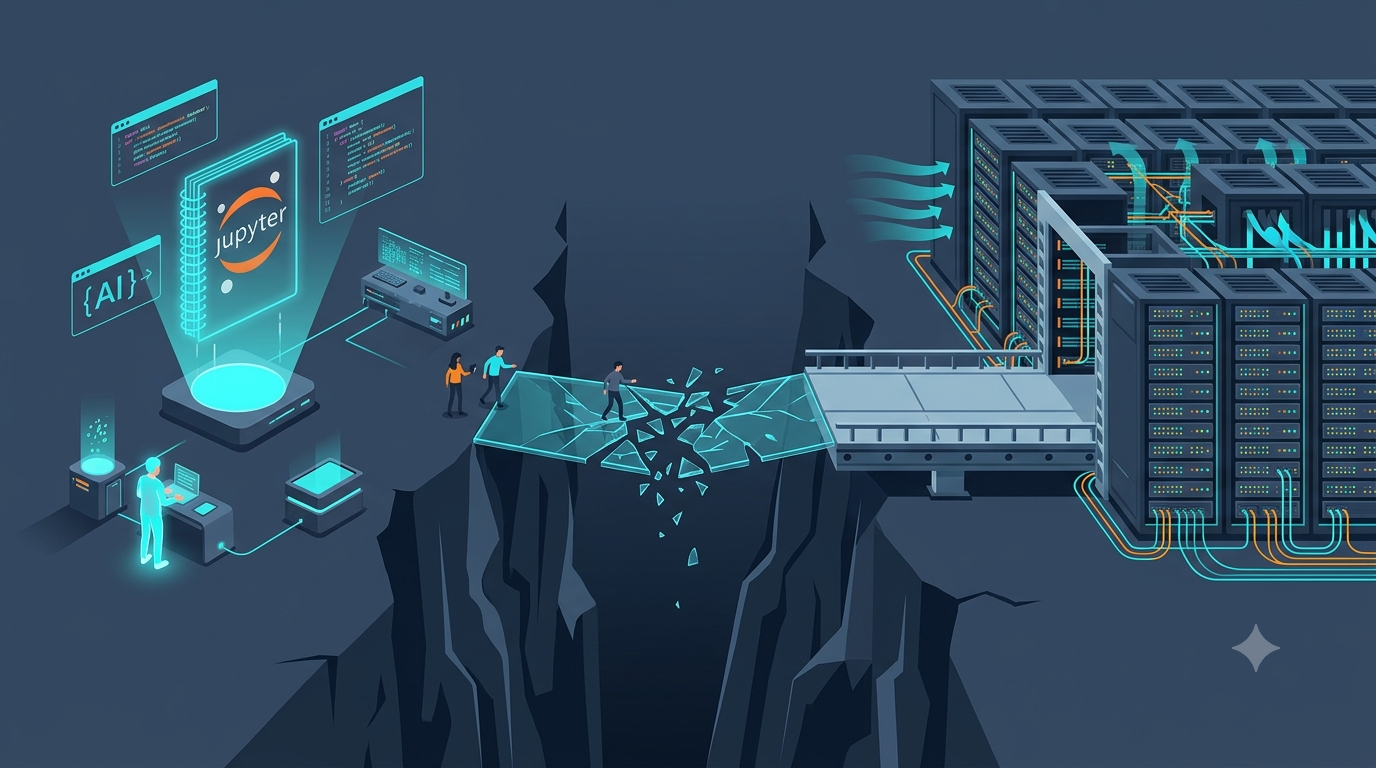
Imagine la escena: un equipo de ciencia de datos presenta emocionado una prueba de concepto (PoC) interna. El prototipo responde preguntas sobre documentación corporativa con una precisión matemática casi mágica, el comité de dirección aplaude y el presupuesto para su implementación obtiene luz verde de inmediato. Sin embargo, seis meses después, la herramienta yace abandonada en un servidor de pruebas, las incidencias se multiplican y el proyecto se cancela silenciosamente.
Esta historia no es una excepción; es la norma. Diversos estudios sectoriales y análisis recientes de firmas como Gartner y la RAND Corporation revelan una realidad incómoda para el sector tecnológico: entre el 75% y el 85% de las iniciativas piloto de inteligencia artificial jamás logran cruzar la frontera hacia un entorno de producción real. En otras palabras, solo uno de cada cuatro proyectos sobrevive al choque directo con la realidad corporativa.
¿Por qué existe un abismo tan profundo entre un bot funcional en un script local y un sistema en producción capaz de atender a miles de usuarios simultáneos? La respuesta corta es que entrenar o ajustar un modelo es un problema de Ciencia de Datos, pero operar un sistema inteligente, confiable y escalable es, en un 90%, un problema complejo de Ingeniería de Software, infraestructura y DevOps.
Del entorno idílico al mundo real: Las trampas del prototipo
Para comprender dónde se rompe la cadena de valor, debemos analizar cómo nace una prueba de concepto. Un prototipo de IA suele construirse en un entorno hipercontrolado: un cuaderno de Jupyter, datasets de prueba limpios, peticiones secuenciales y métricas de éxito excesivamente permisivas. En la fase de pruebas, si la inferencia tarda cuatro segundos en responder, a nadie le importa demasiado mientras la respuesta sea impresionante visualmente.
El problema surge cuando esa misma lógica debe integrarse en la arquitectura viva de una compañía. En producción, los datos de entrada ya no vienen estructurados en un archivo CSV inmaculado; provienen de formularios con tipografías caóticas, APIs externas con fallos de conexión temporales y consultas de usuarios reales con formatos impredecibles.
Analicemos los cuatro factores clave que convierten estas demos brillantes en pesadillas operativas:
- La brecha de datos y el temido Data Drift: Los datos reales mutan constantemente. Un modelo calibrado con información histórica del último trimestre empieza a degradar su precisión (drift) en el instante en que cambia la estacionalidad del negocio o el comportamiento del consumidor. Sin tuberías de retrenado y validación continua, la fiabilidad cae en picado.
- La factura oculta de la inferencia y la latencia: Mantener un clúster de GPUs de alto rendimiento o consumir APIs de modelos masivos mediante pago por uso puede ser sostenible para cincuenta peticiones diarias de prueba, pero resulta financieramente inviable cuando el tráfico escala a miles de transacciones por minuto. Si añadir un modelo de lenguaje aumenta la latencia de un proceso de compra en tres segundos, el impacto en la tasa de conversión anula de inmediato cualquier beneficio operativo.
- El desafío de la integración Legacy y los sistemas distribuidos: Los modelos de IA no operan en el vacío. Deben conectarse con ERPs, CRMs y bases de datos relacionales diseñadas hace dos décadas. Gestionar concurrencia, reintentos, sistemas de colas y respuestas en streaming sin romper la arquitectura existente exige un esfuerzo de ingeniería que muy pocas empresas anticipan en la fase de prototipado.
- Alucinaciones, gobernanza y normativas de seguridad: En un entorno de desarrollo, una respuesta inexacta es una simple curiosidad técnica. En producción —y bajo el estricto marco regulatorio europeo como la AI Act—, una respuesta alucinada a un cliente o una filtración inadvertida de datos confidenciales a través del prompt representa un riesgo legal y reputacional inasumible.
De la Ciencia de Datos a LLMOps: El cambio de paradigma necesario
Superar el trágico 75% de fracaso no requiere mejores modelos ni algoritmos más sofisticados; requiere adoptar disciplina de ingeniería. La industria ha comenzado a articular este cambio bajo las prácticas de MLOps y LLMOps (Machine Learning / Large Language Model Operations), adaptando las mejores costumbres del desarrollo de software moderno al ciclo de vida de la IA.
Si queremos garantizar que nuestros proyectos traspasen el purgatorio de las demos, debemos implementar principios fundamentales de arquitectura desde el primer día:
- Evaluación continua automatizada (Evals): Confiar en la prueba ocular de un desarrollador no escala. Es imprescindible estructurar conjuntos de evaluación (test suites) que midan en tiempo real la tasa de alucinaciones, la precisión fáctica y la relevancia contextual ante cada cambio en los datos o en las instrucciones del sistema.
- Observabilidad y trazabilidad completa: No basta con saber si el servidor está activo. Necesitamos métricas granulares sobre el coste por token, tiempo de primer token (TTFT), distribución de latencia y trazabilidad de llamadas a herramientas externas (function calling).
- Arquitecturas defensivas y estrategias de desintegración elegante (Fallback): Las aplicaciones robustas no dependen ciegamente de un único proveedor o modelo. Si la API principal experimenta latencia alta o degradación, la arquitectura debe ser capaz de redirigir la carga hacia un modelo menor optimizado localmente o hacia reglas deterministas tradicionales sin interrumpir la experiencia del usuario.
- Diseño orientado a la producción desde la fase 0: El equipo de infraestructura, ciberseguridad y DevOps debe participar en la definición de la prueba de concepto. Preguntas sobre cómo se autenticarán las peticiones, cómo se purgarán los datos sensibles y cuál será el presupuesto límite por usuario deben responderse antes de escribir la primera línea de código del prototipo.
Hacia una madurez tecnológica sostenible
La inteligencia artificial ha superado definitivamente la fase de fascinación inicial. El verdadero valor competitivo ya no reside en mostrar lo que una demo es capaz de hacer en una sala de presentaciones, sino en la capacidad técnica de construir sistemas distribuidos, seguros, mantenibles y rentables que soporten la operación diaria del negocio.
Las organizaciones que entiendan la IA como una disciplina de ingeniería continua —donde la monitorización, el gobierno de datos y la arquitectura de software pesan más que la brillantez del algoritmo en solitario— serán las que consigan posicionarse en el 25% exitoso que transforma el software experimental en impacto real.
¿Habéis vivido en vuestros equipos o clientes el síndrome de la demo eterna? ¿Qué obstáculos técnicos os habéis encontrado al intentar pasar un modelo a producción? Os leo en los comentarios para debatir sobre arquitecturas, herramientas y experiencias reales.
Deja una respuesta