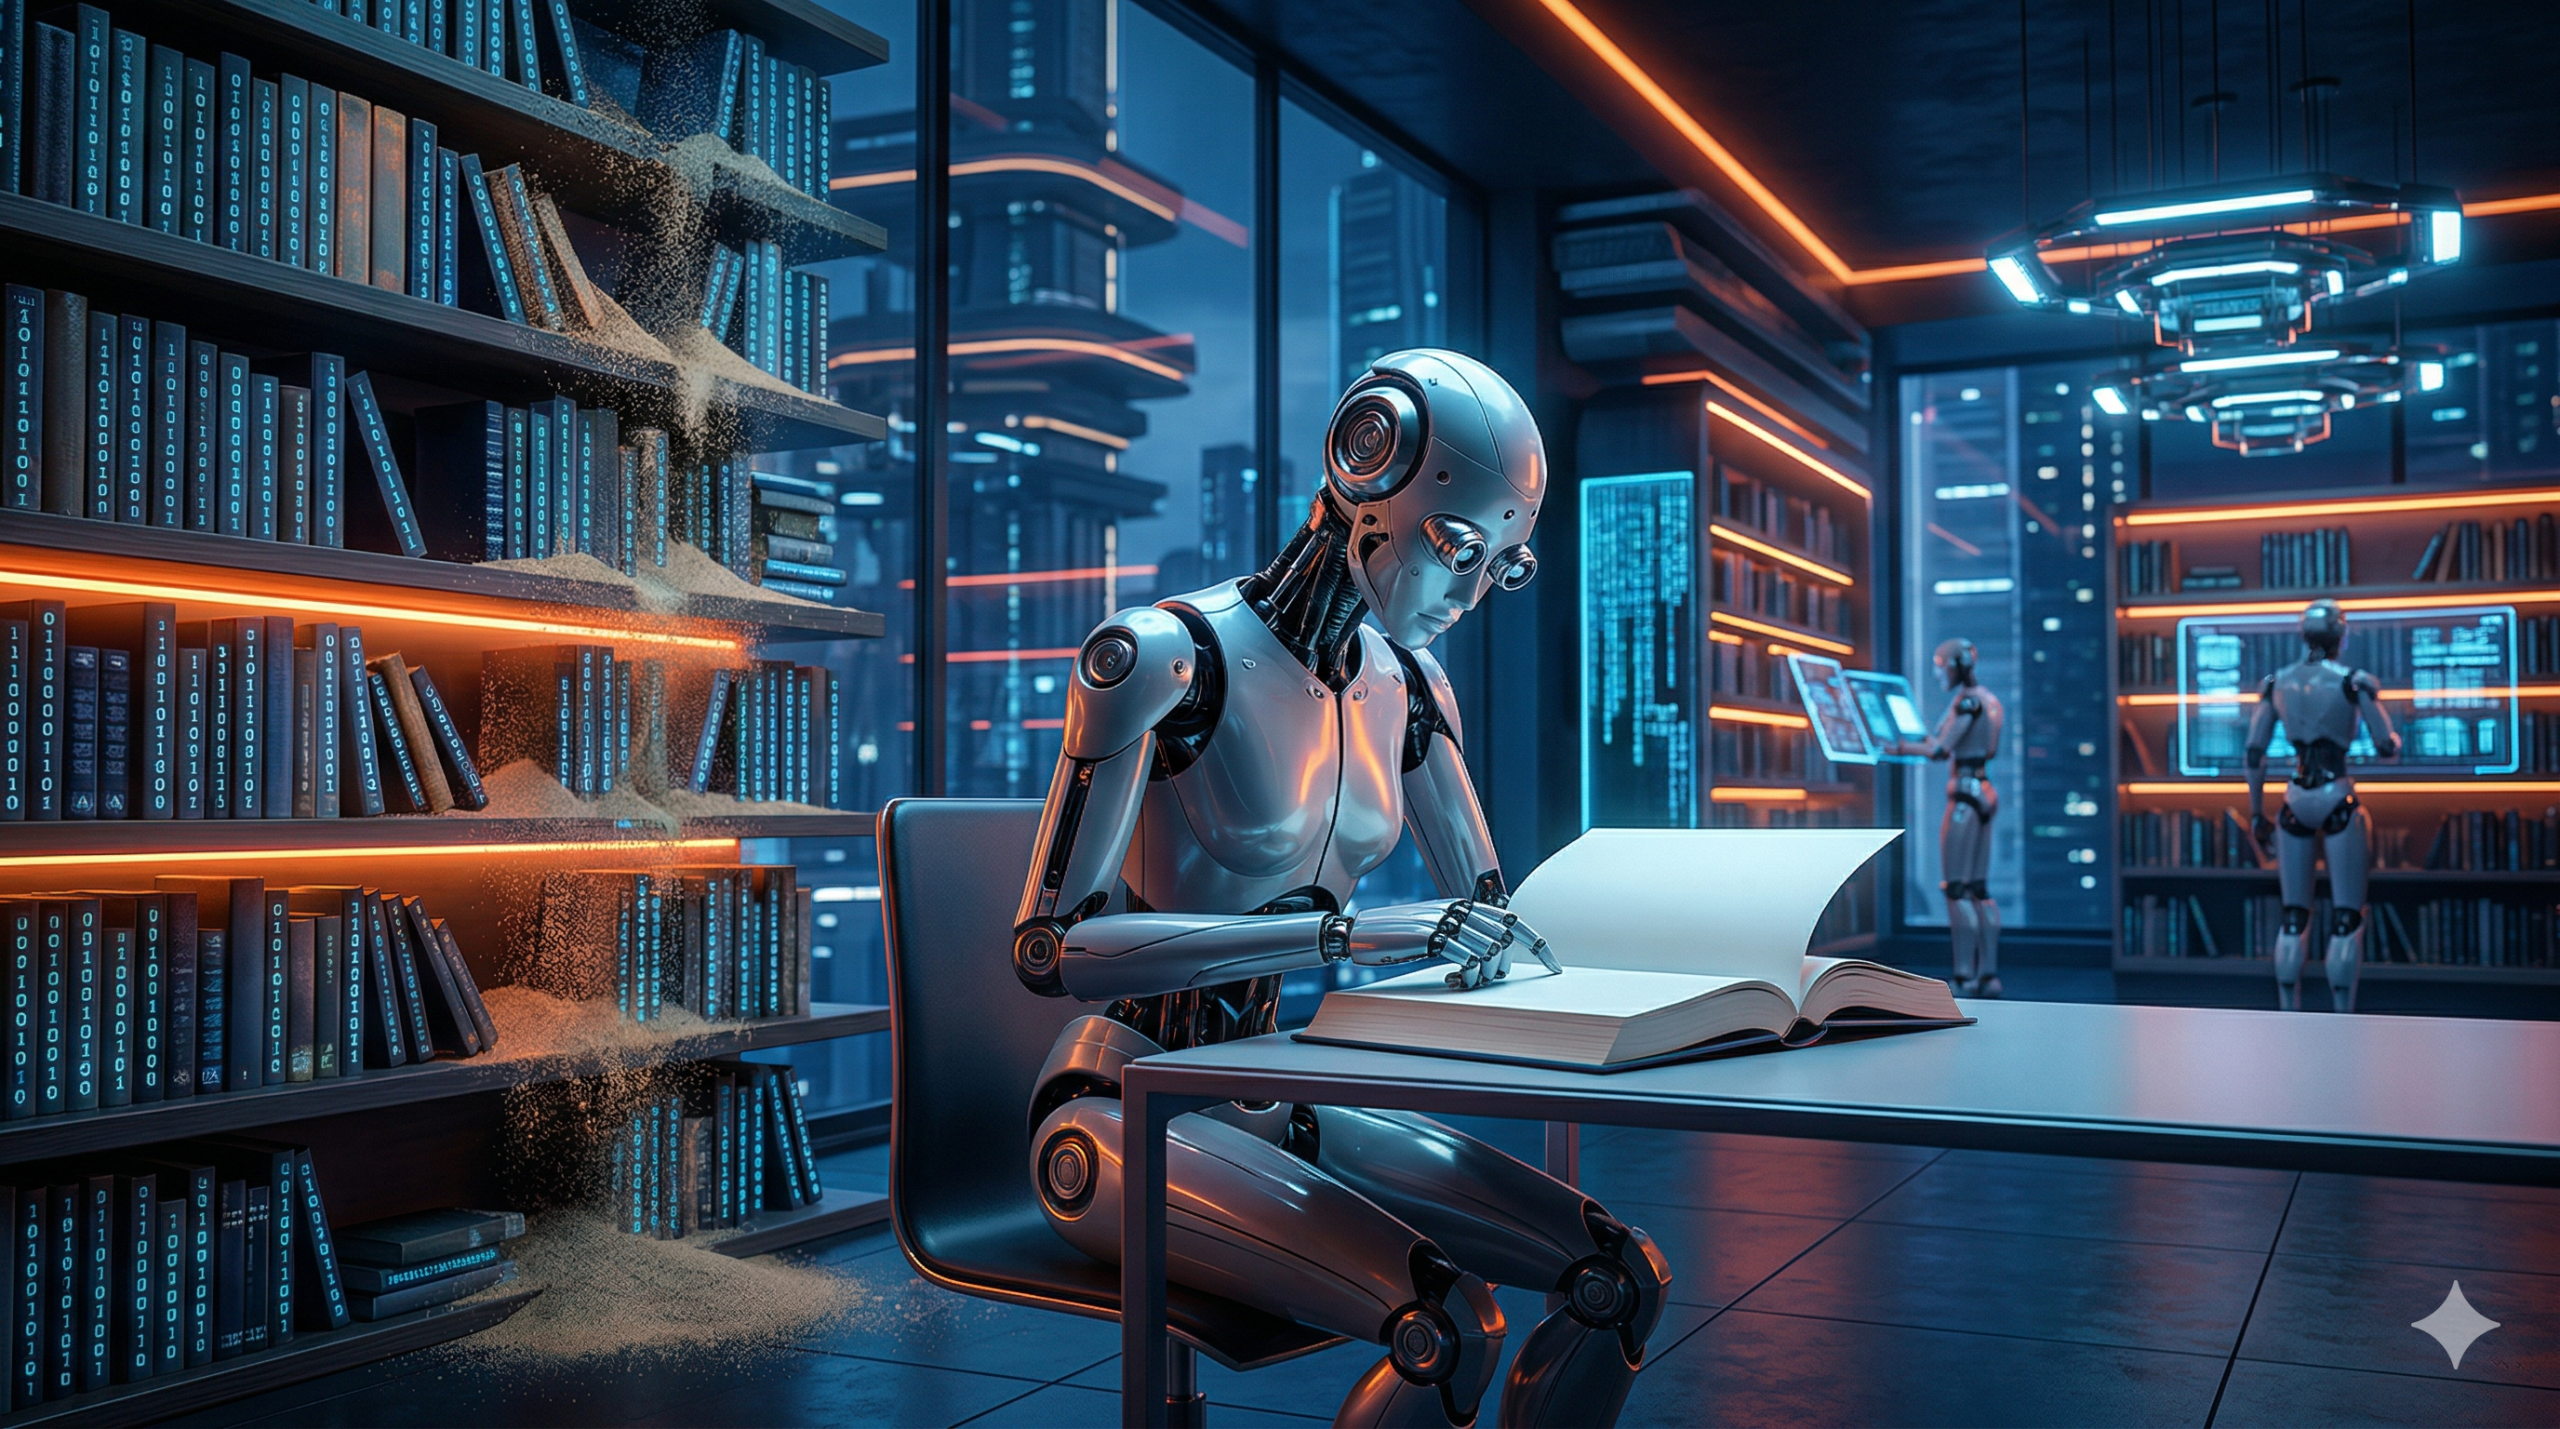
Imagínate que decides alimentarte exclusivamente de fotocopias de fotocopias de una receta de tarta de manzana. Al principio, la tarta está rica. En la décima iteración, el azúcar parece sal. En la centésima, lo que tienes entre manos no es un postre, sino un amasijo de pixeles borrosos sin sabor a nada. Este fenómeno, que en el mundillo técnico empezamos a conocer como Model Collapse (colapso del modelo), es el gran muro invisible contra el que la inteligencia artificial generativa está a punto de chocar.
El problema es cuantitativo y, sobre todo, existencial. Según estudios recientes de instituciones como Epoch AI, el inventario de datos de alta calidad escritos por humanos (libros, artículos científicos, código de GitHub, hilos de Reddit que no sean puro spam) se está agotando. A este ritmo, para finales de 2027, habremos «leído» todo lo que la humanidad ha volcado en la red.
El contexto: La dieta de los LLMs
Para entender cómo hemos llegado aquí, debemos mirar bajo el capó de un clúster de GPUs. Entrenar un modelo de lenguaje no es muy distinto de criar a un niño en una biblioteca infinita. El modelo aprende patrones, sintaxis y razonamiento estadístico absorbiendo la diversidad del pensamiento humano. Sin embargo, internet se está llenando de contenido generado por la propia IA.
Cuando una IA de nueva generación se entrena utilizando como base datos generados por una IA anterior, ocurre algo similar a la endogamia biológica. Los errores marginales se amplifican, los matices se pierden y el modelo empieza a sufrir de una «pereza cognitiva» donde solo reproduce los patrones más probables. En términos de inferencia paralela, estamos optimizando para el promedio, y el promedio suele ser bastante aburrido.
La solución: Datos sintéticos y curación «de autor»
¿Estamos condenados al estancamiento? No necesariamente. La industria está pivotando hacia tres soluciones clave:
- Datos Sintéticos de Alta Fidelidad: Usar modelos para crear problemas lógicos o de programación con una estructura verificable por sistemas externos (como compiladores).
- Arquitecturas de Razonamiento: Modelos que dedican más cómputo a la fase de reflexión que a la de memorización.
- Minería de Datos Off-line: Rescate de conocimiento humano que nunca llegó a digitalizarse masivamente.
Nota técnica: No es lo mismo un dato sintético generado por un bot de Twitter que uno generado por un entorno de simulación física. La clave está en la verificabilidad.
El impacto: Calidad sobre cantidad
El fin de la abundancia de datos humanos nos obliga a ser mejores ingenieros. Ya no basta con lanzar potencia de cómputo a un problema; ahora necesitamos curación estratégica. Estamos entrando en una era donde el papel del experto informático será filtrar el ruido del silicio para preservar la señal de la inteligencia real.
Si logramos superar el colapso del modelo, la IA dejará de ser un espejo que deforma nuestro pasado para ser una herramienta de futuro. Pero si fallamos, nos arriesgamos a un eco infinito de contenido vacío.
¿Has empezado a notar que las respuestas de algunos modelos se sienten algo «repetitivas» o carentes de chispa últimamente? Te leo en los comentarios: ¿crees que los datos sintéticos son la salvación o el principio del fin?
Deja una respuesta