Categoría: Noticias

Notícias principal

  • La Gran Paradoja del Low-Code: ¿Podemos Construir Sistemas Críticos sin Picar una Línea de Código?

    La Gran Paradoja del Low-Code: ¿Podemos Construir Sistemas Críticos sin Picar una Línea de Código?

    La Gran Paradoja del Low-Code: ¿Podemos Construir Sistemas Críticos sin Picar una Línea de Código?

    El Desafío de la Ceguera del Código

    Imaginen esta escena: un directivo, entusiasmado tras una demo, nos pide acelerar el desarrollo de un ERP o un sistema logístico crucial, pero sugiriendo que «quizás podríamos usar esa herramienta que no necesita programadores». Spoiler alert: no es magia, es el auge del desarrollo Low-Code y No-Code (LCNC), una tendencia que ha trascendido los prototipos sencillos para meterse de lleno en el corazón de las aplicaciones empresariales críticas.

    Este es un verdadero dilema para nosotros, los expertos. El problema no es la herramienta en sí (que puede ser un motor de eficiencia espectacular), sino la «ceguera del código» que genera. Cuando la lógica de negocio se abstrae en drag-and-drop e interfaces visuales, ¿cómo garantizamos la seguridad, la escalabilidad y, sobre todo, la auditabilidad de sistemas que gestionan millones o dirigen almacenes enteros? ¿Estamos sacrificando el rigor informático en el altar de la velocidad?

    Descodificando la Arquitectura LCNC: De Prototipo a Sistema de Misión Crítica

    Para entender este fenómeno, primero debemos ser precisos. El Low-Code y el No-Code no son lo mismo.

    • El No-Code (NC) es la máxima abstracción: puro diseño visual, orientado a usuarios de negocio (Citizen Developers). Genera aplicaciones cerradas dentro de un framework definido (pensemos en la automatización de flujos de trabajo sencillos).
    • El Low-Code (LC) es el término medio: ofrece una capa visual, pero permite inyectar código personalizado (generalmente JavaScript, Python o C#) para integraciones complejas, lógica de negocio específica o conexiones a legacy systems.

    Lo que ha cambiado es la potencia de estas plataformas. Ya no son solo para crear formularios; ahora incluyen conectores nativos a sistemas distribuidos, clusters de bases de datos NoSQL, y hasta integraciones de modelos de lenguaje grandes (LLMs) para procesar datos no estructurados. Plataformas maduras están siendo certificadas para gestionar la logística, la cadena de suministro, y hasta la salud financiera de grandes corporaciones. La promesa es reducir el tiempo de desarrollo de meses a semanas, lo cual es, seamos sinceros, atractivo.

    Pero aquí es donde nuestro expertise debe intervenir con una sonrisa y una advertencia técnica. El rigor informático se diluye cuando el código subyacente—la base real que realiza la inferencia paralela o gestiona las transacciones—es una caja negra para el desarrollador. El reto técnico pasa de «cómo implemento esta función» a «cómo audito y aseguro la función que la plataforma me ha generado».

    La Receta del Experto: Integridad, Prueba y Arquitectura Mixta

    Desde nuestra trinchera, la adopción de LCNC en procesos críticos no es un sprint, sino un maratón de diligencia. Aquí están las claves que exploramos y aplicamos:

    1. La Auditoría del Código Generado: No podemos depender ciegamente. Es crucial que las plataformas LCNC ofrezcan herramientas de inspección del código fuente (aunque esté ofuscado o sea bytecode). Debemos exigir la trazabilidad completa, verificando que la lógica visual implementada se traduce en un código eficiente y, lo más importante, seguro contra inyecciones SQL o fallos de validación.
    2. Estrategias de Pruebas «Black-Box» Avanzadas: Puesto que no controlamos el código, debemos ser implacables en las pruebas funcionales, de carga y de seguridad (penetration testing). Utilizamos frameworks automatizados para someter a la aplicación a estrés, midiendo la latencia de las transacciones y verificando la escalabilidad del backend de la plataforma LCNC (que suele basarse en arquitecturas serverless).
    3. Arquitecturas Híbridas (El Puente Low-Code): La solución más sensata es el enfoque híbrido. Las partes críticas del negocio (como los algoritmos de matching o las funciones de seguridad) deben seguir siendo implementadas por programadores expertos en código tradicional (Python, Java, etc.). El LCNC se utiliza como capa de orquestación, frontend o para flujos secundarios, actuando como un simple «pegamento» de código ya validado. Esto nos permite mantener el control sobre la IP y el rendimiento de los componentes vitales.
    ¡Dato técnico afable! Piensen en el desarrollo LCNC como un juego de LEGO. Puedes construir una casa genial muy rápido, pero si quieres un soporte sísmico avanzado, tendrás que meter tus propias vigas de acero y, sí, tendrás que soldarlas tú. El expertise es la soldadura.

    El Impacto: Programación de Valor y el DevOps del Ciudadano

    El boom del Low-Code y No-Code no significa el fin de la programación. Al contrario, revaloriza el rol del informático y del desarrollador.

    Si las tareas rutinarias y repetitivas de desarrollo de frontends básicos o la conexión de APIs sencillas se automatizan con LCNC, el programador se libera para enfocarse en el código de alto valor. Esto incluye la optimización de algoritmos de IA, el diseño de arquitecturas de sistemas distribuidos y, crucialmente, la ingeniería de la seguridad y la arquitectura del propio ecosistema LCNC.

    La tendencia nos lleva a un nuevo paradigma donde el DevOps debe extenderse al Citizen Developer. Debemos proporcionar las herramientas, los estándares de seguridad y la gobernanza para que el usuario de negocio pueda innovar rápidamente sin comprometer la integridad del sistema. Es nuestra responsabilidad como expertos informar, educar y construir los raíles técnicos sobre los que puede correr esta nueva y rápida locomotora del desarrollo. Al final, la velocidad de desarrollo es buena, siempre y cuando no sacrifiquemos la solidez. ¡Y eso, colegas, es código de honor!

    ¿Ya has tenido que auditar o poner en producción un sistema crítico con Low-Code? Te leo en los comentarios si usas una mejor alternativa o has descubierto un agujero de seguridad fascinante.
  • El Temblor de la Nube: La Caída de AWS y la Peligrosa Concentración del Internet Moderno

    El Temblor de la Nube: La Caída de AWS y la Peligrosa Concentración del Internet Moderno

    La Caída de AWS y la Peligrosa Concentración del Internet Moderno

    Cuando el Internet se Concentra Demasiado

    El Problema: La Nube nos prometió flexibilidad y resiliencia, pero ¿y si hemos centralizado el riesgo en tres grandes pilares tecnológicos?

    Imagina que toda la energía de una ciudad dependiera de una única subestación. Si esa subestación falla, el apagón no es parcial; es total. Eso es precisamente lo que experimentamos cuando una de las grandes infraestructuras de Cloud Computing tropieza. Hace apenas unas semanas, un fallo masivo en la región US-EAST-1 de Amazon Web Services (AWS) —el nervio central de la nube de Amazon— paralizó una porción enorme del ecosistema digital global. Plataformas de streaming, e-commerce, sistemas financieros y hasta dispositivos de smart home cayeron en un efecto dominó que duró horas. El incidente no solo generó pérdidas económicas incalculables; nos recordó la vulnerabilidad que acarrea la extrema dependencia de un puñado de gigantes tecnológicos.

    El Dominó Técnico Detrás del Desastre

    El Contexto: La complejidad del DNS y el DynamoDB en el corazón de un fallo en cascada.

    Para que entendamos qué se rompió, debemos ir a la sala de máquinas. La causa raíz, según el informe post-mortem de AWS, no fue un ataque externo ni un fallo de hardware. Fue algo más sutil y, a la vez, más insidioso: un error en el software de automatización relacionado con el sistema de resolución DNS (Sistema de Nombres de Dominio) de DynamoDB en la región de Virginia.

    Para el profano, el DNS es la guía telefónica del internet. Los servicios que dependen de DynamoDB —una base de datos clave de AWS utilizada internamente por muchísimos otros servicios— no pudieron encontrar las direcciones IP correctas. Es como si el sistema de navegación de todos los camiones de reparto de una ciudad se estropeara simultáneamente: el tráfico sigue existiendo, pero nadie sabe dónde ir.

    El fallo se convirtió rápidamente en una falla en cascada (o cascading failure). DynamoDB, al fallar, afectó a servicios esenciales como EC2 (servidores virtuales), SQS (colas de mensajes) y Lambda (funciones sin servidor). Estos servicios son los ladrillos fundamentales de miles de empresas. La dependencia interna de los propios servicios de AWS en sus otros componentes de «capa uno» amplificó el problema hasta proporciones globales. El sistema no supo autocorregrirse, requiriendo intervención manual, lo que disparó el tiempo de inactividad.

    Solución – Diversificación y Resiliencia Distribuida

    La Solución: Más allá de «usar la nube», el reto es diseñar la resiliencia dentro de ella, o incluso fuera de ella.

    ¿Cómo evitamos que la caída de un único centro de datos en Virginia tumbe media internet? Los expertos en sistemas distribuidos llevamos años predicando la redundancia y la diversificación. Las empresas tienen dos caminos principales para mitigar este «riesgo de concentración»:

    1. Arquitectura Multi-Región: El primer paso es diseñar las aplicaciones para operar activamente en múltiples regiones geográficas de un mismo proveedor (cloud). Si US-EAST-1 falla, el tráfico se redirige automáticamente, o incluso se reparte activamente, a US-WEST-2 o Europa. Esto requiere una programación avanzada, clusters de bases de datos replicados y balanceadores de carga inteligentes, pero garantiza la continuidad operativa.
    2. Estrategia Multi-Cloud: La opción más robusta y compleja es la arquitectura Multi-Cloud. Esto implica utilizar a propósito varios proveedores (AWS, Azure, Google Cloud) para diferentes partes de la infraestructura. Si AWS cae, los servicios críticos pueden seguir operando en Azure. Este enfoque requiere dominar múltiples frameworks y enfrentarse a los altos costos de la «tasa de egreso de datos» (el coste de sacar datos de la nube de un proveedor), un mecanismo que a veces funciona como un candado (vendor lock-in).

    Este incidente subraya la necesidad de que los desarrolladores y arquitectos cloud abandonen la comodidad del proveedor único y asuman la responsabilidad de diseñar sistemas que, aunque estén en la nube, sean intrínsecamente descentralizados y tolerantes a fallos.

    La Fragilidad de la Interconexión y el Rol del Programador

    El Impacto: El incidente es un recordatorio ético y práctico para los líderes tecnológicos.

    Este apagón nos deja varias reflexiones cruciales, que van más allá del rigor técnico. La extrema dependencia de tres gigantes (AWS, Azure, Google Cloud) no es solo un riesgo de uptime; es un riesgo de soberanía digital y competencia. Si solo tres entidades controlan la infraestructura base, el poder que ostentan sobre startups y gobiernos es inmenso.

    Para nosotros, los profesionales informáticos, el takeaway es claro: la fiabilidad del código y la resiliencia de la arquitectura son más valiosas que nunca. No basta con desplegar en la nube; hay que saber cómo y dónde desplegar.

    “Una arquitectura monolítica en la nube es como cambiar un edificio de ladrillo por un rascacielos de cristal; se ve moderno y ágil, pero un solo punto débil lo rompe todo.”

    El evento de AWS es una lección de humildad para el sector, que nos obliga a reexaminar la automatización ciega y a reforzar las defensas contra lo que parecía impensable: el fallo interno de la infraestructura digital más robusta del planeta.

    ¿Cómo tienes configurada la resiliencia de tus proyectos? ¿Confías plenamente en el auto-healing de un único proveedor, o ya estás experimentando con estrategias Multi-Cloud?

    Aquí puedes revisar el análisis detallado del fallo de AWS (en inglés) si quieres bucear en el informe técnico. Te animo a compartir tu experiencia: ¿qué alternativa cloud consideras más preparada para un desastre global? ¡Te leo en los comentarios!

  • ‘Absolute Zero’: ¿El fin de la dependencia de los datos etiquetados para la IA?

    ‘Absolute Zero’: ¿El fin de la dependencia de los datos etiquetados para la IA?

    El reto de la etiqueta: Un cuello de botella en la era de la IA

    ¿Alguna vez te has preguntado por qué entrenar un modelo de Inteligencia Artificial de vanguardia consume tanto tiempo, dinero y recursos humanos? El problema, amigos informáticos, se resume en una sola palabra: etiquetado.

    (más…)
  • El Retorno del Caballero Oscuro del Código: Por Qué el Ensamblador Resurge en el Mundo del IoT

    El Retorno del Caballero Oscuro del Código: Por Qué el Ensamblador Resurge en el Mundo del IoT

    ¿Hemos olvidado cómo optimizar de verdad? El desafío del último microsegundo

    Imagina que tienes un pequeño dispositivo IoT, quizás un sensor que mide la calidad del aire o una cerradura inteligente. Su misión es sencilla, pero crítica: tiene que funcionar sin parar durante meses o años con una batería diminuta. Lo programamos felizmente en C++, Python o quizás Rust, lenguajes modernos que nos hacen la vida tremendamente más fácil. Pero, ¿qué pasa cuando ese código, a pesar de ser bastante bueno, no es lo suficientemente eficiente?

    Aquí es donde entra el desafío. Los lenguajes de alto nivel son fantásticos para la productividad, pero sus compiladores, aunque avanzados, no siempre pueden generar el código más magro, rápido y energéticamente eficiente posible para un hardware específico. En el mundo del IoT de ultra-bajo consumo y los sistemas embebidos más apretados, la diferencia entre un ciclo de reloj extra o una instrucción mal ubicada puede ser la vida útil de la batería o la velocidad de respuesta.

    El problema es claro: La comodidad del software de alto nivel choca con la necesidad imperiosa de eficiencia máxima a nivel de hardware. Y para conseguir esa optimización que roza la perfección, la comunidad tech está volviendo a mirar a un viejo amigo, un verdadero caballero oscuro de la programación: el código ensamblador (Assembly).


    Contexto Técnico: Cuando la Abstracción se Paga Cara

    El ensamblador no es un lenguaje nuevo; es la representación textual de las instrucciones binarias que el microprocesador ejecuta directamente. Cada línea de código Assembly se traduce, casi uno a uno, en una instrucción de máquina. Esto es lo que lo hace tan temido (¡y a la vez tan poderoso!).

    Cuando programamos en un lenguaje de alto nivel (como C, que ya es de por sí de bajo nivel en el panorama actual), el compilador se encarga de todo el trabajo sucio: mapear las variables a registros, gestionar la pila y generar las secuencias de instrucciones óptimas para una determinada arquitectura (ARM, x86, RISC-V, etc.). Para la mayoría de las aplicaciones (web, cloud, desktop), esta capa de abstracción funciona de maravilla. Tenemos velocidad, seguridad de memoria (¡hola, Rust!) y portabilidad.

    Sin embargo, cuando hablamos de un microcontrolador que tiene 32 KB de RAM, que debe despertar, tomar una lectura, enviarla por LoRaWAN y volver a dormir en cuestión de microsegundos, no podemos permitirnos el lujo de desperdiciar un solo ciclo.

    ¿Por qué el Ensamblador es el «Tuning» Definitivo?

    1. Control Granular: El ensamblador permite al programador decidir exactamente qué registros de la CPU utilizará, cómo se moverán los datos en la memoria y qué flags (banderas) de estado se manipularán. Este control a nivel de bit es imposible de lograr en C/C++ sin sacrificar la legibilidad o depender de optimizaciones poco fiables del compilador.
    2. Eficiencia de la Instrucción: Se pueden utilizar instrucciones específicas del hardware (los famosos intrínsecos) que un compilador podría no considerar para ciertas rutinas. Piensa en operaciones de bit-shifting complejas o en la manipulación directa de puertos I/O.
    3. Reducción de Huella (Footprint): Un firmware escrito en Assembly o que incluya rutinas críticas en Assembly suele ser significativamente más pequeño. Esto es crucial cuando el almacenamiento flash de un microcontrolador es limitado. Menos código es menos consumo de energía y menos tiempo de ejecución.
    4. Optimización Criptográfica: Mucho del resurgimiento viene de la necesidad de optimizar algoritmos criptográficos (como AES o hashing) que, por su naturaleza, son intensivos en cálculo. Al reescribir la rutina de cifrado más crítica en ensamblador, los desarrolladores pueden asegurar que la ejecución se haga en un tiempo estrictamente constante (previniendo timing attacks) y con la máxima velocidad posible.

    ¡Dato Curioso! ¿Sabías que incluso gigantes como Google usan ensamblador? El runtime de Go y muchas partes del kernel de Linux todavía incluyen rutinas críticas escritas en Assembly para optimizar el rendimiento de operaciones clave, ¡demostrando que lo viejo sigue siendo gold!

    🔧 La Solución Híbrida: No Es un ‘Todo o Nada’

    Para que nadie se asuste, la tendencia actual no es volver a escribir sistemas operativos completos en ensamblador. ¡Eso sería una pesadilla de mantenimiento! La solución moderna es la **programación híbrida**.

    Los desarrolladores de firmware y sistemas embebidos utilizan lenguajes de alto nivel, como C o Rust, para la mayor parte de la lógica de la aplicación (la capa de control, drivers de alto nivel, etc.). Sin embargo, identifican las **rutinas más críticas** que se ejecutan millones de veces o que son vitales para la eficiencia energética. Esas rutinas, como un handler de interrupción muy sensible, un algoritmo de deep sleep o un bloque de cifrado, se escriben o se in-linean directamente en ensamblador.

    De esta forma, se consigue lo mejor de ambos mundos:

    • Mantenibilidad: La mayor parte del código es fácil de leer y mantener gracias a C/Rust.
    • Rendimiento Extremo: Las funciones críticas tienen un rendimiento y una eficiencia insuperables, garantizando una mayor vida útil de la batería y tiempos de respuesta ultra-bajos.

    Esta técnica es la que está permitiendo a los dispositivos IoT ser cada vez más pequeños, potentes y, crucialmente, autónomos en términos de energía.

    🚀 Impacto Futuro: Más Allá de la Batería

    El dominio de este stack de programación de bajo nivel es lo que separa a un developer de software estándar de un **ingeniero de sistemas embebidos de élite**. Esta habilidad no solo impulsa el IoT, sino que tiene un impacto directo en:

    1. Computación Edge: Dispositivos que ejecutan modelos de IA directamente en el sensor (por ejemplo, clasificación de imágenes en una cámara de seguridad) necesitan que la capa de inferencia se ejecute con una eficiencia brutal para no sobrecalentar o drenar la batería en minutos.
    2. Ciberseguridad: Entender el ensamblador es fundamental para la ingeniería inversa y el análisis de malware. Si quieres proteger hardware a nivel de bootloader, tienes que saber cómo funciona el procesador por dentro.
    3. Nuevas Arquitecturas: Con la explosión de chips especializados (ASICs, FPGAs, RISC-V), el compilador aún no está totalmente optimizado. Escribir Assembly permite bootstrapear y exprimir estas nuevas arquitecturas antes de que el toolchain de alto nivel madure.

    Así que, la próxima vez que te encuentres con un código Assembly en un proyecto, no lo veas como una pieza de museo. Velo como la herramienta de precisión que permite que los dispositivos del futuro funcionen durante años en la palma de tu mano. El conocimiento del hardware sigue siendo el superpoder más subestimado en la informática moderna.


    ¡Queridos geeks del código! ¿Qué opinas de esta vuelta a las raíces?

    ¿Has tenido que optimizar alguna rutina crítica en Assembly o C intrínseco? ¿Crees que lenguajes como Rust, con su promesa de seguridad y bajo nivel, podrán desplazar completamente la necesidad de Assembly incluso en los firmware más exigentes?

    Te leo en los comentarios si tienes alguna historia de optimización brutal que nos quieras compartir. ¡Y recuerda! Echar un vistazo a la salida de Assembly de tu código C/C++ es una de las mejores lecciones de programación que puedes tener.

  • De Bloques a Python: Vittascience y la Arquitectura Híbrida que Impulsa la Programación

    De Bloques a Python: Vittascience y la Arquitectura Híbrida que Impulsa la Programación

    ¿Cuántos desarrolladores brillantes hemos perdido en la fase de «Hello World»? Es la eterna pregunta en el mundo tech. La curva de aprendizaje inicial, la barrera sintáctica de lenguajes como Python o C++, actúa a menudo como un firewall innecesario que frustra a las mentes más jóvenes o a los profesionales que quieren pivotar.

    (más…)
  • Tu Navegador Sabe Demasiado: El Misterio de la Huella Digital (Y Cómo Protegerla)

    Tu Navegador Sabe Demasiado: El Misterio de la Huella Digital (Y Cómo Protegerla)

    Cuando tecleamos una dirección y navegamos por la inmensidad de Internet, solemos creer que nuestra privacidad depende solo de las cookies o de si usamos el modo incógnito. ¡Qué ingenuos somos! Nos concentramos en la cerradura principal, sin darnos cuenta de que estamos dejando un rastro de migas de pan digitales tan único como nuestras propias huellas dactilares.

    (más…)
  • Software a prueba de balas: Programación “Self-Healing” o cómo el código se arregla solo

    Software a prueba de balas: Programación “Self-Healing” o cómo el código se arregla solo

    💥 ¡Adiós, el temido error 500! ¿Puede nuestro código aprender a curarse?

    Nos hemos acostumbrado a la frustración. El programador que llevamos dentro sabe que, por mucho testing que hagamos, el bug inesperado en producción siempre es una posibilidad. Un error que se cuela, una dependencia que falla, un pico de tráfico que satura… ¡Y boom! El temido downtime, la interrupción del servicio y, por supuesto, esa llamada a las 3 de la mañana.

    (más…)
  • El ‘Copiloto’ Definitivo: Cuando el Sistema Operativo Aprende a Pensar por Sí Mismo (Y a Escribir tus Emails)

    El ‘Copiloto’ Definitivo: Cuando el Sistema Operativo Aprende a Pensar por Sí Mismo (Y a Escribir tus Emails)

    El Hardware que Suda y el Software que Sueña: La Fusión de la IA en tu Escritorio

    Imagina el escenario: estás inmerso en un cluster de tareas digno de un sistema distribuido mal optimizado. Tienes que resumir una presentación de 50 diapositivas, reescribir ese email a un cliente con un tono más «amistoso» y, de paso, buscar ese archivo de configuración crítico que guardaste «en alguna parte». Hasta ahora, esto requería malabares entre aplicaciones, búsquedas manuales y un notable esfuerzo mental. Era un problema de fricción digital, la resistencia innecesaria que encontramos al interactuar con el hardware y software para realizar tareas básicas.

    Pero, ¿y si tu propio Sistema Operativo (SO), ese viejo conocido que gestiona el kernel y el scheduler de tareas, pudiera anticiparse a tus necesidades?

    (más…)
  • ¡Adiós al Bloqueo! Por Qué HTTP/3 y QUIC Están Haciendo Volar a Internet Sin que te Des Cuenta

    ¡Adiós al Bloqueo! Por Qué HTTP/3 y QUIC Están Haciendo Volar a Internet Sin que te Des Cuenta

    ¡Adiós al Bloqueo! Por Qué HTTP/3 y QUIC Están Haciendo Volar a Internet Sin que te Des Cuenta

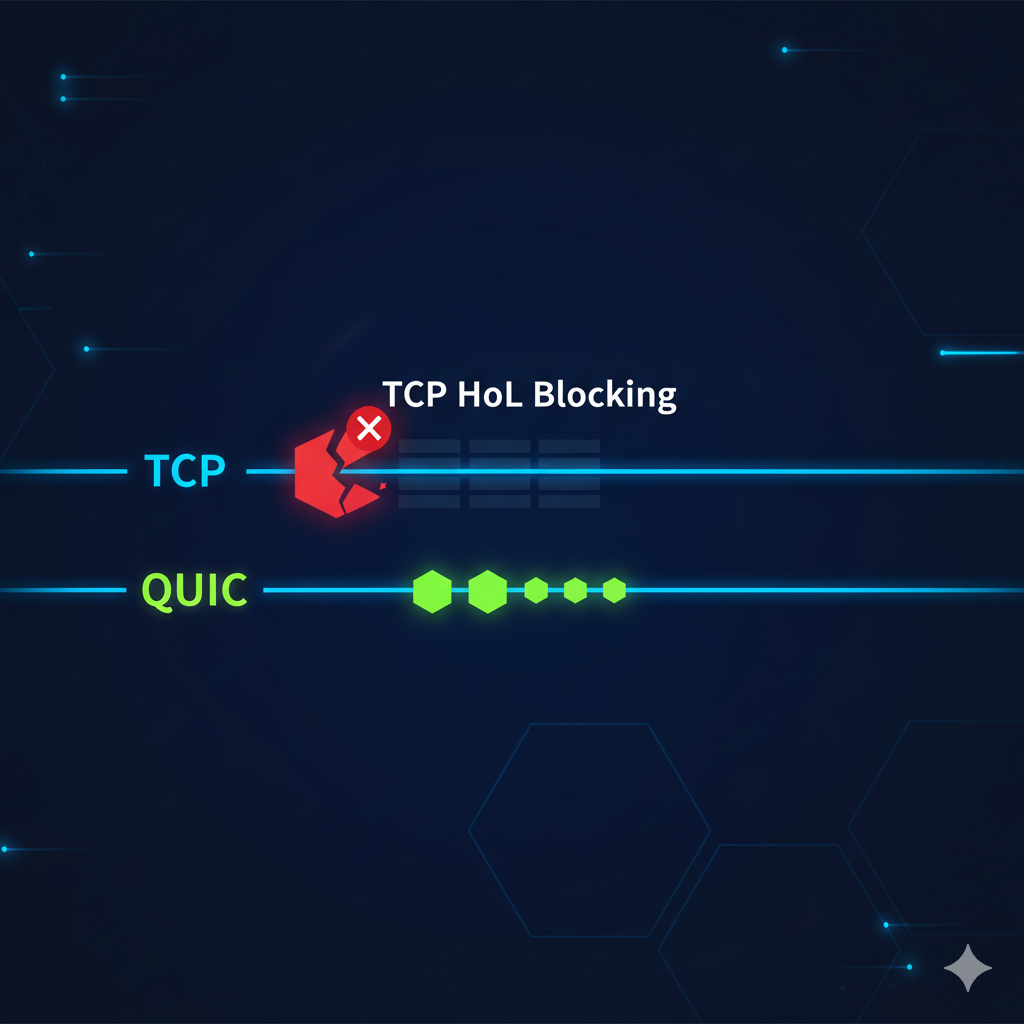
    ¿Alguna vez has notado esa pequeña pausa, ese sutil lag o la carga incompleta de una web cuando abres demasiadas pestañas a la vez? Lo creas o no, detrás de esa frustración digital hay un venerable protocolo que ha sido el motor de la web durante décadas, el todopoderoso HTTP/2, que, a pesar de sus mejoras, arrastra una debilidad de nacimiento: el famoso «Head-of-Line Blocking» (Bloqueo de Cabecera de Línea).

    (más…)
  • ¿Tu Chatbot IA tiene sed? Desvelando la huella hídrica y energética de la Inteligencia Artificial

    ¿Tu Chatbot IA tiene sed? Desvelando la huella hídrica y energética de la Inteligencia Artificial

    Cuando la Arquitectura de Datos se encuentra con la Ecología

    El Problema: La Factura de Agua Silenciosa de la IA

    Imagina esto: estás enfrascado en una productiva sesión con tu modelo de lenguaje favorito, afinando un prompt complejo o depurando código. Te sientes tech-savvy, totalmente en el futuro. Pero, ¿y si te dijera que ese intercambio digital, aparentemente etéreo, acaba de consumir más agua de la que se utilizó para prepararte el café con leche que tienes al lado? Parece una de esas curiosidades tecnológicas sacadas de un think tank futurista, pero es la realidad. Recientes estudios han puesto el foco en la huella hídrica y energética de los grandes modelos de lenguaje (LLMs, por sus siglas en inglés), revelando que una sesión promedio con herramientas como ChatGPT puede ser sorprendentemente «sedienta». Esto nos obliga a plantear una pregunta incómoda, pero necesaria: ¿Estamos construyendo un futuro digital insostenible a base de agua?

    (más…)