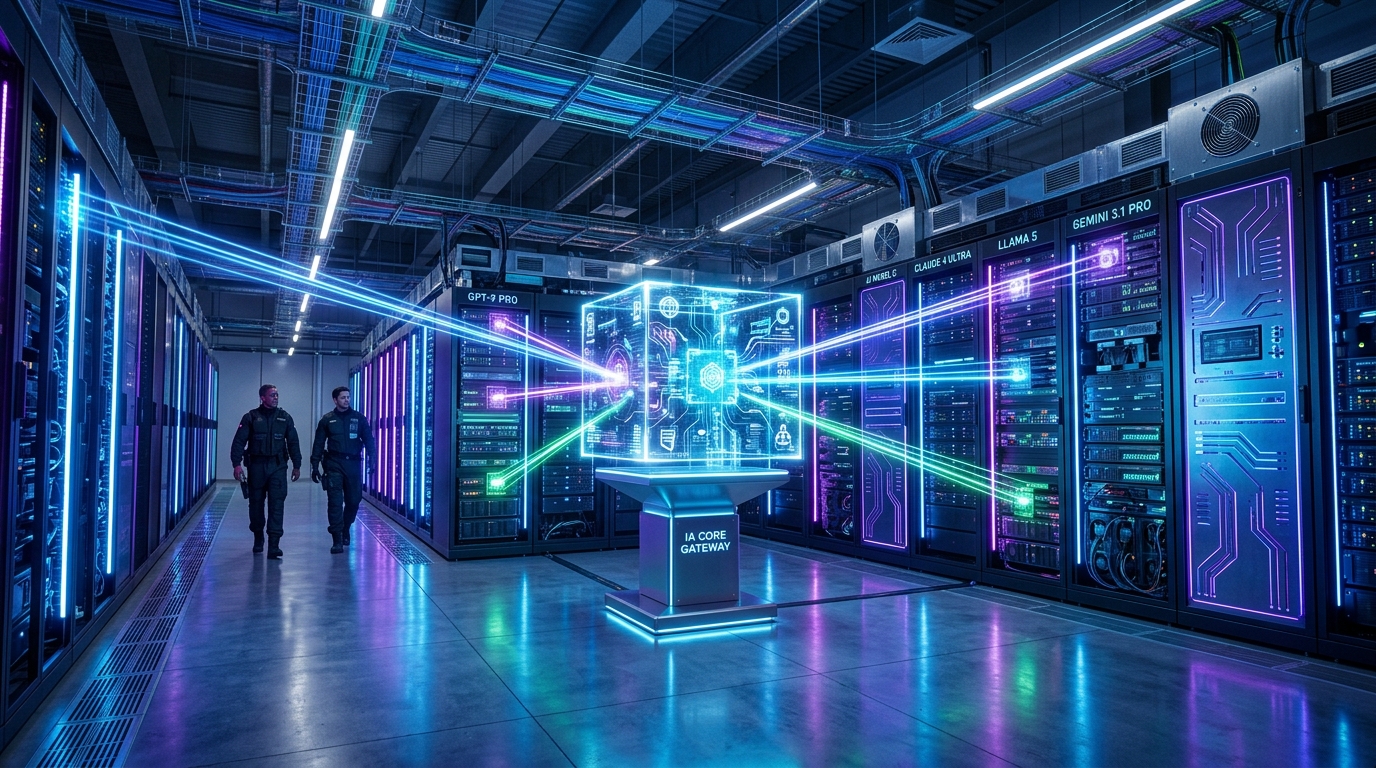
Te ha pasado: lanzas una función basada en un LLM de última generación, todo parece ir como la seda en entorno de desarrollo, pero en cuanto el tráfico de producción escala, empiezan los sudores fríos. Una llamada a la API que se queda colgada durante 8 segundos, un pico imprevisto en la factura del proveedor de IA y, para rematar, un error 500 impredecible porque el modelo decidió entrar en mantenimiento programado justo en tu hora punta. Gestionar llamadas a modelos de lenguaje conectando directamente tu código a la API del proveedor se ha convertido en el equivalente moderno a conectar una base de datos de producción sin una capa de ORM ni pool de conexiones.
En el ecosistema del desarrollo software tradicional, ningún arquitecto sensato permitiría que decenas de microservicios hicieran peticiones HTTP directas y descontroladas a servicios externos clave. Sin embargo, en el auge acelerado de la IA Generativa, la urgencia por integrar funcionalidades inteligentes llevó a muchas empresas a crear arquitecturas frágiles, donde cada servicio gestiona sus propias credenciales, llamadas y reintentos hacia modelos como GPT-4, Claude o Llama.
Este enfoque monolítico en la integración de modelos genera tres problemas críticos en entornos empresariales:
- Vendor Lock-in y falta de resiliencia: Si la API de tu proveedor principal falla o cambia sus directrices de tarifa, tus servicios quedan inoperativos o pasan a ser financieramente inviables.
- Falta de observabilidad y control presupuestario: Resulta sumamente complejo auditar qué usuario o microservicio está consumiendo más tokens, qué latencia real experimenta el sistema o si se están superando los límites de gasto diario.
- Riesgos de seguridad y cumplimiento: Sin una capa intermedia centralizada, garantizar que ninguna información confidencial o PII (información de identificación personal) se filtre hacia las APIs externas se convierte en una pesadilla de auditoría.
La solución arquitectónica: LLMOps y las Pasarelas de Modelos (Model Gateways)
Para resolver esta fragmentación, la ingeniería de software ha dado un paso firme hacia la consolidación de LLMOps, introduciendo el patrón de arquitectura conocido como Model Gateway (o Pasarela de Modelos). Este componente actúa como un proxy inverso o un router inteligente especializado para el tráfico de modelos de inteligencia artificial.
Al igual que un API Gateway convencional gestiona la autenticación, el balanceo de carga y el límite de peticiones (rate limiting) en arquitecturas de microservicios, una Model Gateway se interpone entre tus aplicaciones y la jungla de proveedores de IA.
Entre sus capacidades técnicas fundamentales destacan:
- Enrutamiento dinámico e inteligente: La pasarela redirige la petición al modelo más eficiente según el contexto. Por ejemplo, puede enviar una tarea sencilla de clasificación a un modelo ligero (como un Llama 3 local o un modelo de 8B de parámetros) y reservar los modelos comerciales más costosos únicamente para razonamientos complejos.
- Mecanismos de Fallback y Alta Disponibilidad: Si el proveedor principal devuelve un tiempo de espera agotado (timeout) o un error de tasa excedida (rate limit), la pasarela redirige automáticamente la consulta a un modelo alternativo con capacidades similares sin que el cliente note la interrupción.
- Caché semántica de respuestas: Almacena en vectores las consultas recurrentes. Si un usuario hace una pregunta similar a una realizada previamente por otro usuario, la pasarela devuelve la respuesta almacenada sin necesidad de consumir tokens del proveedor externo.
- Gobernanza y anonimización en tiempo real: Aplica filtros de seguridad antes de enviar la petición a la red, detectando y eliminando datos sensibles antes de que salgan de tu infraestructura.
Impacto estratégico y el futuro del desarrollo impulsado por IA
Adoptar una arquitectura basada en Pasarelas de Modelos dentro del marco de LLMOps transforma la manera en que los equipos de ingeniería construyen productos digitales. Ya no se trata solo de escribir prompts efectivos, sino de estructurar una infraestructura robusta, escalable y financieramente sostenible.
A medida que los modelos open source alcanzan rendimientos comparables a los modelos propietarios, contar con una Model Gateway permite realizar transiciones transparentes entre modelos alojados en la nube y modelos ejecutados en clusters privados de GPUs, reduciendo significativamente la latencia y los costes operativos.
«En la arquitectura de software moderna, la flexibilidad vale más que la potencia bruta. Quien controla la capa de enrutamiento de sus modelos, domina su infraestructura de IA.»
La consolidación de estas pasarelas marca el paso de la fase de experimentación con IA a la fase de madurez industrial en la ingeniería de software. Optimizar el
Deja una respuesta