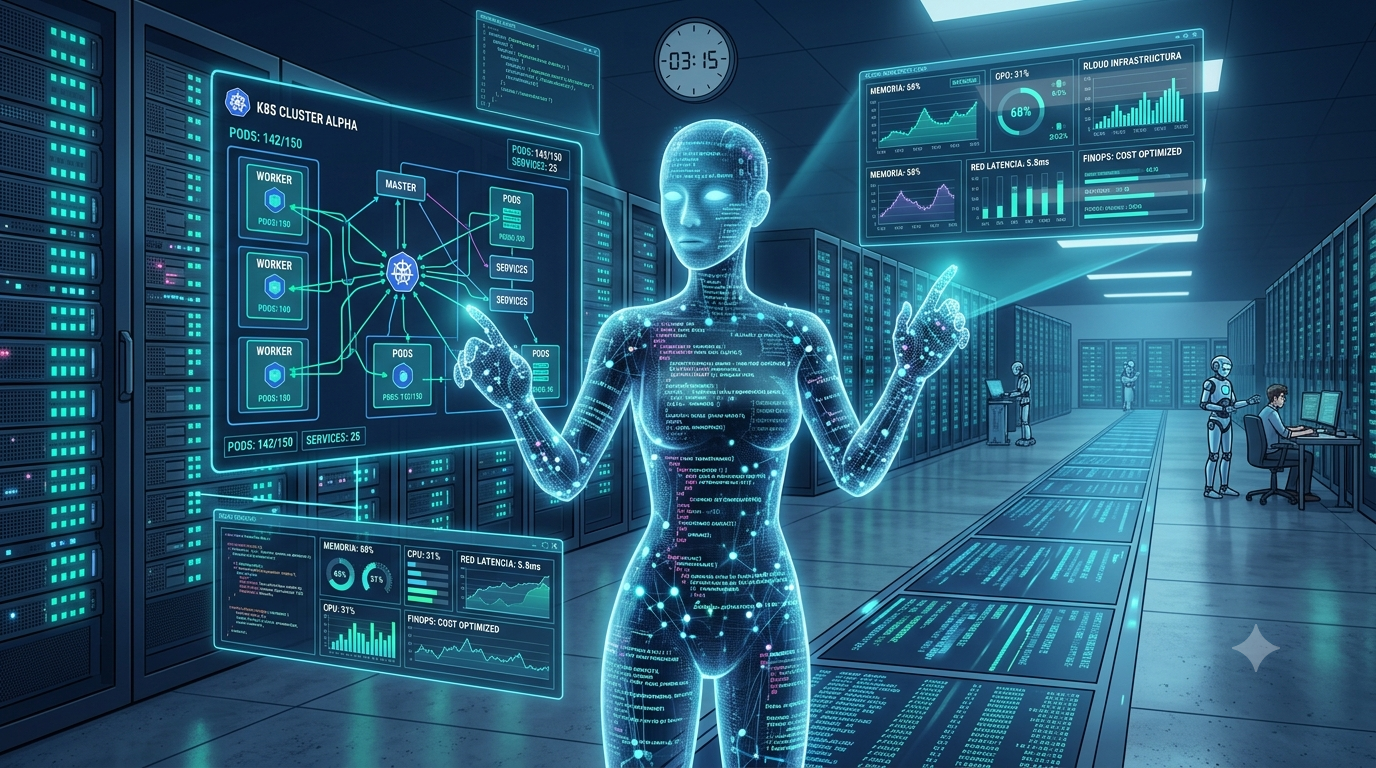
Imagina la siguiente escena: son las 3:14 de la mañana de un domingo. En el tablero de control de tu infraestructura cloud, un microservicio de autenticación sufre un pico inesperado de latencia. Un búfer de memoria se satura, el balanceador de carga empieza a descartar peticiones y las alertas inundan el canal de operaciones.
En el escenario tradicional, el teléfono del ingeniero de guardia sonaría con un tono estridente, despertándolo para iniciar un diagnóstico a toda prisa bajo la presión del tiempo de caída (downturn).
Sin embargo, en la arquitectura moderna impulsada por Agentic AI (Inteligencia Artificial Basada en Agentes), la secuencia ocurre de forma muy diferente: un agente autónomo analiza las trazas distribuidas en tiempo real, identifica la fuga de memoria en la versión recién desplegada, ejecuta un rollback controlado al contenedor previo, reajusta el escalado horizontal en Kubernetes y deja redactado un informe detallado post-mortem en el repositorio de código. Todo en cuestión de 45 segundos y sin que nadie haya tenido que interrumpir su sueño.
La inteligencia artificial ha dejado de ser una simple interfaz de texto que responde a nuestras preguntas para transformarse en un motor de acción proactivo capaz de orquestar entornos distribuidos complejos.
Del chatbot pasivo al agente que toma el control del shell
Durante los últimos años, el uso de la IA en la administración de sistemas y DevOps se limitaba a modelos generativos a los que consultábamos comandos de terminal como kubectl o configuraciones complejas de Terraform. Era un modelo pasivo: el usuario preguntaba, la IA proponía un script y el humano lo ejecutaba en el entorno.
La evolución hacia los agentes autónomos (Agentic AI) cambia las reglas del juego. Estos sistemas no solo «saben» sintaxis, sino que disponen de un bucle de percepción, decisión y ejecución (Perceive-Reason-Act):
- Conexión profunda con la infraestructura: Se integran mediante protocolos estandarizados (como el Model Context Protocol o APIs de observabilidad como Prometheus y Datadog).
- Autonomía supervisada: Poseen permisos controlados para ejecutar comandos en el CLI, desplegar manifiestos, modificar reglas de grupos de seguridad o ajustar llamadas de red.
- Tolerancia a errores y autocorrección: Si una acción de recuperación falla, el agente evalúa la nueva respuesta de la terminal, formula una hipótesis secundaria y corrige su estrategia sobre la marcha.
«Un LLM tradicional te dice cómo apagar un fuego en el servidor; un agente autónomo coge el extintor, apaga la llama y cambia la manguera defectuosa antes de que salte la alarma.»
La arquitectura interna: ¿Cómo razona un SysAdmin sintético?
Para que un agente tome decisiones en un clúster sin convertir la infraestructura en un terreno baldío, su diseño requiere una arquitectura dividida en tres capas principales:
- Capa de Observabilidad (Percepción): Consume métricas, eventos (logs) y trazas de tiempo real. El agente no busca patrones de texto simples, sino que interpreta la topología del clúster y detecta anomalías contextuales.
- Motor de Razonamiento y Planificación: Utiliza técnicas de razonamiento en cadena (Chain of Thought) para descomponer una incidencia compleja en subsistemas. Si el uso de CPU está al 99 %, el agente investiga primero si se debe a un ataque DDoS, una consulta SQL ineficiente o un bucle infinito en el código antes de decidir si debe escalar más nodos.
- Capa de Ejecución y Validaciones (Guardrails): Es el cortafuegos ético y técnico. Antes de lanzar un comando destructivo como
rm -rfo modificar una base de datos en producción, el agente valida la orden contra políticas de seguridad estrictas (usando marcos de control como Open Policy Agent).
Un caso práctico de auto-recuperación (Self-Healing)
Consideremos un fallo típico de escalabilidad:
[Métrica] Latencia API > 2500ms -> [Agente detecta anomalia]
    │
    ├──> [Consulta trazas en Jaeger] -> Detecta cuello de botella en BD
    ├──> [Analiza métricas de Pods]  -> Identifica saturación de conexiones
    ├──> [Acción 1] -> Incrementa el pool de conexiones en la config del Pod
    ├──> [Acción 2] -> Lanza 3 réplicas adicionales en Kubernetes
    └──> [Verificación] -> Latencia se estabiliza a 45ms. Incidencia resuelta.
Esta capacidad de respuesta reduce el índice MTTR (Mean Time to Repair) de horas a escasos segundos, minimizando el impacto financiero del tiempo de inactividad.
El nuevo rol del ingeniero: De bombero a arquitecto de gobernanza
Existe una duda legítima en la comunidad: ¿significa esto que la IA va a reemplazar a las plantillas de infraestructura? La experiencia práctica demuestra lo contrario. La adopción de agentes autónomos no elimina la necesidad de expertos en sistemas, sino que eleva la barra de su trabajo.
Los ingenieros de infraestructura están dejando de pasar horas rastreando archivos de registro (log files) a medianoche para convertirse en diseñadores de políticas y supervisores de gobernanza. El trabajo diario se desplaza hacia:
- Definición de límites operativos (Guardrails): Especificar qué acciones puede tomar el agente de forma autónoma y cuáles requieren confirmación humana.
- Auditoría de seguridad y cumplimiento: Verificar que las acciones tomadas por la IA cumplan con las normativas ISO, SOC2 o GDPR.
- Optimización de costes (FinOps): Configurar agentes dedicados exclusivamente a apagar recursos infrautilizados o negociar instancias reservadas en tiempo real.
El desafío: Seguridad, alucinaciones y el factor «caja negra»
No todo son ventajas en el horizonte de la automatización total. Entregar las llaves de acceso de tu infraestructura en la nube a un agente de IA entraña riesgos notables que la industria está abordando a marchas forzadas:
- Alucinaciones operativas: Un modelo que interprete incorrectamente el estado de un volumen de almacenamiento podría desaprovisionar discos en uso por error.
- Inyección de Prompts indirecta: Si un atacante logra escribir instrucciones maliciosas dentro de los logs del sistema que luego son procesados por el agente, podría manipular las decisiones de la IA para elevar privilegios.
- Falta de trazabilidad: Es crucial que cada acción ejecutada por un agente quede registrada de forma inalterable para poder realizar auditorías post-incidente.
¿Hacia dónde nos dirigimos?
La administración de sistemas está viviendo su mayor revolución desde la llegada de la propia nube y la infraestructura como código (IaC). Pasar de configurar servidores a mano a escribir código con Terraform fue el primer gran salto; el siguiente es delegar la gestión del estado dinámico del sistema a agentes inteligentes capaces de aprender y adaptarse a la demanda.
La tecnología está lista y las primeras herramientas ya están operando en producción. La pregunta ya no es si la IA administrará nuestros clústeres, sino qué nivel de confianza le otorgaremos en nuestras arquitecturas corporativas.
¿Has probado ya algún agente autónomo para la gestión de tus servidores o prefieres mantener el control manual en la terminal? ¡Te leo en los comentarios para debatir sobre cómo imaginas el futuro del DevOps!
Deja una respuesta