Etiqueta: RAG

  • ¿Por qué montar otra base de datos si ya tienes PostgreSQL? La revolución del vector search nativo

    ¿Por qué montar otra base de datos si ya tienes PostgreSQL? La revolución del vector search nativo

    Imagina que estás construyendo una aplicación moderna impulsada por Inteligencia Artificial —digamos, un sistema de recomendación inteligente o un motor de Búsqueda Aumentada por Generación (RAG). La receta clásica hasta hace poco era: guarda tus datos relacionales de usuarios, compras y catálogo en PostgreSQL… y luego añade una infraestructura extra como Pinecone, Qdrant o Milvus para gestionar los embeddings vectoriales. ¿El resultado? Dos sistemas que mantener, doble coste de infraestructura, problemas de sincronización en tiempo real e inconsistencias entre la base de datos principal y el almacén vectorial.

    Aquí es donde entra el dilema de cualquier arquitecto de software: ¿realmente necesitamos añadir más piezas móviles a nuestra pila tecnológica sólo para hacer búsquedas por similitud semántica?

    (más…)
  • PostgreSQL y el reto vectorial: cuando la base de datos de toda la vida se atreve con la IA multimodal

    PostgreSQL y el reto vectorial: cuando la base de datos de toda la vida se atreve con la IA multimodal

    Si llevas unos cuantos años trasteando con bases de datos, sabrás que PostgreSQL es como ese martillo suizo que nunca te falla. ¿Tablas relacionales? Check. ¿JSON semiestructurado? Check. ¿Geolocalización con PostGIS? Check. Sin embargo, la revolución de la inteligencia artificial generativa nos ha planteado un problema que las bases de datos tradicionales no sabían gestionar bien: cómo almacenar, indexar y consultar embeddings vectoriales a gran escala sin tener que meter con calzador sistemas externos.

    Hasta hace muy poco, cuando diseñábamos una arquitectura orientada a búsqueda semántica o RAG (Retrieval-Augmented Generation), nos veíamos obligados a bifurcar nuestros datos. Guardábamos los datos estructurados en nuestra base de datos relacional de confianza y enviábamos las representaciones numéricas de nuestros textos, imágenes o audios (los famosos vectores de alta dimensión) a una base de datos vectorial dedicada.

    Esta fragmentación traía consigo el clásico dolor de cabeza de la sincronización de datos: transacciones distribuidas, latencias adicionales de red, problemas de consistencia eventual y la complejidad operativa de mantener dos infraestructuras completamente distintas. Para solucionarlo en el ecosistema Postgres solíamos recurrir a la extensión pgvector. Funcionaba genial para casos iniciales, pero a medida que los embeddings crecían en dimensiones y la multimodalidad (texto, visión y audio combinados) se volvía la norma, los índices vectoriales basados en memoria comenzaban a resentirse en rendimiento e integración con el planificador de consultas SQL.

    (más…)
  • El lado oscuro del RAG: Cuando el ‘Prompt Injection’ secuestra tus bases de datos vectoriales

    El lado oscuro del RAG: Cuando el ‘Prompt Injection’ secuestra tus bases de datos vectoriales

    Imagínate que montas el sistema definitivo de atención al cliente para tu empresa. Has configurado un modelo de lenguaje espectacular y, para evitar que alucine más de la cuenta, le has acoplado una flamante base de datos vectorial mediante la técnica RAG (Generación Aumentada por Recuperación). Todo es felicidad, eficiencia y código limpio… hasta que un usuario malintencionado decide subir un documento de apariencia inocente. De repente, tu IA empieza a insultar a los clientes o, peor aún, a escupir secretos comerciales en el chat público. ¿Qué ha fallado si tus instrucciones del sistema (system prompts) estaban blindadas? Bienvenido a la evolución del Prompt Injection: el ataque indirecto a través de bases de datos vectoriales.

    (más…)
  • El laberinto de las mil dimensiones: Por qué las bases de datos vectoriales nativas son los nuevos motores de la IA

    El laberinto de las mil dimensiones: Por qué las bases de datos vectoriales nativas son los nuevos motores de la IA

    Imagina que decides organizar la biblioteca de tu casa. Tienes dos opciones. La clásica: ordenar los libros por orden alfabético del autor o por el código ISBN. Es un sistema eficiente, cuadriculado y predecible. Si buscas «Cervantes», vas a la C y ahí está. Pero ahora imagina que llega un amigo y te dice: «Oye, búscame un libro que deje una sensación de melancolía tecnológica, que hable de la soledad en ciudades futuristas y donde los coches vuelen pero de forma un poco decadente». Tu orden alfabético acaba de explotar en mil pedazos. No hay un campo «sentimiento» en el código de barras, ni un índice relacional clásico que entienda la sutil analogía entre la decadencia y un coche volador.

    (más…)
  • ¿Quién necesita la nube? SQLite y la rebelión de la IA local

    ¿Quién necesita la nube? SQLite y la rebelión de la IA local

    A veces, en informática, nos obsesionamos con «escalar» hasta las estrellas. Si hablamos de Inteligencia Artificial y RAG (Generación Aumentada por Recuperación), la inercia nos empuja a pensar en clusters masivos, infraestructuras en la nube y facturas mensuales que quitan el hipo. Pero, ¿y si te dijera que la herramienta que ya llevas en el bolsillo (literalmente, está en tu móvil) es ahora mismo el motor más eficiente para ejecutar IA local? Sí, hablamos de SQLite.

    (más…)
  • La Wikipedia se vuelve «IA-First»: Cuando el conocimiento libre dejó de ser solo texto para ser inteligente

    La Wikipedia se vuelve «IA-First»: Cuando el conocimiento libre dejó de ser solo texto para ser inteligente

    Imagina que estás intentando resolver una discusión de bar sobre qué procesadores de los últimos diez años tienen un TDP inferior a 65W pero más de 8 núcleos. Normalmente, te tocaría abrir diecisiete pestañas de la Wikipedia, saltar entre tablas comparativas y, probablemente, acabar con un dolor de cabeza y ninguna respuesta clara. Hasta ahora, la Wikipedia era como una biblioteca infinita donde los libros son brillantes, pero el bibliotecario está mudo. Eso está a punto de cambiar radicalmente con la integración de la consulta semántica basada en IA.

    (más…)
  • Más allá del SQL: Por qué las Bases de Datos Vectoriales son el nuevo cerebro de la IA

    Más allá del SQL: Por qué las Bases de Datos Vectoriales son el nuevo cerebro de la IA

    ¿Alguna vez has intentado explicarle a una base de datos relacional convencional cómo se «siente» una puesta de sol o por qué una línea de código es similar a otra aunque usen sintaxis distintas? Si lo intentas con SQL, probablemente acabes con un error de sintaxis o una consulta eterna que no lleva a ninguna parte. El problema es que nuestras bases de datos tradicionales son expertas en datos estructurados (filas y columnas), pero la Inteligencia Artificial necesita algo más: necesita contexto semántico.

    (más…)
  • La Cruda Realidad Empresarial: Por Qué el 95% del Dinero en IA Generativa se Pierde en el Pantano de los Datos Sucios

    La Cruda Realidad Empresarial: Por Qué el 95% del Dinero en IA Generativa se Pierde en el Pantano de los Datos Sucios

    Problema: La **Inteligencia Artificial Generativa (IAG)** llegó a la empresa con promesas de productividad inédita. CEOs y juntas directivas han abierto la chequera, anticipando el inmenso Retorno de la Inversión (ROI) que se estima en billones a nivel global. Sin embargo, un número creciente de informes, incluyendo estudios del MIT, sugiere una realidad alarmante: la gran mayoría de los pilotos de IAG corporativos no logran generar valor escalable, con cifras de hasta el 95% de los proyectos sin alcanzar el ROI esperado. ¿La razón? No es la sofisticación del modelo (GPT-4, Gemini, o cualquier LLM open-source), sino el fango digital que alimenta a la bestia: la calidad, gobernanza y arquitectura de los datos internos.


    (más…)
  • La Batalla Abierta de los LLMs: Por qué LLaMA 3 y Mistral Están Redefiniendo la Programación con IA

    La Batalla Abierta de los LLMs: Por qué LLaMA 3 y Mistral Están Redefiniendo la Programación con IA

    La Batalla Abierta de los LLMs: Por qué LLaMA 3 y Mistral Están Redefiniendo la Programación con IA

    El Problema del «Caja Negra» en la Era de la Inteligencia Artificial Generativa

    Imagínese que su taller de programación, ese santuario de la lógica y la depuración, de repente depende de una herramienta mágica, potentísima, pero completamente cerrada. Una «caja negra» donde introduce datos y obtiene resultados brillantes, pero cuyo funcionamiento interno es un secreto corporativo bien guardado.

    Esa ha sido, hasta hace poco, la incómoda realidad para muchos desarrolladores inmersos en el boom de la Inteligencia Artificial Generativa. Depender de APIs de modelos gigantescos y propietarios (los conocidos LLMs o Large Language Models) implica una triple barrera: coste, latencia y, lo más crítico, la falta de control técnico. ¿Cómo depurar un comportamiento inesperado si no puede inspeccionar el motor? ¿Cómo innovar si está atado a las decisiones de licenciamiento y la hoja de ruta de una sola empresa?

    Desmitificando el Open Source en Modelos de Lenguaje

    Esta dependencia ha generado una tensión palpable en la comunidad. Los desarrolladores somos, por naturaleza, hackers y constructores. Necesitamos tocar el silicio y la lógica que estamos utilizando. Aquí es donde entra en juego la actual «guerra del código abierto» de los LLMs.

    En esencia, un modelo de lenguaje de código abierto no implica necesariamente que sea «gratis» en términos de coste de infraestructura (entrenar estos gigantes requiere clusters de GPUs valorados en millones), pero sí que el peso del modelo (los archivos con todos sus parámetros entrenados) y, en muchos casos, el código de inferencia y las arquitecturas subyacentes, son liberados bajo licencias permisivas (como Apache 2.0 o customizadas, como las de Meta).

    Analogía del Chef: Si los modelos propietarios son restaurantes de alta cocina con recetas secretas (solo pide y coma), los LLMs open source son kits de cocina completos. Le dan los ingredientes, la receta detallada e incluso las herramientas. Puede replicar el plato, modificarlo o usar esos ingredientes para crear algo completamente nuevo.

    El Triunvirato Open Source

    La explosión de modelos abiertos de alta calidad ha sido impulsada principalmente por tres gigantes —y un contendiente clave— que han entendido el valor de la comunidad y la iteración rápida:

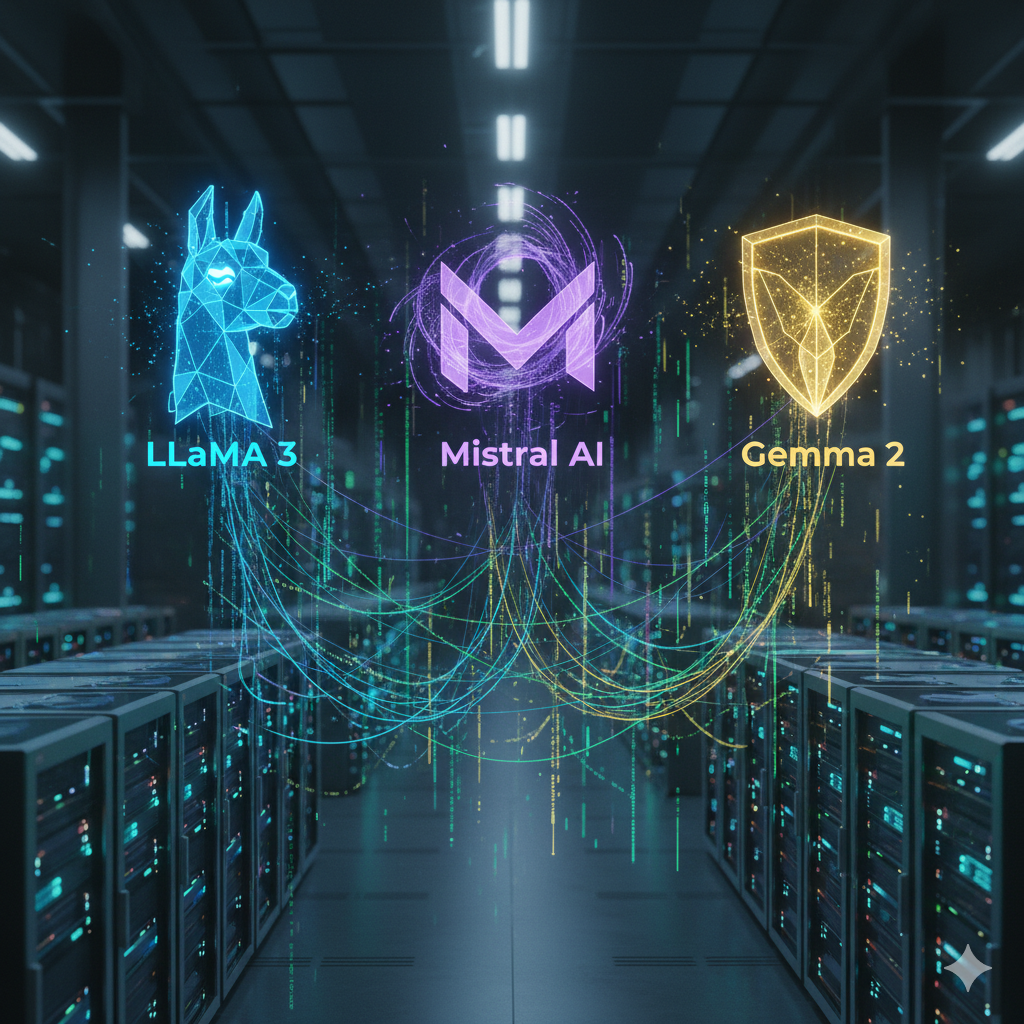
    • LLaMA (Meta): El gran catalizador. Sus versiones, especialmente la reciente LLaMA 3, han demostrado que un modelo de código abierto no tiene nada que envidiar en rendimiento a muchos de sus pares cerrados. Su arquitectura y la metodología de entrenamiento se han convertido en la base sobre la que se construyen miles de modelos derivados (finetuning).
    • Mistral AI (Francia): La startup que puso el rigor científico y la eficiencia en el mapa. Modelos como Mixtral-8x22B han popularizado la arquitectura de Mixture of Experts (MoE), un diseño que permite a los modelos ser gigantescos en parámetros, pero sorprendentemente rápidos y económicos en inferencia. Es como tener un equipo de ocho especialistas que solo trabajan cuando su experiencia es requerida. Eficiencia en estado puro.
    • Gemma (Google DeepMind): El aporte de Google, construido a partir de la misma tecnología que sus modelos flagship (como Gemini), pero liberado en un formato más ligero y fácil de ejecutar, como Gemma 2. Su foco en la seguridad y las directrices de IA responsable lo convierten en una opción robusta para entornos académicos y corporativos.

    Esta competencia no solo ha abaratado la investigación, sino que ha creado un ecosistema donde la velocidad de mejora es vertiginosa. Se ha demostrado que una comunidad de programación descentralizada puede, en conjunto, superar o igualar la calidad de los laboratorios centralizados más grandes. Es la belleza del peer review a escala masiva.

    Solución Técnica: Flexibilidad, Privacidad y el Impacto en la Ingeniería de Software

    La disponibilidad de estos modelos abiertos resuelve de golpe varios retos técnicos que enfrentaba la programación con IA:

    1. Personalización Extrema (Finetuning y RAG)

    Con un modelo abierto, el desarrollador tiene el control total para refinarlo (finetuning) con sus propios datos. Esto es vital para las empresas que manejan terminología especializada (legal, médica, ingeniería) o tienen una identidad de marca única. En lugar de adaptar la empresa a la IA, adaptamos la IA a la empresa.

    Además, facilita enormemente la implementación de la Generación Aumentada por Recuperación (RAG). Podemos optimizar el modelo de base (el LLM) para que interactúe de forma más eficiente con nuestros vectores de conocimiento interno, creando asistentes de IA que realmente entienden el contexto de la organización.

    2. Soberanía de Datos y Privacidad (On-Premise)

    Una de las mayores ventajas es la posibilidad de ejecutar estos modelos on-premise o en su propia nube privada (un cluster de GPUs propio). Para sectores regulados (finanzas, defensa, salud), donde los datos no pueden, bajo ningún concepto, salir del perímetro de seguridad, esto no es solo una opción: es un requisito indispensable. La programación ya no está limitada por las políticas de privacidad de un tercero.

    3. El Desafío de la Inferencia Paralela

    Modelos como Mixtral, con su arquitectura MoE, han obligado a los ingenieros de sistemas a replantearse cómo se gestiona la inferencia paralela. Un cluster de GPUs debe ser capaz de direccionar la carga de trabajo dinámicamente, asegurando que solo el «experto» necesario sea activado, optimizando el uso de memoria y la velocidad de respuesta. Esto está forzando innovaciones en frameworks de despliegue como vLLM y TGI (Text Generation Inference).

    ¿Ya has probado esta herramienta? Te recomendamos echar un vistazo a Hugging Face Transformers para un sandbox rápido con estos modelos y a vLLM si buscas optimizar la inferencia con clusters de GPUs.

    Más Allá de la Programación

    Esta batalla de código abierto es un triunfo para el desarrollador. Ha democratizado el acceso a la tecnología de frontera y ha generado una comunidad activa, curiosa y técnicamente formidable. El foco ha pasado de «¿Qué puede hacer el modelo X?» a «¿Cómo puedo modificar el modelo Y para que haga exactamente lo que necesito en mi entorno?».

    El rol del experto informático está evolucionando. Ya no somos solo consumidores de APIs; nos estamos convirtiendo en arquitectos de soluciones de IA, eligiendo, ajustando y manteniendo los motores de IA, tal como gestionamos nuestras bases de datos o nuestros sistemas distribuidos.

    El futuro de la programación con IA reside en esta flexibilidad. La velocidad con la que Mistral, LLaMA, y Gemma se mejoran y se adaptan a nuevos datasets es una prueba de que la colaboración abierta, impulsada por la pasión técnica y el rigor informático, siempre será la fórmula más potente para la innovación.

    Te leo en los comentarios si usas una alternativa de código abierto o si tienes algún truco de finetuning que crees que la comunidad debería conocer. ¡Aquí puedes acceder al código de ejemplo en GitHub!
  • ¿Tu IA se pierde? El secreto no está en los datos, sino en cómo los ordenas: bienvenido a las bases de datos vectoriales

    ¿Tu IA se pierde? El secreto no está en los datos, sino en cómo los ordenas: bienvenido a las bases de datos vectoriales

    ¿Alguna vez te has preguntado cómo es posible que ChatGPT recuerde vuestra conversación anterior o cómo un buscador de imágenes puede encontrar una foto de «un perro con sombrero de vaquero» aunque nunca hayas escrito esas palabras exactas? La respuesta no es magia, aunque lo parezca. Es una revolución silenciosa que está ocurriendo en el trastero de la inteligencia artificial: las bases de datos vectoriales. Si creías que las bases de datos eran aburridas listas en SQL, prepárate, porque estamos a punto de entrar en una nueva dimensión. Literalmente.

    (más…)