Etiqueta: Pinecone

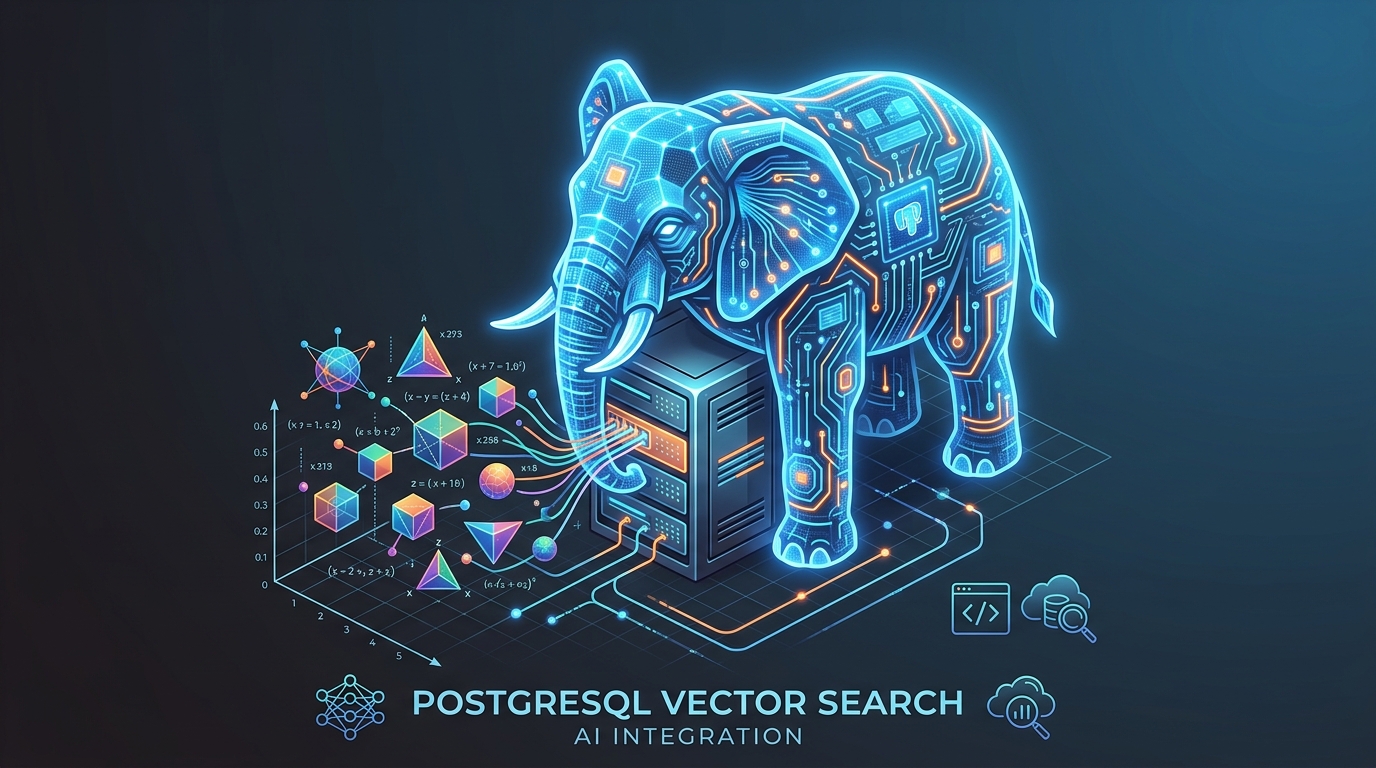
  • ¿Por qué montar otra base de datos si ya tienes PostgreSQL? La revolución del vector search nativo

    ¿Por qué montar otra base de datos si ya tienes PostgreSQL? La revolución del vector search nativo

    Imagina que estás construyendo una aplicación moderna impulsada por Inteligencia Artificial —digamos, un sistema de recomendación inteligente o un motor de Búsqueda Aumentada por Generación (RAG). La receta clásica hasta hace poco era: guarda tus datos relacionales de usuarios, compras y catálogo en PostgreSQL… y luego añade una infraestructura extra como Pinecone, Qdrant o Milvus para gestionar los embeddings vectoriales. ¿El resultado? Dos sistemas que mantener, doble coste de infraestructura, problemas de sincronización en tiempo real e inconsistencias entre la base de datos principal y el almacén vectorial.

    Aquí es donde entra el dilema de cualquier arquitecto de software: ¿realmente necesitamos añadir más piezas móviles a nuestra pila tecnológica sólo para hacer búsquedas por similitud semántica?

    (más…)
  • El laberinto de las mil dimensiones: Por qué las bases de datos vectoriales nativas son los nuevos motores de la IA

    El laberinto de las mil dimensiones: Por qué las bases de datos vectoriales nativas son los nuevos motores de la IA

    Imagina que decides organizar la biblioteca de tu casa. Tienes dos opciones. La clásica: ordenar los libros por orden alfabético del autor o por el código ISBN. Es un sistema eficiente, cuadriculado y predecible. Si buscas «Cervantes», vas a la C y ahí está. Pero ahora imagina que llega un amigo y te dice: «Oye, búscame un libro que deje una sensación de melancolía tecnológica, que hable de la soledad en ciudades futuristas y donde los coches vuelen pero de forma un poco decadente». Tu orden alfabético acaba de explotar en mil pedazos. No hay un campo «sentimiento» en el código de barras, ni un índice relacional clásico que entienda la sutil analogía entre la decadencia y un coche volador.

    (más…)
  • Más allá del SQL: Por qué las Bases de Datos Vectoriales son el nuevo cerebro de la IA

    Más allá del SQL: Por qué las Bases de Datos Vectoriales son el nuevo cerebro de la IA

    ¿Alguna vez has intentado explicarle a una base de datos relacional convencional cómo se «siente» una puesta de sol o por qué una línea de código es similar a otra aunque usen sintaxis distintas? Si lo intentas con SQL, probablemente acabes con un error de sintaxis o una consulta eterna que no lleva a ninguna parte. El problema es que nuestras bases de datos tradicionales son expertas en datos estructurados (filas y columnas), pero la Inteligencia Artificial necesita algo más: necesita contexto semántico.

    (más…)
  • ¿Tu IA se pierde? El secreto no está en los datos, sino en cómo los ordenas: bienvenido a las bases de datos vectoriales

    ¿Tu IA se pierde? El secreto no está en los datos, sino en cómo los ordenas: bienvenido a las bases de datos vectoriales

    ¿Alguna vez te has preguntado cómo es posible que ChatGPT recuerde vuestra conversación anterior o cómo un buscador de imágenes puede encontrar una foto de «un perro con sombrero de vaquero» aunque nunca hayas escrito esas palabras exactas? La respuesta no es magia, aunque lo parezca. Es una revolución silenciosa que está ocurriendo en el trastero de la inteligencia artificial: las bases de datos vectoriales. Si creías que las bases de datos eran aburridas listas en SQL, prepárate, porque estamos a punto de entrar en una nueva dimensión. Literalmente.

    (más…)