Imagina que decides organizar la biblioteca de tu casa. Tienes dos opciones. La clásica: ordenar los libros por orden alfabético del autor o por el código ISBN. Es un sistema eficiente, cuadriculado y predecible. Si buscas «Cervantes», vas a la C y ahí está. Pero ahora imagina que llega un amigo y te dice: «Oye, búscame un libro que deje una sensación de melancolía tecnológica, que hable de la soledad en ciudades futuristas y donde los coches vuelen pero de forma un poco decadente». Tu orden alfabético acaba de explotar en mil pedazos. No hay un campo «sentimiento» en el código de barras, ni un índice relacional clásico que entienda la sutil analogía entre la decadencia y un coche volador.
(más…)
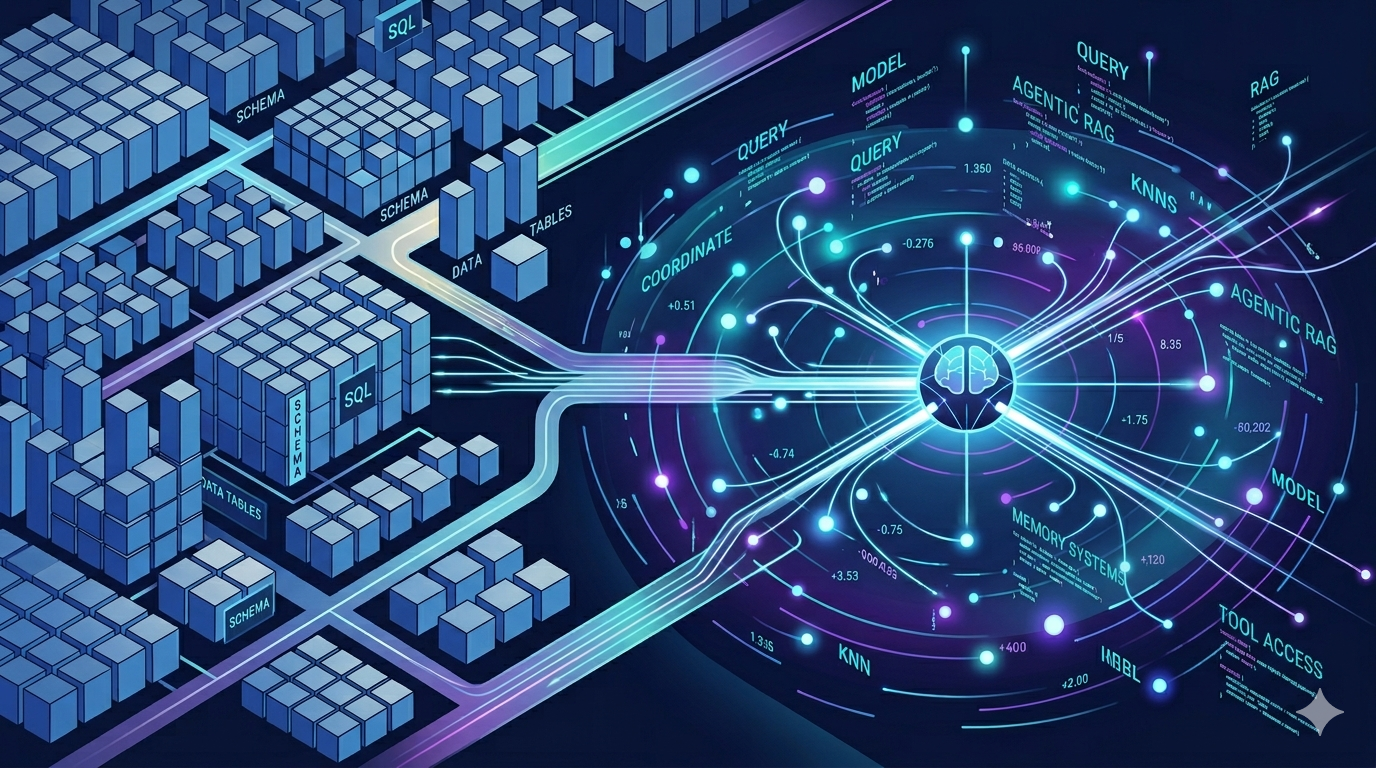
¿Alguna vez has intentado explicarle a una base de datos relacional convencional cómo se «siente» una puesta de sol o por qué una línea de código es similar a otra aunque usen sintaxis distintas? Si lo intentas con SQL, probablemente acabes con un error de sintaxis o una consulta eterna que no lleva a ninguna parte. El problema es que nuestras bases de datos tradicionales son expertas en datos estructurados (filas y columnas), pero la Inteligencia Artificial necesita algo más: necesita contexto semántico.
(más…)