Etiqueta: inteligencia artificial generativa

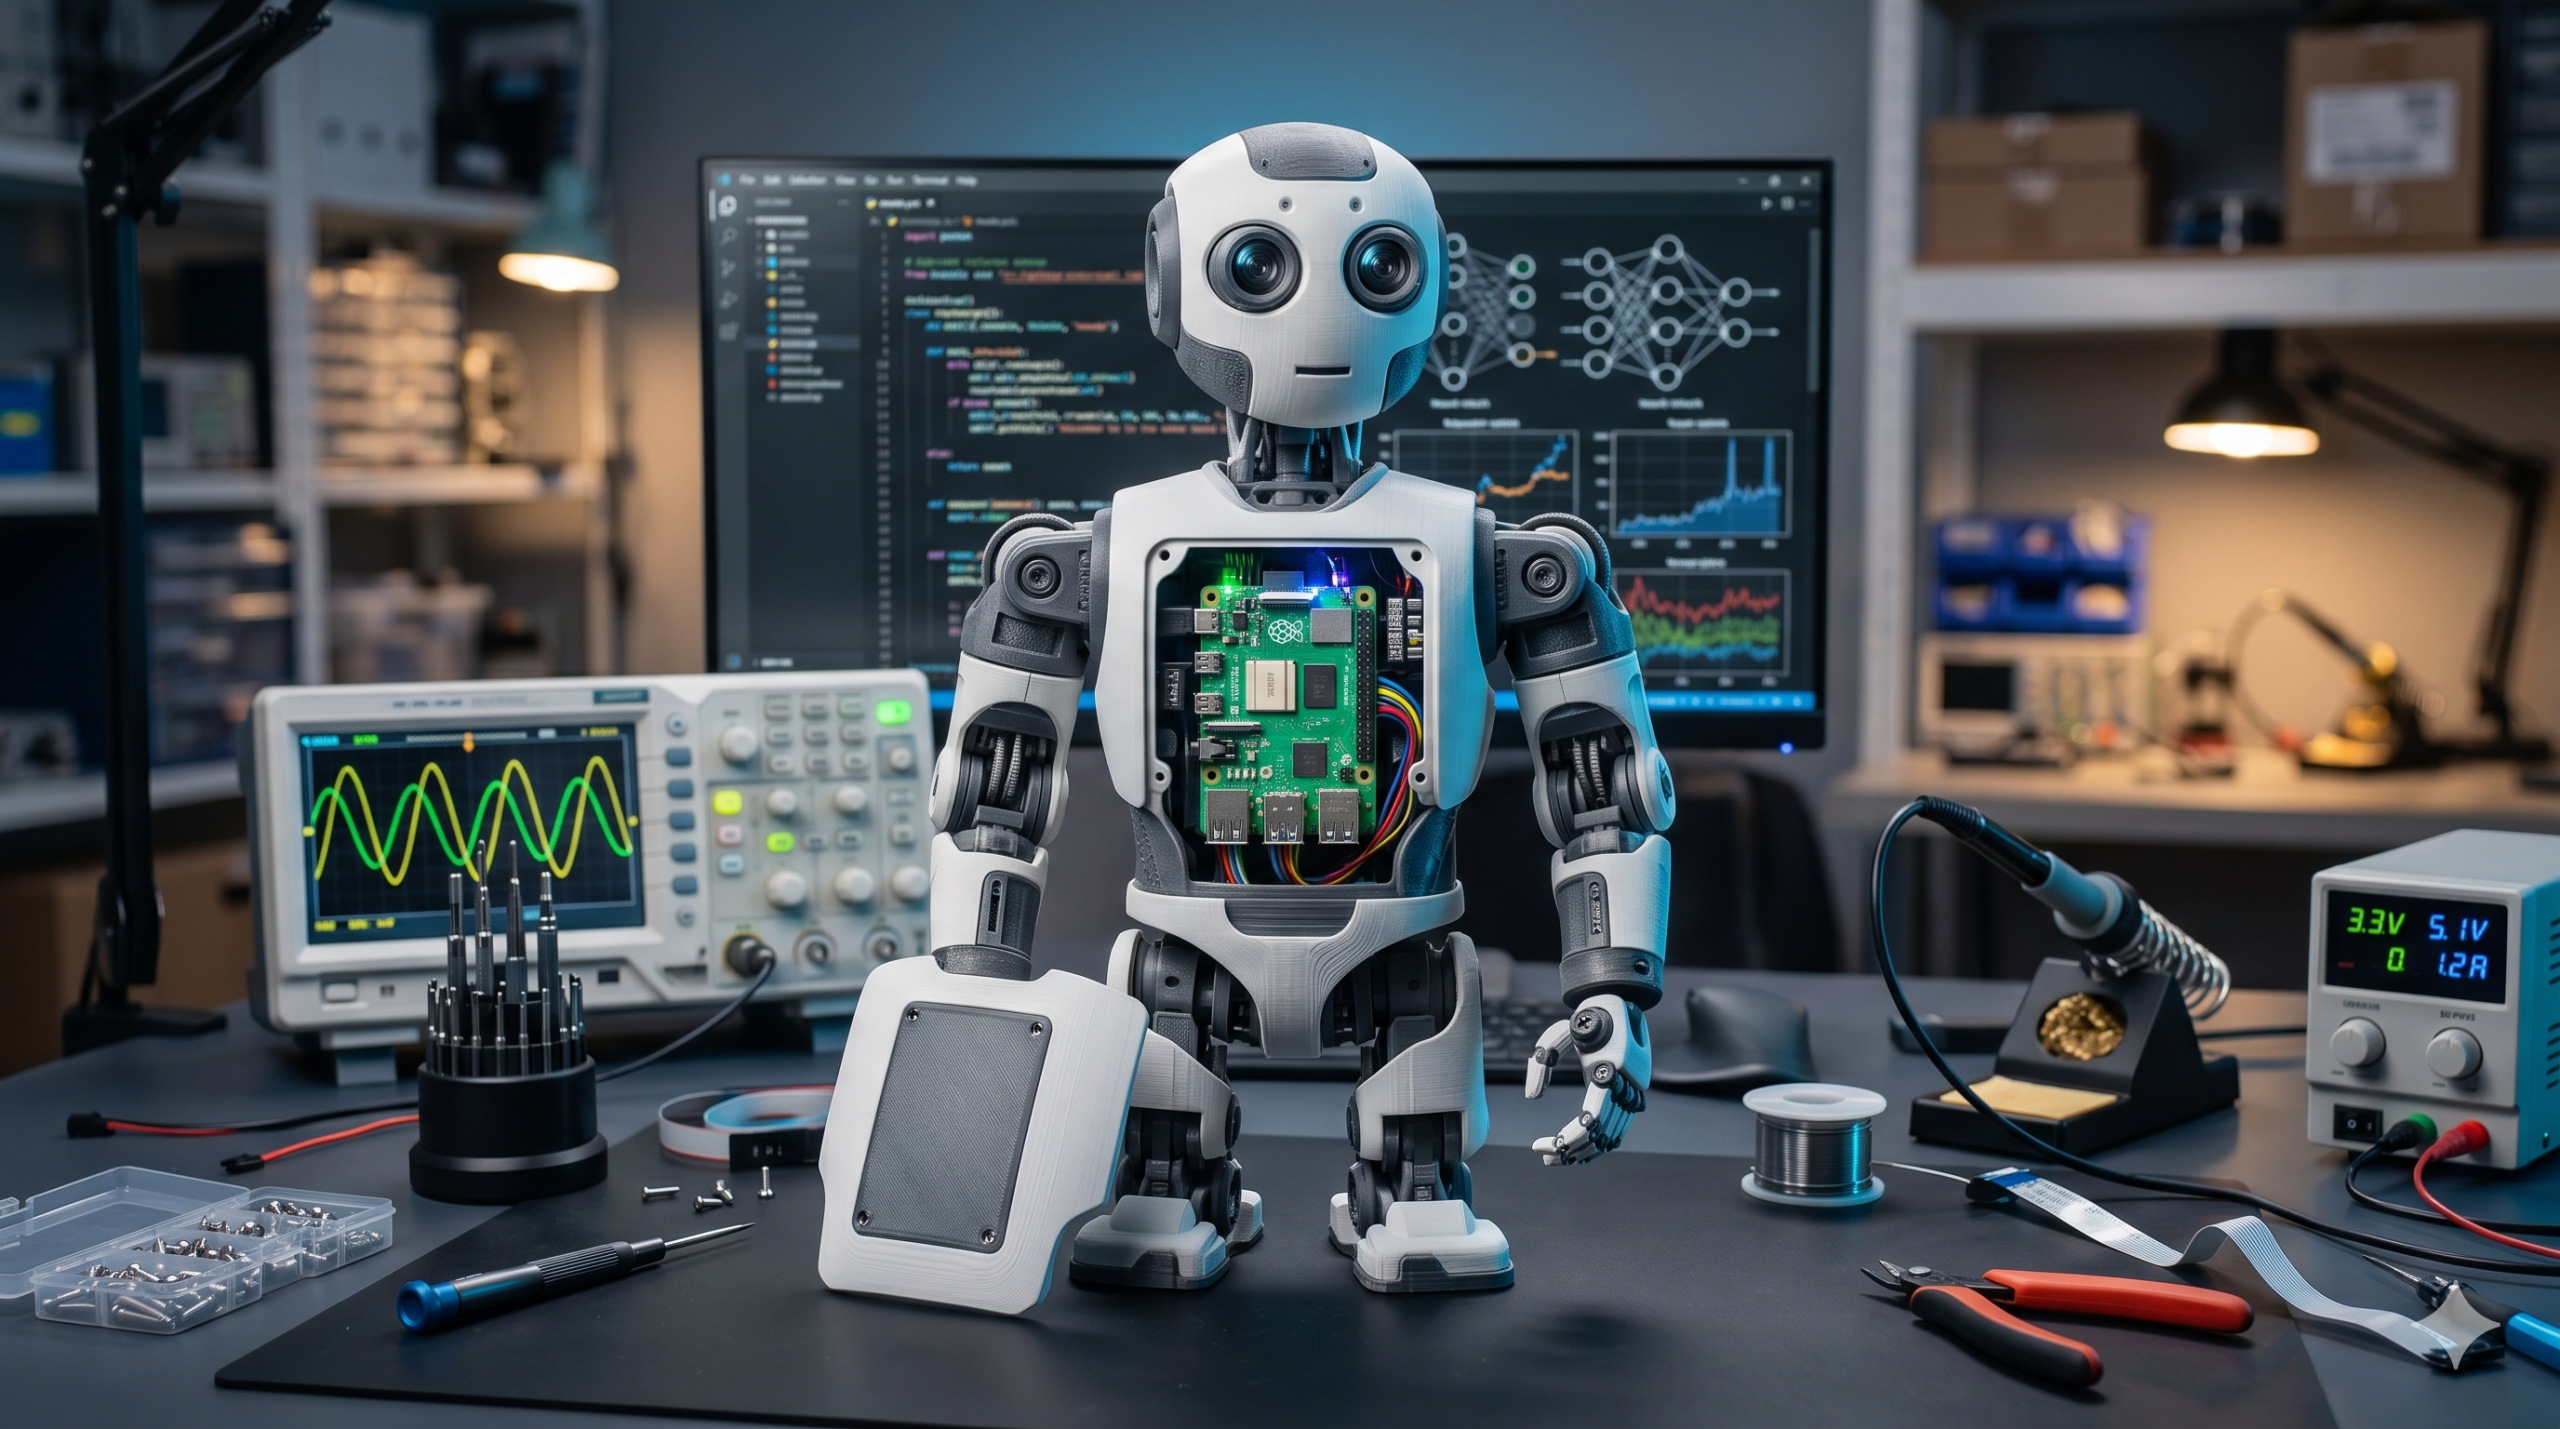
  • Robótica humanoide por menos de lo que cuesta una cena: El milagro de la Raspberry Pi 5 y la IA local

    Robótica humanoide por menos de lo que cuesta una cena: El milagro de la Raspberry Pi 5 y la IA local

    ¿Te imaginas construir un robot bípedo capaz de reconocer tu cara, procesar redes neuronales en tiempo real y esquivar al gato, todo ello sin depender de una suscripción mensual a la nube de un gigante tecnológico ni de un hardware que requiera vender un riñón en el mercado negro? Hasta hace nada, hablar de robótica humanoide con visión computacional implicaba adentrarse en el terreno de las placas de desarrollo industriales de cuatro cifras o conformarse con juguetes articulados que se limitaban a ejecutar secuencias de movimientos preprogramadas y bastante torpes. El verdadero dolor de cabeza de cualquier desarrollador o entusiasta del ecosistema maker no era diseñar las articulaciones, sino el «cuello de botella» de la computación: ¿cómo metes un cerebro con capacidad de inferencia paralela en un cuerpo que no puede cargar con una batería de coche ni disipar el calor de una GPU de gama alta?

    (más…)
  • Grokipedia y la automatización del conocimiento

    Grokipedia y la automatización del conocimiento

    Imagina que estás intentando programar un microservicio en PHP 8.4 utilizando un nuevo framework experimental y necesitas consultar la documentación de referencia actualizada hace escasamente cinco minutos. Acudes a la enciclopedia colaborativa de toda la vida y te encuentras con que la página no existe, está desactualizada o un moderador ha decidido borrarla porque el framework aún no se considera «lo suficientemente relevante». Este clásico cuello de botella en la curación del conocimiento humano es el problema al que se enfrentan millones de desarrolladores y usuarios sedientos de información en tiempo real. La velocidad a la que avanza la tecnología ha superado por completo la capacidad de los editores humanos para redactar, verificar y estructurar la información de manera síncrona.

    (más…)
  • La potencia oculta de tu navegador: Cómo WebGPU permite ejecutar IA al 100% en local

    La potencia oculta de tu navegador: Cómo WebGPU permite ejecutar IA al 100% en local

    Admitámoslo: todos hemos experimentado esa mezcla de fascinación y escalofrío al enviar datos confidenciales de nuestra empresa o proyectos personales a las APIs de los gigantes tecnológicos. «¿Dónde terminará este prompt?», te preguntas mientras miras el cursor parpadear. Hasta hace nada, la alternativa para mantener la privacidad absoluta era montar un búnker digital: comprar una gráfica de mil euros, pelearte con drivers de CUDA defectuosos en Linux y rezar para que tu fuente de alimentación no salga ardiendo al cargar un modelo de lenguaje. Una barrera de entrada elitista que dejaba fuera al desarrollador de a pie y al usuario común.

    (más…)
  • El milagro de la cuantización extrema: Cómo meter un LLM gigante en la CPU de tu patinete eléctrico (o casi)

    El milagro de la cuantización extrema: Cómo meter un LLM gigante en la CPU de tu patinete eléctrico (o casi)

    Imaginas que mañana decides montar un centro de datos en tu propia casa para correr una Inteligencia Artificial de última generación. Vas a tu tienda de hardware de confianza, miras el precio de un clúster de GPUs de nivel empresarial y, de repente, vender un riñón ya no te parece una mala idea financiera. Hasta hace dos días, si querías ejecutar un modelo de lenguaje (LLM) con cara y ojos de manera local, o tenías una tarjeta gráfica que consumías más energía que una pequeña ciudad del norte de España, o estabas condenado a ver cómo tu ordenador procesaba un token cada tres minutos. La dependencia de las API de pago y de los servidores en la nube parecía el único camino para los mortales. Sin embargo, la comunidad del open source se ha cansado de pedir permiso (y créditos bancarios) a las grandes tecnológicas.

    El cuello de botella de la IA generativa local nunca ha sido únicamente la potencia de cálculo bruta, sino algo mucho más mundano: la memoria RAM y el ancho de banda. Cuando descargamos un modelo de lenguaje convencional, nos encontramos con gigabytes y gigabytes de coeficientes numéricos llamados «parámetros». Originalmente, estos pesos se guardan en formatos de alta precisión, como FP16 (punto flotante de 16 bits). Hagan las matemáticas conmigo, queridos desarrolladores: un modelo modesto de 70.000 millones de parámetros (70B) en FP16 requiere algo más de 140 GB de VRAM solo para cargarse en memoria. Eso descarta automáticamente al 99% de los ordenadores del planeta. Durante el proceso de inferencia paralela, la CPU o la GPU tienen que mover continuamente todos esos gigabytes desde la memoria de almacenamiento hasta los registros del procesador. Es el clásico problema informático donde la autopista es demasiado estrecha para tanto tráfico.

    (más…)
  • El fin de las «alucinaciones» en código: ¿Por qué la inferencia paralela es el nuevo superpoder de los desarrolladores?

    El fin de las «alucinaciones» en código: ¿Por qué la inferencia paralela es el nuevo superpoder de los desarrolladores?

    Admitámoslo sin paños calientes: todos hemos sentido esa mezcla de emoción y pánico cuando le pedimos a un modelo de lenguaje que nos genere una función compleja en Python o TypeScript. Le das al intro, la Inteligencia Artificial empieza a escupir líneas de código a una velocidad endiablada y, por un segundo, te sientes en el año 2050. Pero la realidad suele ser más terca. Copias el código, lo pegas en tu entorno de desarrollo, le das a ejecutar y… ¡pum! Un precioso error de sintaxis o una variable inventada te explotan en la cara. La IA ha vuelto a alucinar.

    Este fenómeno, que convierte a los asistentes de código en compañeros brillantes pero a veces profundamente mentirosos, ha sido el gran cuello de botella para la adopción masiva de la inteligencia artificial generativa en entornos de producción críticos. Hasta ahora.

    Un consorcio internacional de investigadores y desarrolladores open source en IA acaba de presentar un enfoque revolucionario que promete erradicar estas alucinaciones sintácticas de raíz. ¿La clave? No se trata de hacer modelos más grandes, sino más inteligentes a la hora de pensar. Mediante una técnica denominada verificación sintáctica por inferencia paralela, los nuevos entornos de desarrollo integrados (IDEs) son capaces de auditar el código en un entorno aislado milisegundos antes de que aparezca impreso en tu pantalla.

    (más…)
  • ¿El tamaño realmente importa? Por qué las IA pequeñas (SLMs) están destronando a los gigantes de la nube

    ¿El tamaño realmente importa? Por qué las IA pequeñas (SLMs) están destronando a los gigantes de la nube

    ¿Estamos sufriendo de «gigantismo» en el mundo de la inteligencia artificial? Durante los últimos años, la narrativa dominante nos ha machacado con la idea de que, en el reino de la inteligencia artificial generativa, más grande siempre es mejor. Nos han vendido que si un modelo no tiene cientos de miles de millones de parámetros y no requiere un cluster de GPUs del tamaño de un campo de fútbol para pestañear, simplemente no sirve para nada. Pero mantén la calma y no empeñes tu casa para comprar acciones de proveedores de nube todavía. Está ocurriendo una revolución silenciosa, un cambio de paradigma donde David le está plantando cara a Goliat. Los Modelos de Lenguaje Pequeños (conocidos técnicamente como SLMs, o Small Language Models) están demostrando que la eficiencia matemática y una arquitectura bien pulida pueden humillar a la fuerza bruta de los centros de datos comerciales.

    (más…)
  • De escribir código a dirigir orquestas: La era del Ingeniero de Software «Prompt-First» con Copilot Workspace

    De escribir código a dirigir orquestas: La era del Ingeniero de Software «Prompt-First» con Copilot Workspace

    ¿Recuerdas cuando la mayor ayuda que teníamos en el IDE era un IntelliSense que a veces se volvía loco con los paréntesis? Pues saca el café de especialidad y siéntate, porque ese mundo se ha quedado en la prehistoria. GitHub acaba de dar un puñetazo sobre la mesa de nuestra oficina (virtual) con el despliegue de la autonomía total en Copilot Workspace.

    (más…)
  • El ‘Robo-Coder’ de DeepMind: ¿La IA es el futuro del Firmware y los Drivers?

    El ‘Robo-Coder’ de DeepMind: ¿La IA es el futuro del Firmware y los Drivers?

    El ‘Robo-Coder’ de DeepMind: ¿La IA es el futuro del Firmware y los Drivers?

    Cuando el Hardware Llama al Programador (Y Nadie Contesta)

    Cambiemos de tercio por un momento y pensemos en el talón de Aquiles de la innovación en hardware. Diseñar un chip es un triunfo de la ingeniería; construir un sistema que aproveche cada ciclo de reloj, es épico. Pero luego llega la parte menos glamurosa, y a menudo la más dolorosa: escribir el firmware y los drivers.

    (más…)
  • El Despertar de los Gigantes de Bolsillo: Por qué los SLMs son la Próxima Revolución Silenciosa de la IA<

    El Despertar de los Gigantes de Bolsillo: Por qué los SLMs son la Próxima Revolución Silenciosa de la IA<

    ¿Recordáis cuando los modelos de Inteligencia Artificial parecían el equivalente digital a un data center entero? Hablamos de esos Modelos de Lenguaje Grandes (LLMs) que acaparan titulares, que necesitan clusters de GPUs monstruosos para la inferencia y que viven cómodamente en la nube de algún gigante tecnológico. Son los Mamuts de la IA: impresionantes, poderosos, pero terriblemente glotones en términos de recursos.

    (más…)
  • La Cruda Realidad Empresarial: Por Qué el 95% del Dinero en IA Generativa se Pierde en el Pantano de los Datos Sucios

    La Cruda Realidad Empresarial: Por Qué el 95% del Dinero en IA Generativa se Pierde en el Pantano de los Datos Sucios

    Problema: La **Inteligencia Artificial Generativa (IAG)** llegó a la empresa con promesas de productividad inédita. CEOs y juntas directivas han abierto la chequera, anticipando el inmenso Retorno de la Inversión (ROI) que se estima en billones a nivel global. Sin embargo, un número creciente de informes, incluyendo estudios del MIT, sugiere una realidad alarmante: la gran mayoría de los pilotos de IAG corporativos no logran generar valor escalable, con cifras de hasta el 95% de los proyectos sin alcanzar el ROI esperado. ¿La razón? No es la sofisticación del modelo (GPT-4, Gemini, o cualquier LLM open-source), sino el fango digital que alimenta a la bestia: la calidad, gobernanza y arquitectura de los datos internos.


    (más…)