Etiqueta: IA generativa

  • El Espejo de Cristal de las Metrópolis: Cómo los Gemelos Digitales están Salvando nuestras Ciudades (y tus atascos)

    El Espejo de Cristal de las Metrópolis: Cómo los Gemelos Digitales están Salvando nuestras Ciudades (y tus atascos)

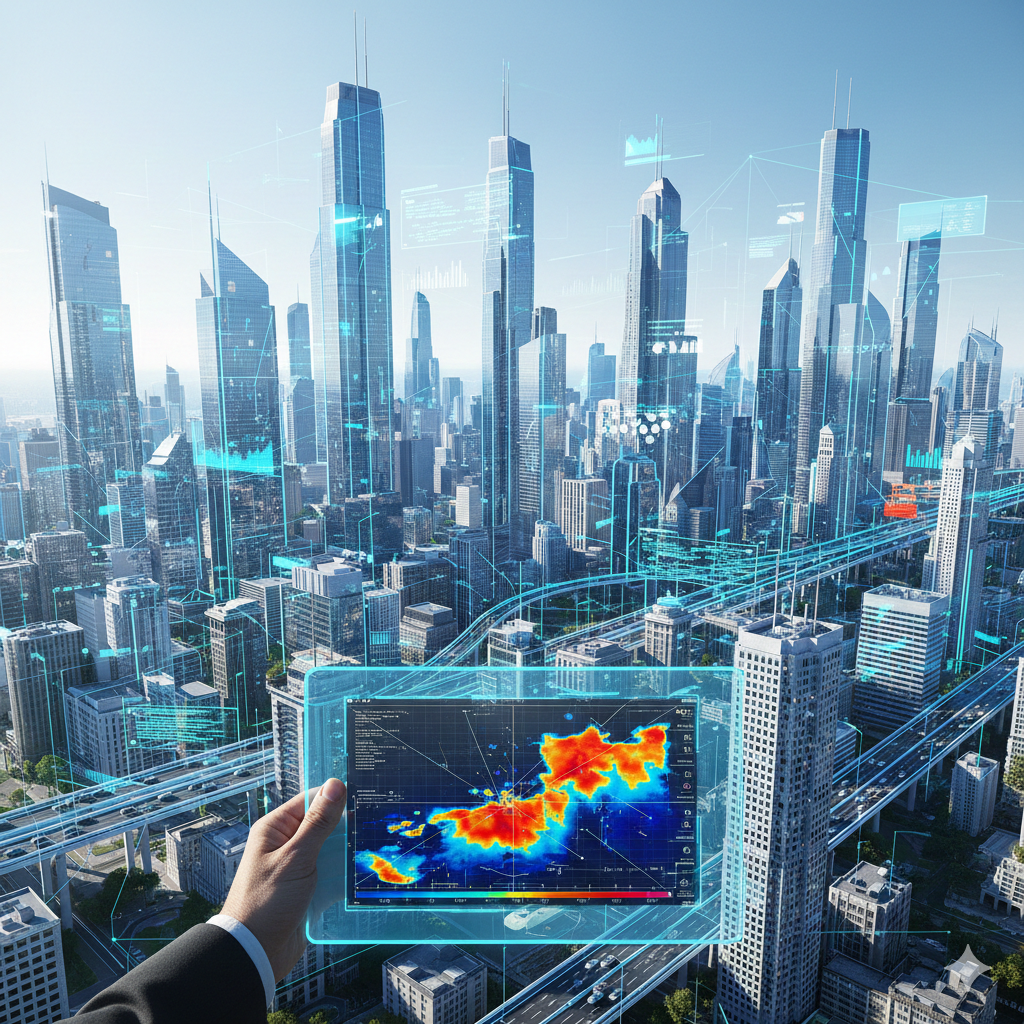
    ¿Alguna vez has deseado tener un botón de «deshacer» antes de que el ayuntamiento decida levantar toda tu calle por una obra que parece no tener fin? Pues bien, para los urbanistas de 2026, ese botón no solo existe, sino que es una representación virtual en 3D de alta fidelidad: el Gemelo Digital Urbano.

    Imagina una ciudad que respira, pero en formato binario. No estamos hablando de un mapa estático de Google Maps con cuatro iconos de colores. Un gemelo digital es un modelo dinámico alimentado en tiempo real por miles de sensores IoT, cámaras de visión artificial y datos de consumo energético. Es, literalmente, un «clon» digital que permite a los ingenieros jugar a ser dioses para predecir qué pasará antes de que ocurra en el mundo físico.

    El problema: El caos de las «ciudades ciegas»

    Tradicionalmente, la planificación urbana ha sido un ejercicio de ensayo y error extremadamente costoso. Si construías un rascacielos en el lugar equivocado, te dabas cuenta de que habías creado un túnel de viento insoportable para los peatones cuando ya era demasiado tarde. Las ciudades crecían a ciegas, reaccionando a los problemas en lugar de anticiparlos.

    Contexto Técnico: Sensores, LiDAR y GPUs al servicio del ciudadano

    Para que un gemelo digital funcione, necesitamos tres pilares tecnológicos:

    • Captura Masiva de Datos: Escaneos LiDAR y fotogrametría para mallas 3D precisas.
    • Ingesta en Tiempo Real: Telemetría constante desde sensores IoT en toda la infraestructura.
    • Inferencia Paralela: El uso de clusters de GPUs para procesar modelos de dinámica de fluidos y simulaciones de tráfico.
    «Entrenar un gemelo digital es como crear un RPG de mundo abierto, pero donde cada PNJ es un ciudadano real y las físicas afectan directamente a la calidad de vida de millones de personas.»

    La Solución: IA Generativa y Predicción

    La gran novedad en 2026 es la integración de la IA Generativa. Ya no solo observamos; ahora podemos preguntar al modelo: «Simula el impacto térmico de este nuevo parque en el microclima del barrio». Esto permite optimizar desde la recogida de residuos hasta el consumo energético del alumbrado público.

    Impacto: Un futuro más eficiente

    El impacto para el ciudadano es directo: menos atascos, mejor respuesta ante emergencias y ciudades más sostenibles. Estamos pasando de la «Smart City» conceptual a la «Responsive City» basada en ingeniería de datos pura.

    ¿Qué opinas? ¿Crees que tu ciudad está lista para tener su propio clon digital o prefieres que los urbanistas sigan improvisando? Te leo en los comentarios.
  • La paradoja de la confianza: El sutil veneno del código generado por IA que nadie está revisando

    La paradoja de la confianza: El sutil veneno del código generado por IA que nadie está revisando

    Confesemos: todos hemos sentido ese subidón de dopamina cuando pulsas Tab y tu asistente de IA completa una función de 20 líneas que parece perfecta. Es como tener un becario superdotado que escribe a la velocidad de la luz. Pero, como bien sabemos los que hemos pasado noches en vela depurando un memory leak, la velocidad no siempre es sinónimo de calidad. En 2026, nos enfrentamos a una realidad incómoda: estamos inundando nuestros repositorios con código que nadie entiende realmente.

    (más…)
  • PostgreSQL 18 y el fin de las bases de datos vectoriales dedicadas: ¿Realmente necesitamos más piezas en nuestro stack?

    PostgreSQL 18 y el fin de las bases de datos vectoriales dedicadas: ¿Realmente necesitamos más piezas en nuestro stack?

    ¿Alguna vez has sentido que tu stack tecnológico se parece peligrosamente a una partida de Jenga a punto de colapsar? Si estás construyendo aplicaciones basadas en Inteligencia Artificial, sabes de lo que hablo. Hasta ayer, si querías que tu modelo de lenguaje (LLM) tuviera «memoria» o contexto, la receta era estándar: una base de datos relacional para los datos de toda la vida y una base de datos vectorial dedicada (como Pinecone o Milvus) para guardar los embeddings. Un nuevo componente, una nueva API que aprender, otra factura que pagar y, por supuesto, otra cosa más que puede romperse a las tres de la mañana.

    El contexto técnico es claro: los modelos de IA no entienden de filas y columnas, entienden de vectores (largas listas de números que representan conceptos). Para buscar información relevante, realizamos una «búsqueda de similitud de coseno». Hasta ahora, PostgreSQL se defendía dignamente con la extensión pgvector. Sin embargo, a medida que los datasets de entrenamiento crecen y la latencia se vuelve crítica, las extensiones empezaban a mostrar costuras.

    La Solución: El elefante se vuelve nativo digital

    La respuesta llega con PostgreSQL 18. La comunidad ha decidido que los vectores ya no son ciudadanos de segunda clase. En esta nueva versión, el soporte para tipos de datos vectoriales y, lo más importante, los índices de búsqueda aproximada de vecinos más cercanos (HNSW y IVFFlat) se están integrando directamente en el núcleo del motor.

    Estamos hablando de una optimización a bajo nivel que permite realizar búsquedas semánticas casi a la misma velocidad que una consulta por clave primaria. Se acabó lo de «exportar, vectorizar y sincronizar». Ahora, tu SQL de siempre puede hacer un SELECT comparando la distancia semántica entre un comentario de un cliente y un catálogo de productos de un millón de filas en milisegundos.

    ¿Por qué esto cambia las reglas del juego?

    • Consistencia ACID total: Tus vectores heredan todas las garantías de seguridad de Postgres.
    • Menos latencia: Sin saltos de red entre la DB relacional y la vectorial.
    • Curva de aprendizaje cero: Si sabes SQL, ya sabes hacer búsquedas para tu IA.
    • Ahorro de costes: Un clúster menos que mantener en la nube.
    «No siempre lo nuevo es mejor si implica complicar la arquitectura. Postgres 18 es el triunfo del pragmatismo.»

    Desde nuestra perspectiva, vemos esto como el fin del impuesto invisible de la fragmentación de datos. PostgreSQL 18 nos demuestra que una base sólida puede absorber las innovaciones más punteras sin perder su esencia. Es la navaja suiza que ahora también incluye un acelerador de partículas.

    ¿Estamos ante el principio del fin para las bases de datos vectoriales de nicho? Para el 95% de los proyectos, la respuesta es un rotundo sí. Es hora de limpiar nuestro stack y devolverle al elefante el trono que nunca abandonó del todo.

    ¿Ya has probado el rendimiento de los nuevos índices nativos? ¿O eres de los que prefiere mantener sus vectores en un sistema separado? Te leo en los comentarios.

  • El «Unboxing» de la Navidad 2026: ¿En qué nos hemos gastado los bits?

    El «Unboxing» de la Navidad 2026: ¿En qué nos hemos gastado los bits?

    Aceptémoslo: todos tenemos ese amigo o familiar que, nada más abrir el papel de regalo, ya está buscando dónde se inserta la tarjeta microSD o si el dispositivo tiene compatibilidad con Matter. Estas Navidades de 2025-2026 no han sido una excepción, y aunque el carbón sigue siendo una amenaza real para algunos, el resto del mundo se ha volcado en una tendencia clara: el hardware con propósito y la IA «de bolsillo». No es solo que hayamos comprado más gadgets; es que hemos buscado aquellos que resuelven fricciones diarias con una elegancia técnica envidiable.

    (más…)
  • El matrimonio de conveniencia del siglo: Apple, Google y el futuro de tu iPhone

    El matrimonio de conveniencia del siglo: Apple, Google y el futuro de tu iPhone

    El matrimonio de conveniencia del siglo: Apple, Google y el futuro de tu iPhone

    Admitámoslo: todos hemos tenido ese momento incómodo con Siri. Le pides que te busque una receta de lasaña y acaba llamando a tu tía de Cuenca o, peor aún, te responde con ese temido «He encontrado esto en internet…» obligándote a sacar el móvil del bolsillo. Durante años, Apple ha reinado en el hardware, pero su asistente virtual se había quedado, siendo generosos, un poco estancado en la década pasada.

    (más…)
  • De «Hola Mundo» a Aplicación Completa: Cuando la IA se pone el mono de trabajo Full-Stack

    De «Hola Mundo» a Aplicación Completa: Cuando la IA se pone el mono de trabajo Full-Stack

    De «Hola Mundo» a Aplicación Completa: Cuando la IA se pone el mono de trabajo Full-Stack

    El fin de la tiranía de la «misa inicial»

    Si te dedicas a esto, conoces la rutina: empiezas un proyecto nuevo y, antes de escribir una sola línea de código que haga algo interesante, tienes que pasar horas montando el andamio. Toca configurar la estructura base, elegir las herramientas del frontend (la parte que ve el usuario), las del backend (la lógica del servidor), la conexión a la base de datos… Es la parte necesaria, sí, pero también es la más aburrida. Es como pasar la mañana preparando los ingredientes en lugar de cocinar.

    (más…)
  • Stack Overflow y la IA: ¿Adiós al Copiar-Pegar o un Superpoder para el Dev?

    Stack Overflow y la IA: ¿Adiós al Copiar-Pegar o un Superpoder para el Dev?

    Stack Overflow y la IA: ¿Adiós al Copiar-Pegar o un Superpoder para el Dev?

    El Desafío del Conocimiento Distribuido

    Todos lo hemos vivido. Estás inmerso en un bucle infinito de callbacks asíncronos o luchando contra una excepción de puntero nulo, y la solución parece tan lejana como el día que dejaste de usar tabulaciones en favor de los espacios. ¿A dónde acudimos? Correcto: a Stack Overflow (SO).

    (más…)
  • ‘Absolute Zero’: ¿El fin de la dependencia de los datos etiquetados para la IA?

    ‘Absolute Zero’: ¿El fin de la dependencia de los datos etiquetados para la IA?

    El reto de la etiqueta: Un cuello de botella en la era de la IA

    ¿Alguna vez te has preguntado por qué entrenar un modelo de Inteligencia Artificial de vanguardia consume tanto tiempo, dinero y recursos humanos? El problema, amigos informáticos, se resume en una sola palabra: etiquetado.

    (más…)
  • Software a prueba de balas: Programación “Self-Healing” o cómo el código se arregla solo

    Software a prueba de balas: Programación “Self-Healing” o cómo el código se arregla solo

    💥 ¡Adiós, el temido error 500! ¿Puede nuestro código aprender a curarse?

    Nos hemos acostumbrado a la frustración. El programador que llevamos dentro sabe que, por mucho testing que hagamos, el bug inesperado en producción siempre es una posibilidad. Un error que se cuela, una dependencia que falla, un pico de tráfico que satura… ¡Y boom! El temido downtime, la interrupción del servicio y, por supuesto, esa llamada a las 3 de la mañana.

    (más…)
  • El Desafío de Programar sin Escribir: ¿Estamos Asistiendo al Nacimiento del Código Invisible?

    El Desafío de Programar sin Escribir: ¿Estamos Asistiendo al Nacimiento del Código Invisible?

    ¡Atención, devs del mundo! Si creías que los Modelos de Lenguaje (LLMs) como GitHub Copilot o Code Llama eran lo máximo en asistencia a la programación, agárrate fuerte, porque estamos cruzando un nuevo umbral. Hemos pasado de la auto-completación de código a la auto-generación completa del software. Sí, has leído bien. Un equipo de investigadores en EE. UU. ha presentado un concepto que podría hacer que el código fuente, tal como lo conocemos, se vuelva casi «invisible» para el desarrollador. El código sigue ahí, claro, pero lo genera una capa de IA a partir de solo unos pocos requisitos de alto nivel. ¿Estamos ante el fin del boilerplate y el inicio de una era de arquitectura pura?

    (más…)