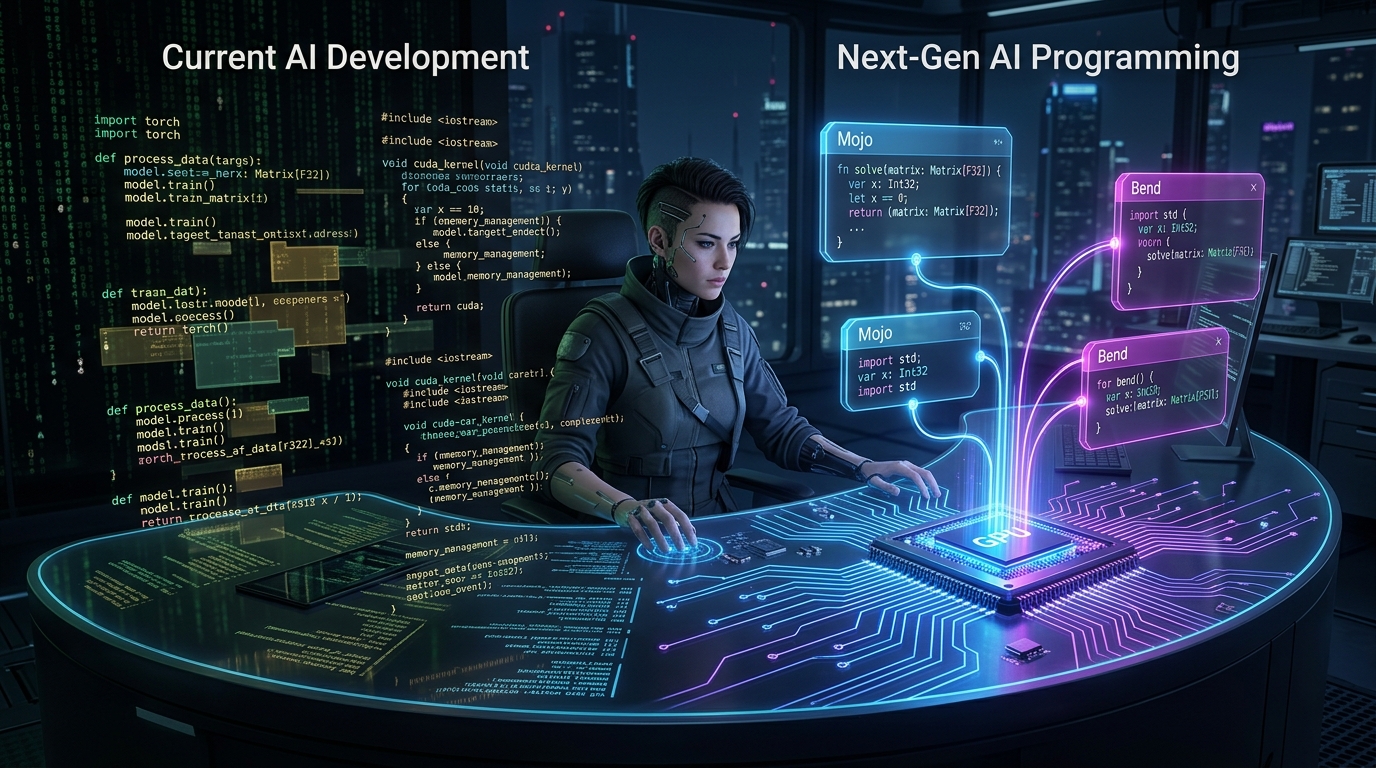
El desarrollo moderno de inteligencia artificial tiene un problema no tan secreto que casi todos prefieren ignorar: la barrera invisible entre experimentar y poner en producción. Diseñas un modelo en Python con PyTorch o TensorFlow en cuestión de tardes, todo limpio y legible. Pero cuando necesitas escalar la inferencia a miles de peticiones por segundo en un cluster de GPUs, la realidad te golpea en la cara: tienes que reescribir partes críticas del código en C++, lidiar con llamadas a CUDA, gestionar la memoria a bajo nivel y rezar para que no aparezca una condición de carrera incomprensible.
Es el clásico problema de los dos lenguajes. La productividad de la sintaxis expresiva frente a la velocidad pura de ejecución del hardware. ¿Por qué tenemos que elegir entre programar como humanos o exprimir las tarjetas gráficas como ingenieros de sistemas?
(más…)