Etiqueta: Arquitectura de Software

  • La paradoja del programador Junior: ¿cómo aprender a picar código cuando la IA ya lo hace por ti?

    La paradoja del programador Junior: ¿cómo aprender a picar código cuando la IA ya lo hace por ti?

    El mundo del desarrollo de software está viviendo una metamorfosis de las gordas. Si estás empezando en esto de las líneas de código o tienes un ojo puesto en el sector, seguro que has notado que el panorama ya no es el de hace cinco años. Tradicionalmente, el camino para convertirse en un desarrollador respetable pasaba por una fase ineludible: picar toneladas de código rutinario, escribir boilerplate, pelearse con la sintaxis de un bucle for y configurar a mano archivos de desvelos interminables. Era el rito de iniciación. La mili del programador.

    Sin embargo, hoy en día abres cualquier IDE moderno y, gracias a los modelos de lenguaje orientados a código, esa capa de trabajo rutinario se desvanece con un simple tabulador. La Inteligencia Artificial genera funciones enteras en milisegundos, dejándonos una pregunta incómoda flotando en el aire del sector: si las máquinas absorben el 80% del trabajo mecánico de un perfil júnior, ¿cómo demonios van a aprender las nuevas generaciones a desarrollar ese «olfato» técnico que solo te da la experiencia?

    (más…)
  • El despertar de la AGI: la Inteligencia Artificial empieza a programarse a sí misma

    El despertar de la AGI: la Inteligencia Artificial empieza a programarse a sí misma

    El software lleva décadas ayudándonos a resolver tareas bajo una premisa inmutable: tú le das las reglas y el sistema procesa los datos. Si programas un validador de formularios en TypeScript, el código no va a aprender de repente a jugar al ajedrez ni a optimizar la infraestructura de un clúster de Kubernetes por puro aburrimiento. La Inteligencia Artificial actual, por muy sorprendente que nos parezca con sus respuestas fluidas y su generación de código en entornos como Cursor, sigue siendo una IA «estrecha» (Narrow AI). Es un motor estadístico brutalmente optimizado para predecir el siguiente token basándose en terabytes de datos de entrenamiento previos. Pero algo está cambiando en los laboratorios de computación más avanzados del planeta. Se están empezando a observar los primeros destellos de lo que la industria define como Inteligencia General Artificial (AGI) dentro de entornos de simulación hipercontrolados y completamente aislados de la red. No estamos hablando de un modelo de lenguaje que repite como un loro fragmentos de StackOverflow; estamos ante sistemas capaces de manifestar un razonamiento deductivo puro, lógica abstracta y la habilidad inédita de inventar sus propias herramientas de software para resolver problemas científicos complejos de física y matemáticas sin que ningún humano les haya picado una sola línea de código para guiar esa solución.

    (más…)
  • La venganza del Monolito Elegante: ¿Por qué estamos volviendo al código unificado?

    La venganza del Monolito Elegante: ¿Por qué estamos volviendo al código unificado?

    Admitámoslo: durante la última década, la comunidad de desarrollo de software ha vivido sumida en una especie de fiebre colectiva. Si no estabas fragmentando tu aplicación en cincuenta microservicios, desplegando clústeres ingobernables de Kubernetes y gestionando una red de comunicación interna digna de la NASA, parecía que estabas programando en el siglo pasado. Nos vendieron que el monolito estaba muerto, que era un dinosaurio lento y monolítico —valga la redundancia—. Sin embargo, muchos desarrolladores se han topado de bruces con una cruda realidad: cambiar un monolito simple por una arquitectura distribuida mal planificada a menudo solo sirve para transformar un código desordenado en un auténtico caos distribuido, multiplicando los costes de infraestructura y la latencia en la red.

    (más…)
  • El fin del botón de «Guardar»: Por qué el software está dejando de ser una herramienta para ser tu nuevo empleado

    El fin del botón de «Guardar»: Por qué el software está dejando de ser una herramienta para ser tu nuevo empleado

    ¿Te acuerdas de cuando el mayor avance del software era una interfaz bonita con cien botones de colores? Comrabas una licencia, pasabas tres meses configurando el dashboard y luego tenías que contratar a tres personas solo para rellenar los formularios y darle al botón de procesar. Pagabas por la herramienta para hacer el trabajo tú. Pues bien, saca el pañuelo y despídete, porque esa era informática está firmemente plantada en el cementerio de la tecnología.

    (más…)
  • ¿El fin de picar código? Por qué el «Vibe Coding» está cambiando las reglas del juego en el desarrollo de software

    ¿El fin de picar código? Por qué el «Vibe Coding» está cambiando las reglas del juego en el desarrollo de software

    Quienes nos dedicamos a esto sabemos que la programación siempre ha tenido un componente casi místico. Esa sensación de teclear a oscuras, con café en vena, peleando contra un punto y coma ausente o un puntero rebelde que se niega a cooperar. Es un arte de trinchera sintáctica. Sin embargo, si has estado atento a los repositorios de GitHub o a las discusiones en redes estas últimas semanas, habrás notado que un término extrañamente relajado está inundando los foros técnicos: el Vibe Coding. Al principio suena a broma de diseñador de interfaces o a palabreja inventada por algún gurú de LinkedIn tras su tercer selfi motivacional, pero la realidad es mucho más profunda. Estamos presenciando el cambio de paradigma más radical en la ingeniería de software desde la invención de los lenguajes de alto nivel. La forma en la que construimos aplicaciones informáticas está mutando, y el programador tradicional está dejando paso a una figura mucho más cercana a la de un director de orquesta digital.

    (más…)
  • PHP 8.4 y los Property Hooks: El fin de la era de los Getters y Setters infinitos

    PHP 8.4 y los Property Hooks: El fin de la era de los Getters y Setters infinitos

    Si llevas unos cuantos años picando código en el ecosistema web, seguro que tu editor de texto ha echado humo más de una vez generando métodos estructurales. Hablamos de esa vieja y monótona coreografía de la programación orientada a objetos: declarar una propiedad privada, crear un método para devolver su valor y diseñar otro para modificarlo. Sí, los famosos getters y setters. Esta práctica, aunque necesaria para mantener el encapsulamiento y validar los datos, a menudo transforma nuestras elegantes clases en archivos kilométricos llenos de código repetitivo (el temido boilerplate). El verdadero problema no es solo escribirlos, sino mantenerlos legibles cuando las reglas de negocio cambian.

    (más…)
  • CSS se hace mayor: Funciones y Mixins nativos para jubilar (por fin) a los preprocesadores

    CSS se hace mayor: Funciones y Mixins nativos para jubilar (por fin) a los preprocesadores

    Hace años, si le decías a un programador de C++ o Java que trabajabas con CSS, probablemente te lanzaba una mirada de condescendencia mientras murmuraba: «Eso no es programar, es pintar cuadraditos». Y aunque nos doliera en el orgullo, parte de la razón no les faltaba. Durante décadas, CSS ha sido un lenguaje puramente declarativo, una lista de deseos visuales que el navegador interpretaba como buenamente podía. Si querías lógica, reutilización o variables reales, tenías que huir hacia SASS, LESS o Stylus. Teníamos que instalar Node.js, configurar Webpack o Vite, y esperar a que un transpilador escupiera el código que el navegador realmente entendía. Era como tener que montar una fábrica de pinceles cada vez que querías pintar un cuadro.

    (más…)
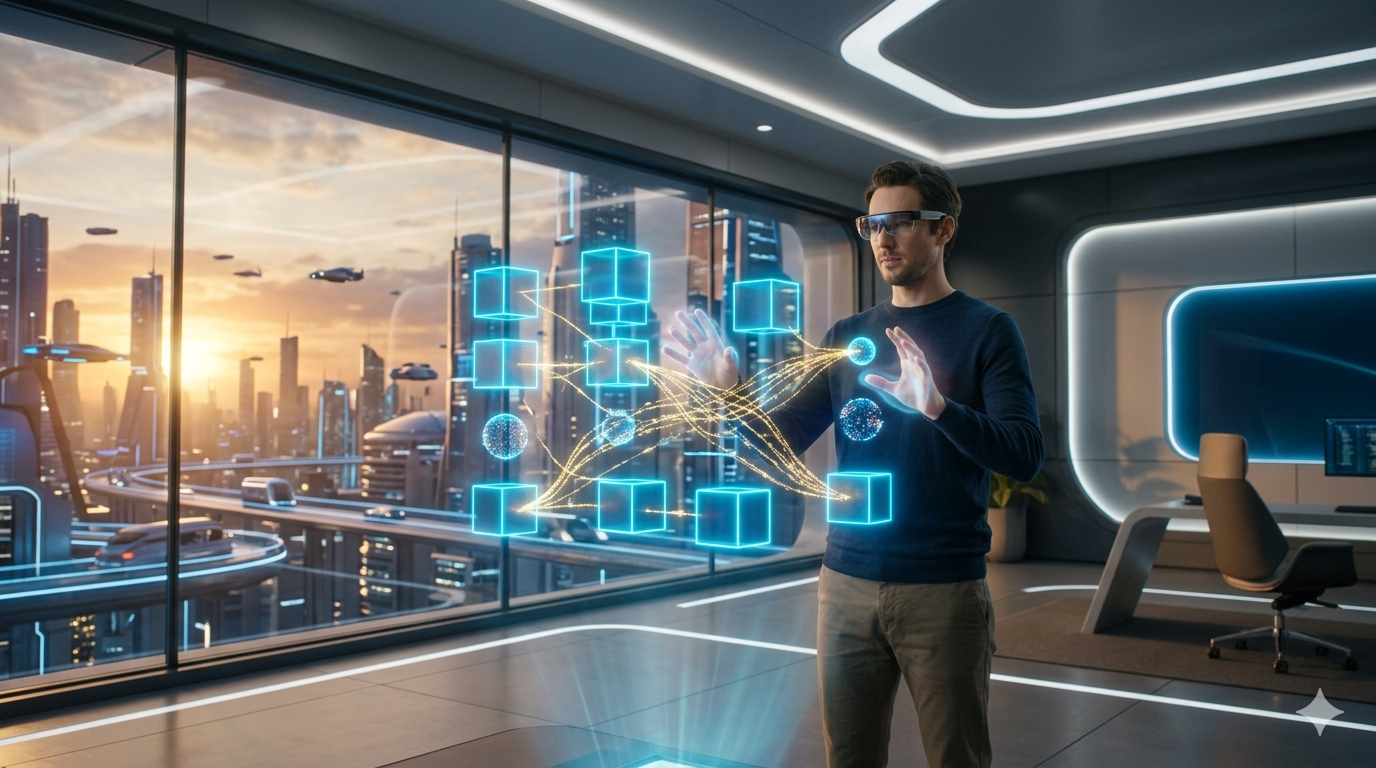
  • Programar sin teclear: ¿Es el «Pensamiento Espacial» el fin de la sintaxis tradicional?

    Programar sin teclear: ¿Es el «Pensamiento Espacial» el fin de la sintaxis tradicional?

    Imagínate que estás frente a un lienzo infinito en tres dimensiones. No hay un monitor de 27 pulgadas limitando tu visión, ni un cursor parpadeante en una terminal negra que parece juzgar cada uno de tus errores de sintaxis. En su lugar, coges con tus manos un cubo que representa una base de datos PostgreSQL y tiras un cable de luz hacia una esfera que simboliza un microservicio. No estás jugando; estás desplegando una arquitectura en Kubernetes.

    (más…)
  • Del Excel que «avisa» al ERP que «actúa»: Bienvenidos a la era del ERP Activo

    Del Excel que «avisa» al ERP que «actúa»: Bienvenidos a la era del ERP Activo

    ¿Alguna vez has sentido que tu software de gestión empresarial (ERP) es básicamente una hoja de Excel glorificada con una interfaz más bonita? Durante décadas, la relación entre el profesional y su software ha sido reactiva: algo fallaba, el sistema lanzaba una alerta roja (si tenías suerte) y tú tenías que correr a solucionar el incendio. Pues bien, prepárate para colgar el extintor, porque en este 2026 estamos asistiendo al nacimiento del ERP Activo, una evolución que deja atrás la simple visualización de datos para entrar de lleno en la ejecución autónoma.

    Históricamente, los sistemas de planificación de recursos empresariales han sido repositorios pasivos. Se limitaban a registrar qué entraba y qué salía, dejando el razonamiento lógico y la toma de decisiones al humano de turno. El problema es que, en un mundo de sistemas distribuidos y cadenas de suministro globales, la velocidad del dato supera nuestra capacidad de reacción. Si un proveedor en el sudeste asiático tiene un retraso, tu ERP tradicional te avisará cuando el stock llegue a cero. Un ERP Activo, sin embargo, detecta la anomalía en el manifiesto de carga digital, analiza el impacto en tu producción y, antes de que llegues a la oficina con tu café, ya ha contactado con tres proveedores alternativos y te presenta las facturas proforma listas para un clic de validación.

    El motor bajo el capó: Agentes y Orquestación

    Lo que diferencia a estos nuevos sistemas no es solo una «capa de IA» por encima de la base de datos SQL de toda la vida. Estamos hablando de una arquitectura basada en agentes de IA autónomos que operan sobre un bus de eventos en tiempo real.

    Para que nos entendamos: es como si cada módulo de tu software (Contabilidad, Logística, RRHH) tuviera su propio «mini-cerebro» con capacidad de ejecución. Estos sistemas utilizan modelos de lenguaje de gran tamaño (LLMs) especializados en tareas de razonamiento lógico y llamadas a APIs.

    • Inferencia en tiempo real: El sistema no espera a un proceso nocturno de «batch». Analiza cada transacción al vuelo.
    • Detección de anomalías mediante aprendizaje profundo: No se basa en reglas rígidas, sino en patrones de comportamiento complejos que previenen fraudes antes de que ocurran.
    • Interoperabilidad total: Capacidad para interactuar con APIs externas, desde logística global hasta fluctuaciones de mercado en tiempo real.

    ¿El fin de la gestión humana o el inicio de la supervisión experta?

    El impacto de esta tecnología es masivo. Pasamos de navegar por decenas de pestañas a recibir informes ejecutivos con soluciones ya propuestas. El ERP Activo resuelve la fatiga de datos, permitiendo que el profesional se centre en la estrategia mientras la IA gestiona la operativa técnica.

    «La agilidad empresarial ya no depende de qué tan rápido leas los datos, sino de qué tan rápido tu sistema pueda actuar sobre ellos.»

    Estamos ante un cambio de paradigma. ¿Confiarías la gestión de tu stock a un agente autónomo o prefieres seguir revisando el inventario a mano cada viernes? Te leo en los comentarios si ya estás integrando agentes de IA en tus flujos de trabajo locales.

  • PostgreSQL 18 y el fin de las bases de datos vectoriales dedicadas: ¿Realmente necesitamos más piezas en nuestro stack?

    PostgreSQL 18 y el fin de las bases de datos vectoriales dedicadas: ¿Realmente necesitamos más piezas en nuestro stack?

    ¿Alguna vez has sentido que tu stack tecnológico se parece peligrosamente a una partida de Jenga a punto de colapsar? Si estás construyendo aplicaciones basadas en Inteligencia Artificial, sabes de lo que hablo. Hasta ayer, si querías que tu modelo de lenguaje (LLM) tuviera «memoria» o contexto, la receta era estándar: una base de datos relacional para los datos de toda la vida y una base de datos vectorial dedicada (como Pinecone o Milvus) para guardar los embeddings. Un nuevo componente, una nueva API que aprender, otra factura que pagar y, por supuesto, otra cosa más que puede romperse a las tres de la mañana.

    El contexto técnico es claro: los modelos de IA no entienden de filas y columnas, entienden de vectores (largas listas de números que representan conceptos). Para buscar información relevante, realizamos una «búsqueda de similitud de coseno». Hasta ahora, PostgreSQL se defendía dignamente con la extensión pgvector. Sin embargo, a medida que los datasets de entrenamiento crecen y la latencia se vuelve crítica, las extensiones empezaban a mostrar costuras.

    La Solución: El elefante se vuelve nativo digital

    La respuesta llega con PostgreSQL 18. La comunidad ha decidido que los vectores ya no son ciudadanos de segunda clase. En esta nueva versión, el soporte para tipos de datos vectoriales y, lo más importante, los índices de búsqueda aproximada de vecinos más cercanos (HNSW y IVFFlat) se están integrando directamente en el núcleo del motor.

    Estamos hablando de una optimización a bajo nivel que permite realizar búsquedas semánticas casi a la misma velocidad que una consulta por clave primaria. Se acabó lo de «exportar, vectorizar y sincronizar». Ahora, tu SQL de siempre puede hacer un SELECT comparando la distancia semántica entre un comentario de un cliente y un catálogo de productos de un millón de filas en milisegundos.

    ¿Por qué esto cambia las reglas del juego?

    • Consistencia ACID total: Tus vectores heredan todas las garantías de seguridad de Postgres.
    • Menos latencia: Sin saltos de red entre la DB relacional y la vectorial.
    • Curva de aprendizaje cero: Si sabes SQL, ya sabes hacer búsquedas para tu IA.
    • Ahorro de costes: Un clúster menos que mantener en la nube.
    «No siempre lo nuevo es mejor si implica complicar la arquitectura. Postgres 18 es el triunfo del pragmatismo.»

    Desde nuestra perspectiva, vemos esto como el fin del impuesto invisible de la fragmentación de datos. PostgreSQL 18 nos demuestra que una base sólida puede absorber las innovaciones más punteras sin perder su esencia. Es la navaja suiza que ahora también incluye un acelerador de partículas.

    ¿Estamos ante el principio del fin para las bases de datos vectoriales de nicho? Para el 95% de los proyectos, la respuesta es un rotundo sí. Es hora de limpiar nuestro stack y devolverle al elefante el trono que nunca abandonó del todo.

    ¿Ya has probado el rendimiento de los nuevos índices nativos? ¿O eres de los que prefiere mantener sus vectores en un sistema separado? Te leo en los comentarios.