Categoría: Noticias

Notícias principal

  • El fin de las noches de guardia: Cómo el DevOps predictivo va a salvar tu fin de semana

    El fin de las noches de guardia: Cómo el DevOps predictivo va a salvar tu fin de semana

    Son las siete de la tarde de un viernes. Tienes el código listo, los tests unitarios están en verde y la tentación de pulsar el botón de deploy es casi irresistible. Pero una voz interior, esa que ha nacido de años de café frío y servidores caídos a medianoche, te susurra al oído: «No lo hagas, la producción huele el miedo». Todos hemos estado ahí. La gestión de despliegues ha sido, históricamente, un acto de fe envuelto en scripts de Bash y alarmas de Monitorización. Sabes cómo entra el código en el pipeline, pero nunca estás 100% seguro de cómo va a salir al mundo real. La eterna batalla entre el equipo de desarrollo que quiere innovar rápido y el equipo de operaciones que busca estabilidad sigue provocando fricciones en miles de departamento tecnológicos.

    Afortunadamente, el ecosistema de Integración y Despliegue Continuo (CI/CD) está viviendo su mayor revolución técnica desde la invención de Docker. Estamos pasando de sistemas puramente reactivos —aquellos que se limitan a llorar en un canal de Slack cuando un contenedor entra en bucle de reinicio— a un paradigma completamente nuevo: el DevOps Predictivo. La idea ya no es medir el impacto del desastre una vez que los usuarios empiezan a reportar errores en la pasarela de pago, sino calcular la probabilidad matemática de que tu código rompa la infraestructura antes incluso de que los servidores de integración comiencen a compilar el proyecto.

    (más…)
  • El milagro de la cuantización extrema: Cómo meter un LLM gigante en la CPU de tu patinete eléctrico (o casi)

    El milagro de la cuantización extrema: Cómo meter un LLM gigante en la CPU de tu patinete eléctrico (o casi)

    Imaginas que mañana decides montar un centro de datos en tu propia casa para correr una Inteligencia Artificial de última generación. Vas a tu tienda de hardware de confianza, miras el precio de un clúster de GPUs de nivel empresarial y, de repente, vender un riñón ya no te parece una mala idea financiera. Hasta hace dos días, si querías ejecutar un modelo de lenguaje (LLM) con cara y ojos de manera local, o tenías una tarjeta gráfica que consumías más energía que una pequeña ciudad del norte de España, o estabas condenado a ver cómo tu ordenador procesaba un token cada tres minutos. La dependencia de las API de pago y de los servidores en la nube parecía el único camino para los mortales. Sin embargo, la comunidad del open source se ha cansado de pedir permiso (y créditos bancarios) a las grandes tecnológicas.

    El cuello de botella de la IA generativa local nunca ha sido únicamente la potencia de cálculo bruta, sino algo mucho más mundano: la memoria RAM y el ancho de banda. Cuando descargamos un modelo de lenguaje convencional, nos encontramos con gigabytes y gigabytes de coeficientes numéricos llamados «parámetros». Originalmente, estos pesos se guardan en formatos de alta precisión, como FP16 (punto flotante de 16 bits). Hagan las matemáticas conmigo, queridos desarrolladores: un modelo modesto de 70.000 millones de parámetros (70B) en FP16 requiere algo más de 140 GB de VRAM solo para cargarse en memoria. Eso descarta automáticamente al 99% de los ordenadores del planeta. Durante el proceso de inferencia paralela, la CPU o la GPU tienen que mover continuamente todos esos gigabytes desde la memoria de almacenamiento hasta los registros del procesador. Es el clásico problema informático donde la autopista es demasiado estrecha para tanto tráfico.

    (más…)
  • PHP 8.4 y los Property Hooks: El fin de la era de los Getters y Setters infinitos

    PHP 8.4 y los Property Hooks: El fin de la era de los Getters y Setters infinitos

    Si llevas unos cuantos años picando código en el ecosistema web, seguro que tu editor de texto ha echado humo más de una vez generando métodos estructurales. Hablamos de esa vieja y monótona coreografía de la programación orientada a objetos: declarar una propiedad privada, crear un método para devolver su valor y diseñar otro para modificarlo. Sí, los famosos getters y setters. Esta práctica, aunque necesaria para mantener el encapsulamiento y validar los datos, a menudo transforma nuestras elegantes clases en archivos kilométricos llenos de código repetitivo (el temido boilerplate). El verdadero problema no es solo escribirlos, sino mantenerlos legibles cuando las reglas de negocio cambian.

    (más…)
  • El declive del commit tradicional: Por qué Git abraza los metadatos semánticos nativos

    El declive del commit tradicional: Por qué Git abraza los metadatos semánticos nativos

    Admitámoslo en la intimidad de nuestro entorno de desarrollo: escribir mensajes de commit es, para la mayoría de los programadores, una de las tareas más tediosas del universo. Todos hemos comenzado el día con un pulcro y académico feat(auth): implement OAuth2 token refresh architecture, para terminar a las tres de la mañana enviando un desesperado fix: por favor funciona ya o el clásico asdasdasd. Este factor humano introduce caos en los historiales de versiones, rompe las herramientas de automatización y drena energía mental.

    (más…)
  • El fin de las extensiones: Por qué los IDEs tradicionales están muriendo frente al desarrollo nativo en IA

    El fin de las extensiones: Por qué los IDEs tradicionales están muriendo frente al desarrollo nativo en IA

    Aceptémoslo: todos hemos sentido esa punzada de frustración cuando nuestro plugin de IA favorito se queda colgado, nos devuelve un trozo de código que rompe el build o, peor aún, alucina con una librería que no existe desde 2018. Llevamos un par de años intentando encajar motores de inteligencia artificial hiperpotentes dentro de editores de texto tradicionales mediante parches, extensiones y APIs de terceros. Es como intentar meter el motor de un Tesla dentro de un Ford Fiesta de 1998: funciona a ratos, pero el chasis cruje por todas partes. Los desarrolladores pasamos más tiempo copiando, pegando y corrigiendo el contexto de las sugerencias que picando código real, convirtiendo la promesa de la productividad en un dolor de cabeza de dependencias.

    El verdadero problema de fondo es arquitectónico. Los entornos de desarrollo integrados (IDEs) actuales nacieron en una era donde el teclado y el ser humano eran la única fuente de entrada de datos. Añadir una extensión que consulta un modelo de lenguaje (LLM) es un parche superficial. La IA no entiende la estructura semántica global de tu proyecto en tiempo real; solo lee pestañas abiertas o fragmentos sueltos. Esto provoca un desfase crítico: el desarrollador independiente que intenta levantar un microservicio o un simulador complejo en una tarde se encuentra con que el autocompletado rompe el tipado, pierde el hilo de las variables distribuidas o duplica funciones. Estamos usando herramientas del siglo pasado para gestionar la velocidad de computación del mañana.

    (más…)
  • Arqueología del Bit: Cómo los «Cementerios de Código» están Salvando el Pasado (y el Futuro) de la Informática

    Arqueología del Bit: Cómo los «Cementerios de Código» están Salvando el Pasado (y el Futuro) de la Informática

    ¿Alguna vez te has preguntado qué pasa con el código fuente de las plataformas que definieron nuestra vida digital hace veinte o treinta años? En el vertiginoso mundo del software, lo que hoy es revolucionario mañana es considerado un «fósil». Tendemos a pensar que internet es eterno, pero la realidad es mucho más frágil: páginas web enteras, foros míticos y plataformas pioneras de los años 90 y principios de los 2000 desaparecen cada día sin dejar rastro debido a servidores apagados, quiebras comerciales o discos duros que acaban en el contenedor.

    Este fenómeno ha dado lugar a una nueva y fascinante disciplina dentro de la informática: la arqueología digital y la gestión de los llamados «cementerios de código». No se trata de un simple ataque de nostalgia masiva o de un diógenes digital; es un movimiento global y estratégico. Universidades, bibliotecarios digitales e instituciones internacionales (como la UNESCO a través de la iniciativa Software Heritage) se están aliando para rescatar, catalogar y resucitar repositorios archivados. ¿El objetivo? Salvar la historia de la computación y, de paso, enseñarnos a programar mejor en el presente.

    (más…)
  • El laberinto de las mil dimensiones: Por qué las bases de datos vectoriales nativas son los nuevos motores de la IA

    El laberinto de las mil dimensiones: Por qué las bases de datos vectoriales nativas son los nuevos motores de la IA

    Imagina que decides organizar la biblioteca de tu casa. Tienes dos opciones. La clásica: ordenar los libros por orden alfabético del autor o por el código ISBN. Es un sistema eficiente, cuadriculado y predecible. Si buscas «Cervantes», vas a la C y ahí está. Pero ahora imagina que llega un amigo y te dice: «Oye, búscame un libro que deje una sensación de melancolía tecnológica, que hable de la soledad en ciudades futuristas y donde los coches vuelen pero de forma un poco decadente». Tu orden alfabético acaba de explotar en mil pedazos. No hay un campo «sentimiento» en el código de barras, ni un índice relacional clásico que entienda la sutil analogía entre la decadencia y un coche volador.

    (más…)
  • El fin de una era en la red: Por qué HTTP/3 está jubilando al viejo TCP (y por qué tu web volará)

    El fin de una era en la red: Por qué HTTP/3 está jubilando al viejo TCP (y por qué tu web volará)

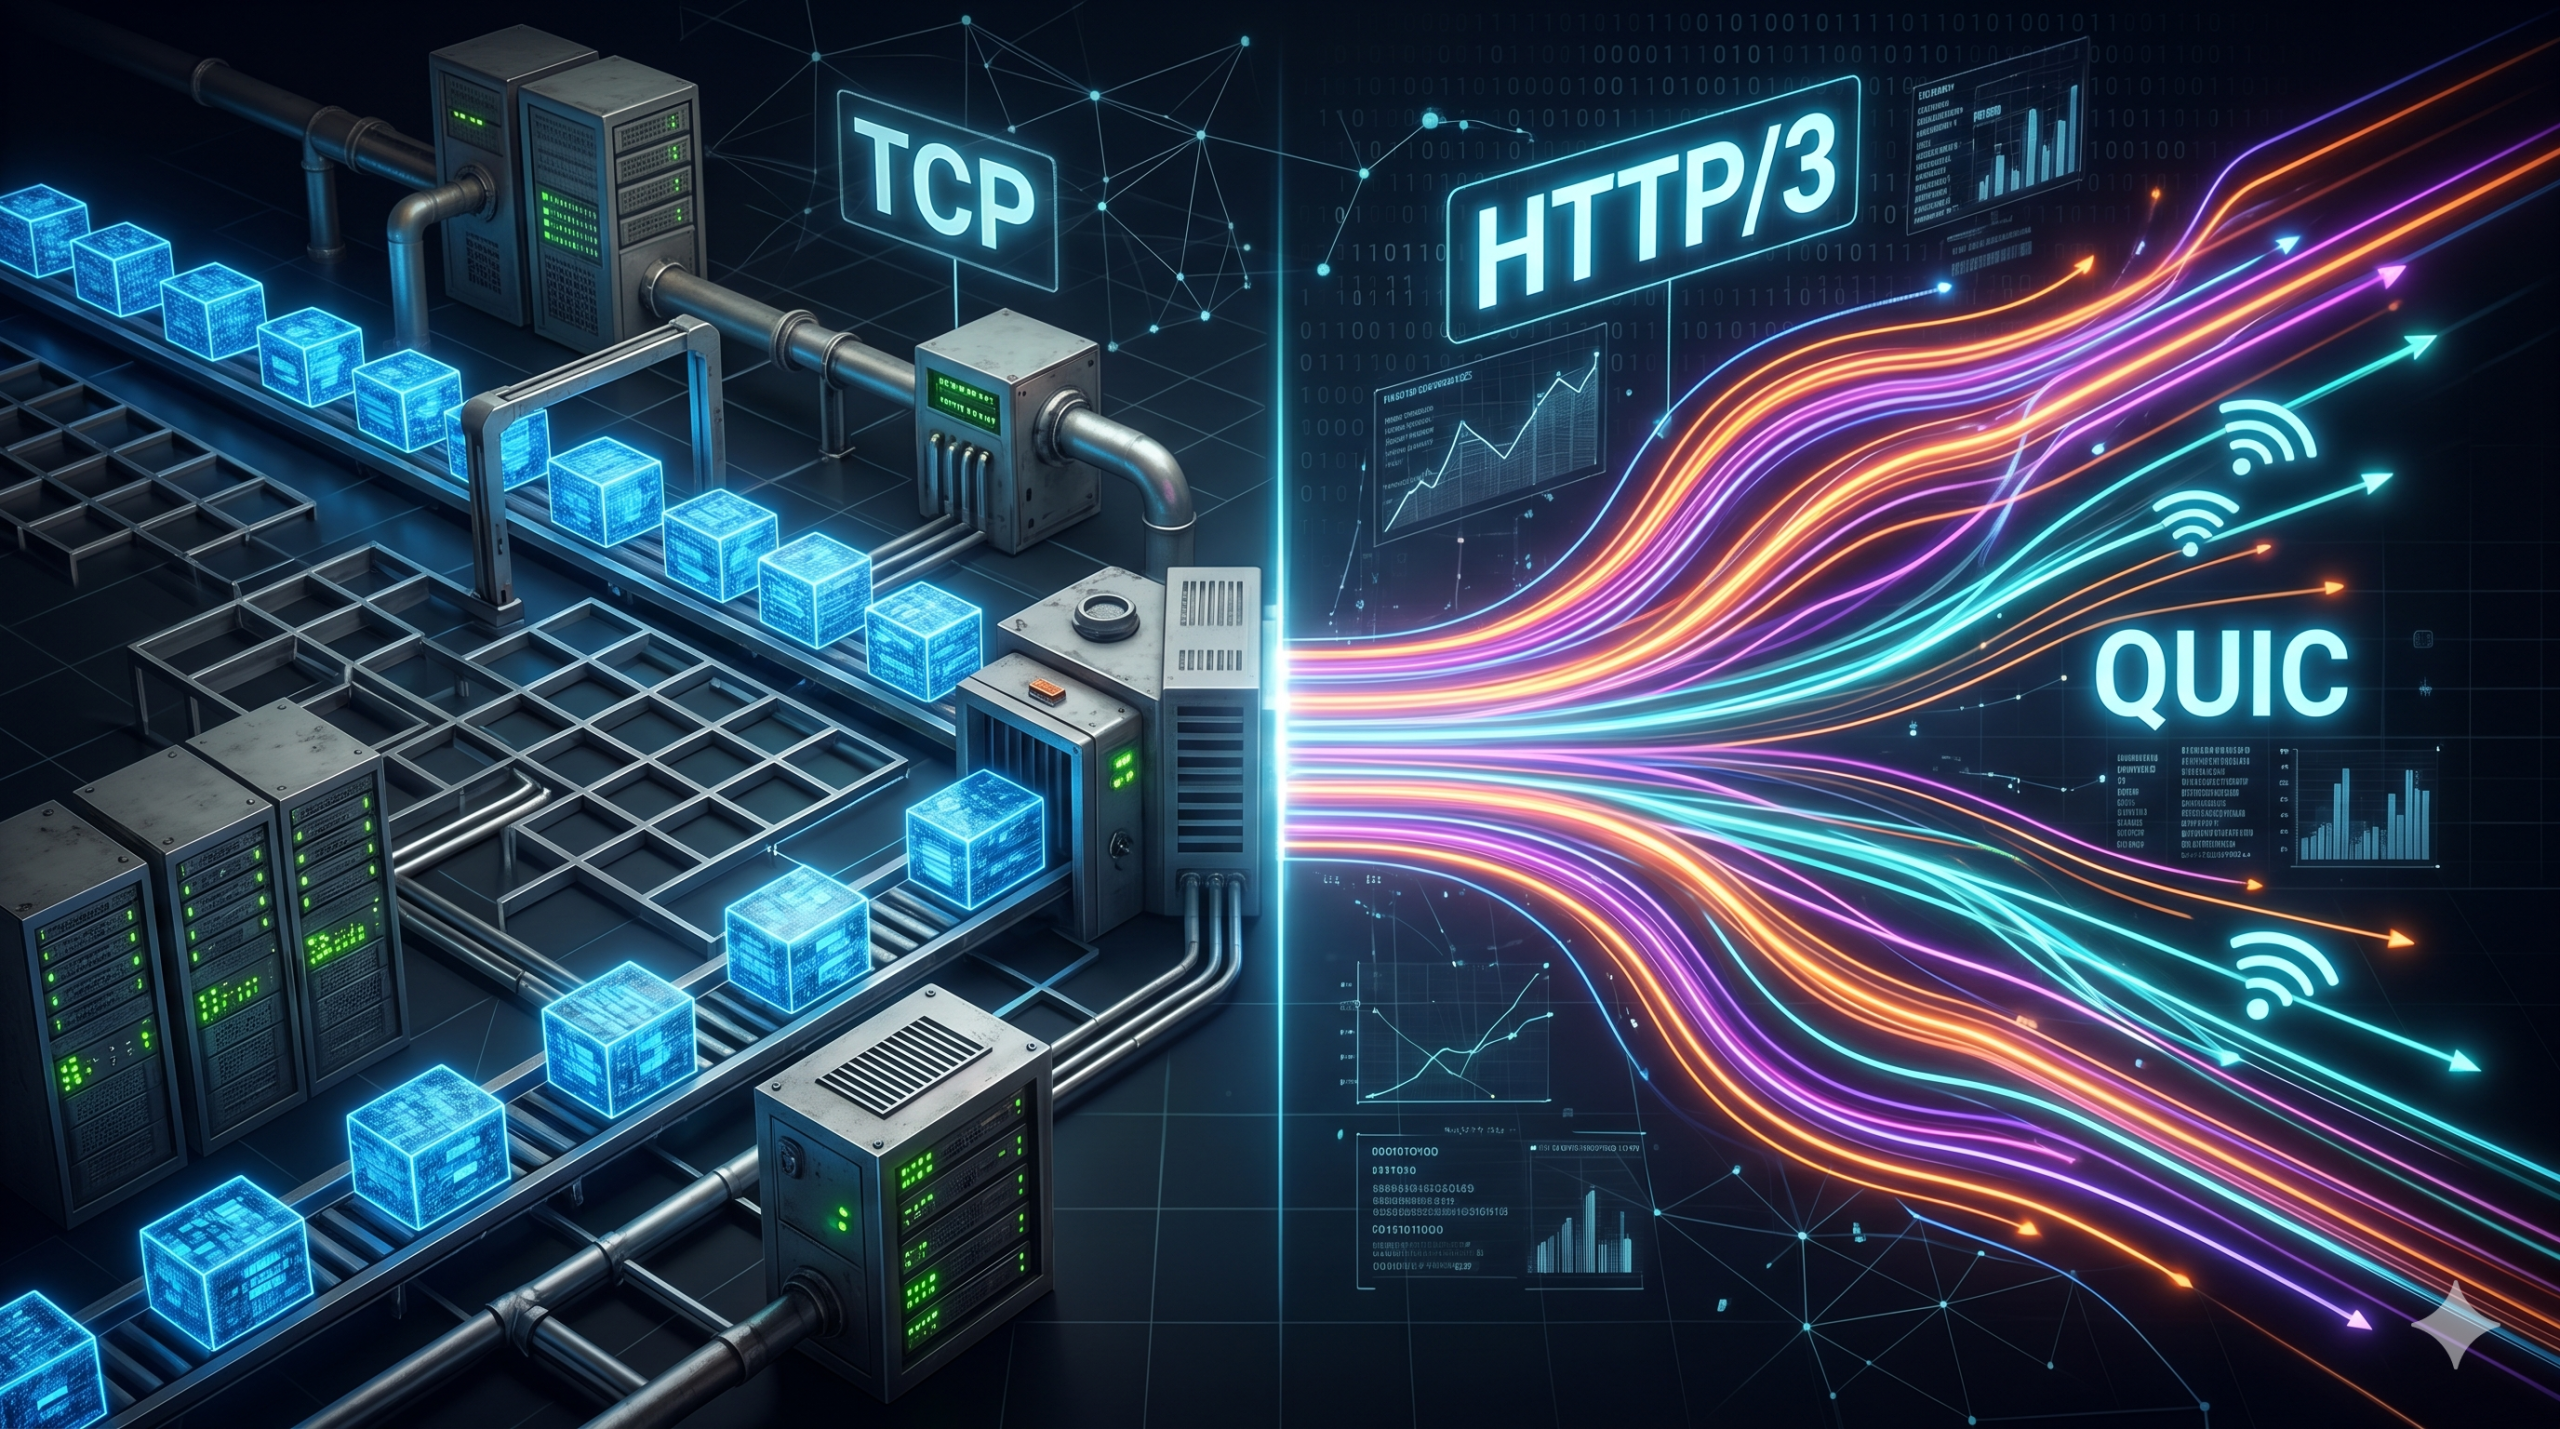
    Imaginen que están en un restaurante y piden una hamburguesa, unas patatas y un refresco. El camarero, que es un profesional extremadamente meticuloso pero un poco cuadriculado, decide traerles primero la hamburguesa. Hasta que no la deja en la mesa y ustedes confirman que todo está correcto, no vuelve a la cocina a por las patatas. Y solo cuando las patatas están servidas, regresa a por el refresco. Si por el camino la bandeja de las patatas sufre un percance, todo el servicio se detiene. Suena ridículo y desesperante, ¿verdad? Pues lamento decirles que, si están leyendo esto a través de una conexión web tradicional, sus datos han estado viajando exactamente así durante los últimos treinta años.

    Afortunadamente, el panorama de la infraestructura de internet está cambiando de forma radical. El protocolo HTTP/3 ya ha superado la barrera del 30% de adopción global en el tráfico web, consolidándose como el nuevo estándar de la industria. No se trata de una simple actualización estética ni de un parche de seguridad de esos que se instalan los martes por la tarde. Estamos ante una reingeniería total de las tuberías de internet. La gran revolución es que dejamos atrás el mítico protocolo TCP (Transmission Control Protocol), el auténtico caballo de batalla sobre el que se construyó la red de redes, para abrazar a un nuevo y velocísimo jugador: QUIC, un protocolo que corre sobre UDP (User Datagram Protocol). Pero, ¿por qué los ingenieros de medio mundo han decidido jubilar a una tecnología que llevaba funcionando perfectamente desde los tiempos en que los módems pitaban al conectarse?

    (más…)
  • El fin de las «alucinaciones» en código: ¿Por qué la inferencia paralela es el nuevo superpoder de los desarrolladores?

    El fin de las «alucinaciones» en código: ¿Por qué la inferencia paralela es el nuevo superpoder de los desarrolladores?

    Admitámoslo sin paños calientes: todos hemos sentido esa mezcla de emoción y pánico cuando le pedimos a un modelo de lenguaje que nos genere una función compleja en Python o TypeScript. Le das al intro, la Inteligencia Artificial empieza a escupir líneas de código a una velocidad endiablada y, por un segundo, te sientes en el año 2050. Pero la realidad suele ser más terca. Copias el código, lo pegas en tu entorno de desarrollo, le das a ejecutar y… ¡pum! Un precioso error de sintaxis o una variable inventada te explotan en la cara. La IA ha vuelto a alucinar.

    Este fenómeno, que convierte a los asistentes de código en compañeros brillantes pero a veces profundamente mentirosos, ha sido el gran cuello de botella para la adopción masiva de la inteligencia artificial generativa en entornos de producción críticos. Hasta ahora.

    Un consorcio internacional de investigadores y desarrolladores open source en IA acaba de presentar un enfoque revolucionario que promete erradicar estas alucinaciones sintácticas de raíz. ¿La clave? No se trata de hacer modelos más grandes, sino más inteligentes a la hora de pensar. Mediante una técnica denominada verificación sintáctica por inferencia paralela, los nuevos entornos de desarrollo integrados (IDEs) son capaces de auditar el código en un entorno aislado milisegundos antes de que aparezca impreso en tu pantalla.

    (más…)
  • Microsoft Azure Linux 4.0: Cuando el pingüino se viste de gala para dominar los clústeres de IA

    Microsoft Azure Linux 4.0: Cuando el pingüino se viste de gala para dominar los clústeres de IA

    ¿Quién te ha visto y quién te ve, Redmond? Si a cualquiera de nosotros nos dicen hace quince años que Microsoft iba a presentar a bombo y platillo la versión 4.0 de su propia distribución de Linux en la Open Source Summit, habríamos revisado si nos habían echado algo en el café. Pero el software libre no entiende de rencores, y el mercado de la Inteligencia Artificial generativa menos aún.

    (más…)