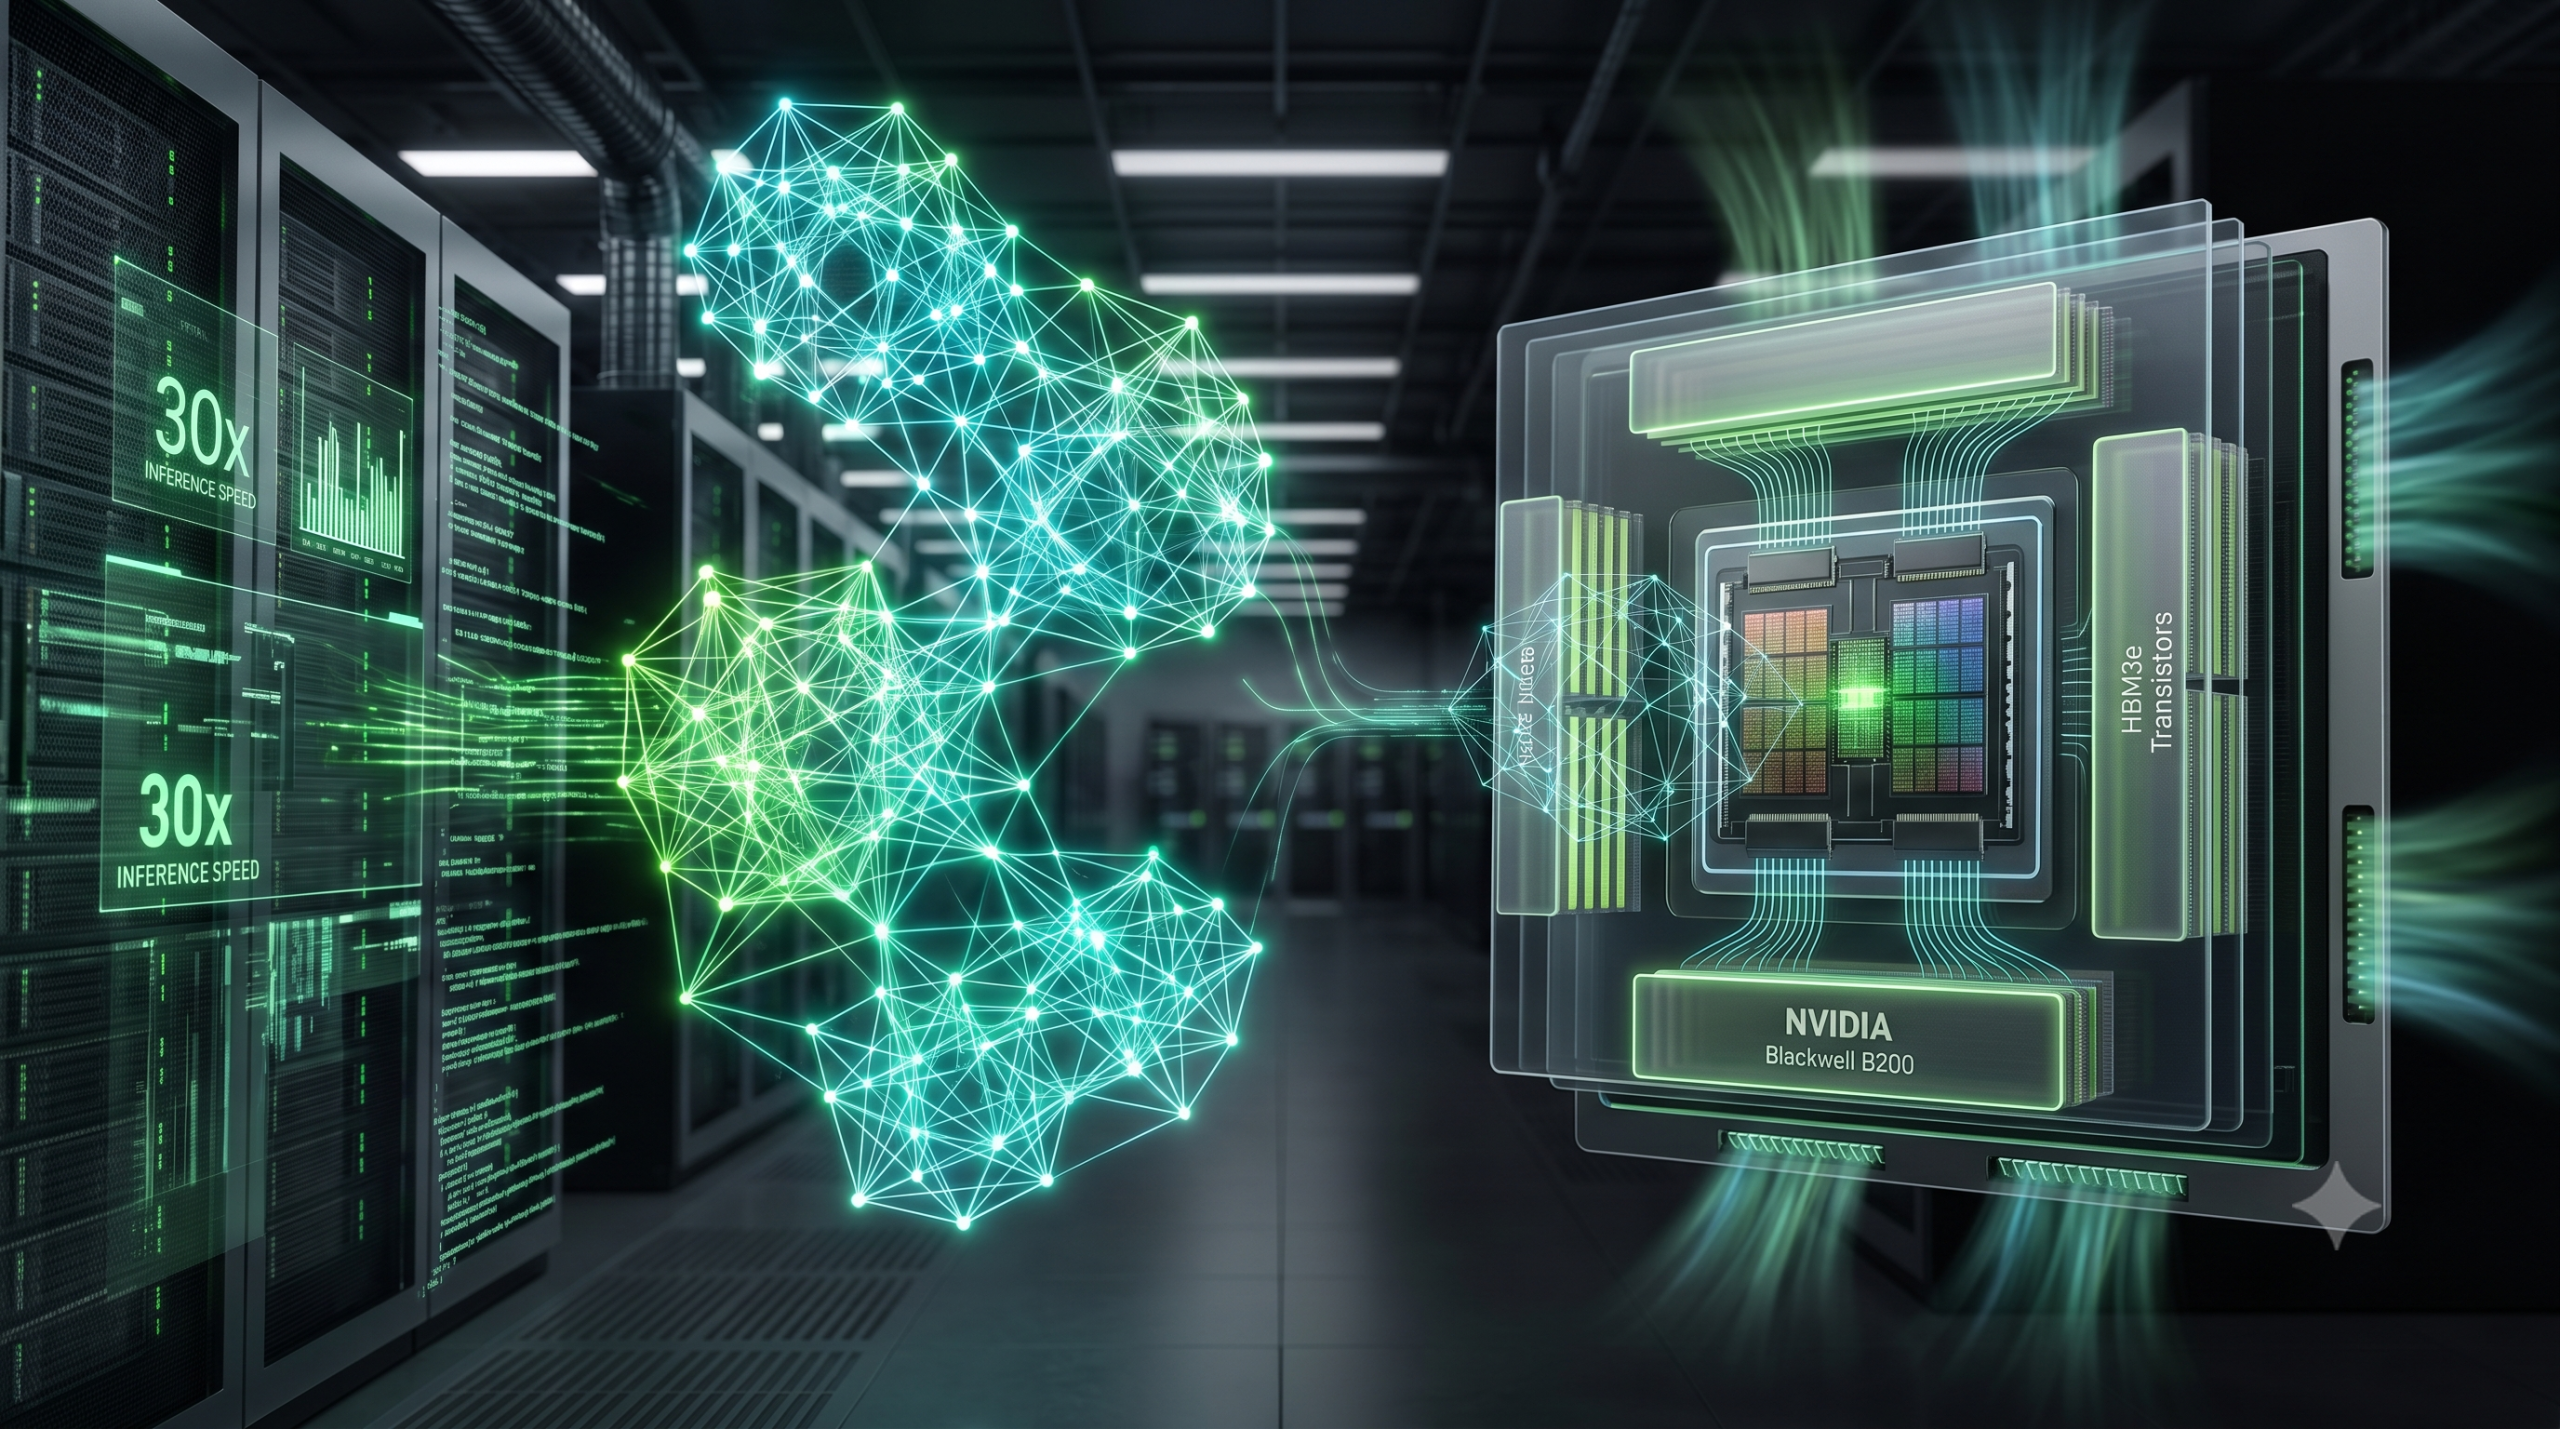
Admitámoslo: en el mundo de la inteligencia artificial, el tamaño sí importa. Específicamente, el tamaño de los modelos y la potencia bruta necesaria para entrenarlos. Hasta hace poco, estábamos atrapados en una especie de «cuello de botella del silicio», donde incluso los clusters de GPUs más avanzados empezaban a sudar frío ante la complejidad de los nuevos LLMs. El problema no era conceptual, sino puramente de hardware: necesitábamos más transistores, más memoria y, sobre todo, una forma más eficiente de mover esos trillones de parámetros sin que el centro de datos saliera ardiendo o la factura de la luz superara el PIB de un país pequeño.
(más…)
Aceptémoslo: todos hemos sentido esa punzada de frustración cuando nuestro plugin de IA favorito se queda colgado, nos devuelve un trozo de código que rompe el build o, peor aún, alucina con una librería que no existe desde 2018. Llevamos un par de años intentando encajar motores de inteligencia artificial hiperpotentes dentro de editores de texto tradicionales mediante parches, extensiones y APIs de terceros. Es como intentar meter el motor de un Tesla dentro de un Ford Fiesta de 1998: funciona a ratos, pero el chasis cruje por todas partes. Los desarrolladores pasamos más tiempo copiando, pegando y corrigiendo el contexto de las sugerencias que picando código real, convirtiendo la promesa de la productividad en un dolor de cabeza de dependencias.
El verdadero problema de fondo es arquitectónico. Los entornos de desarrollo integrados (IDEs) actuales nacieron en una era donde el teclado y el ser humano eran la única fuente de entrada de datos. Añadir una extensión que consulta un modelo de lenguaje (LLM) es un parche superficial. La IA no entiende la estructura semántica global de tu proyecto en tiempo real; solo lee pestañas abiertas o fragmentos sueltos. Esto provoca un desfase crítico: el desarrollador independiente que intenta levantar un microservicio o un simulador complejo en una tarde se encuentra con que el autocompletado rompe el tipado, pierde el hilo de las variables distribuidas o duplica funciones. Estamos usando herramientas del siglo pasado para gestionar la velocidad de computación del mañana.
(más…)